

Opracowanie statystyczne wyników badań – co obejmuje i jak wygląda
Opracowanie statystyczne wyników badań to droga od surowego pliku z danymi do raportu z wynikami: przygotowanie danych, eksploracja, analizy i raport z tabelami i rysunkami. Wykonujemy je dla studentów i badaczy – poniżej pokazujemy, co dokładnie obejmuje.
W skrócieOpracowanie statystyczne danych zaczynamy od ich uporządkowania i obejrzenia na wykresach, dopiero potem testujemy hipotezy. Dostajesz raport w stylu APA z tabelami, rysunkami i opisem do Twojej redakcji, a w projektach dla badaczy na życzenie także kod R. Studenci czekają zwykle 1–2 dni, badacze przeciętnie 5–10 dni.
Co obejmuje opracowanie statystyczne?
- Przygotowanie danych – import z Excela, CSV, SPSS albo Formularzy Google, braki danych, przekodowanie odpowiedzi, wskaźniki (np. suma skali z pozycjami odwróconymi).
- Eksploracja – statystyki opisowe, rozkłady, obserwacje odstające, wykresy.
- Analizy – dobór testów do hipotez i rodzaju danych, sprawdzenie założeń, testy z wielkością efektu, rzetelność skal, modele (np. regresja).
- Raport APA – opis metod i wyników, tabele i rysunki zgodne z wytycznymi APA (American Psychological Association, 2020).
- Kod R – pozwala odtworzyć każdy wynik, co przydaje się zwłaszcza przy publikacji.
Przykładowe raporty: eksploracja zbioru danych (PDF), opis próby i obserwacje odstające w porównaniach grup.
Dlaczego opracowanie zaczyna się od eksploracji?
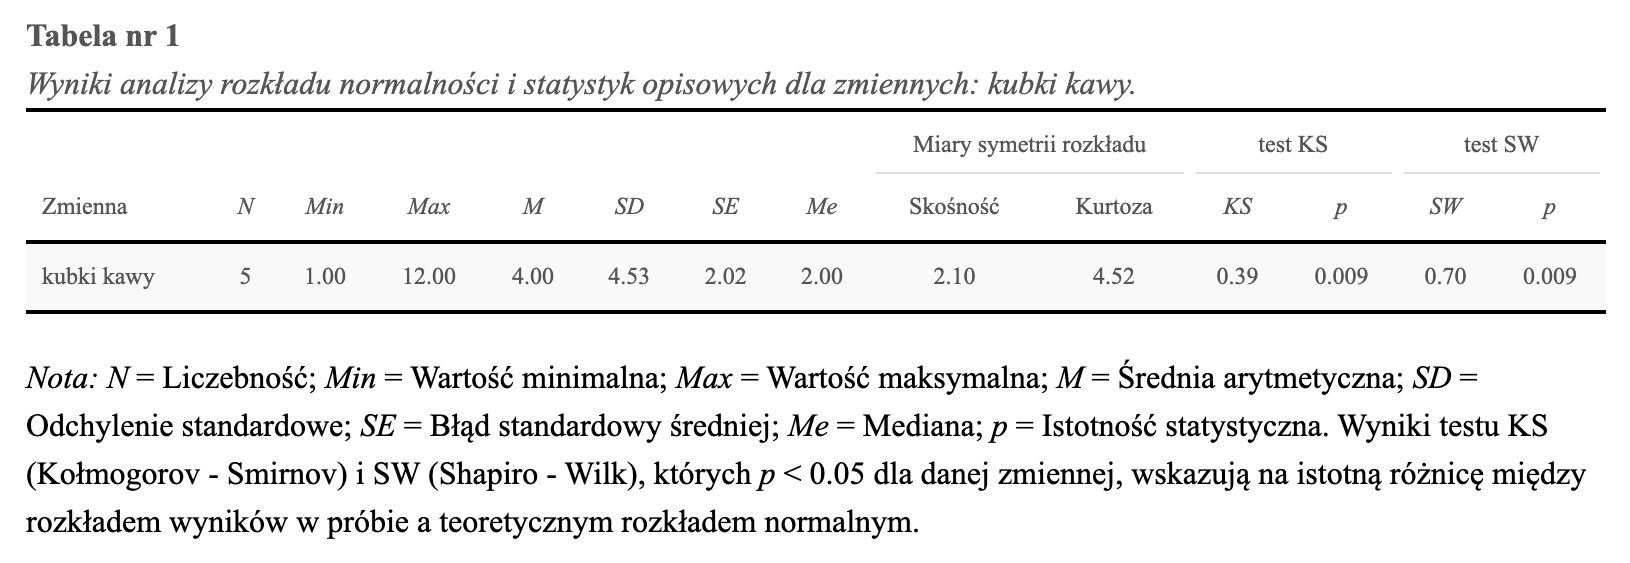
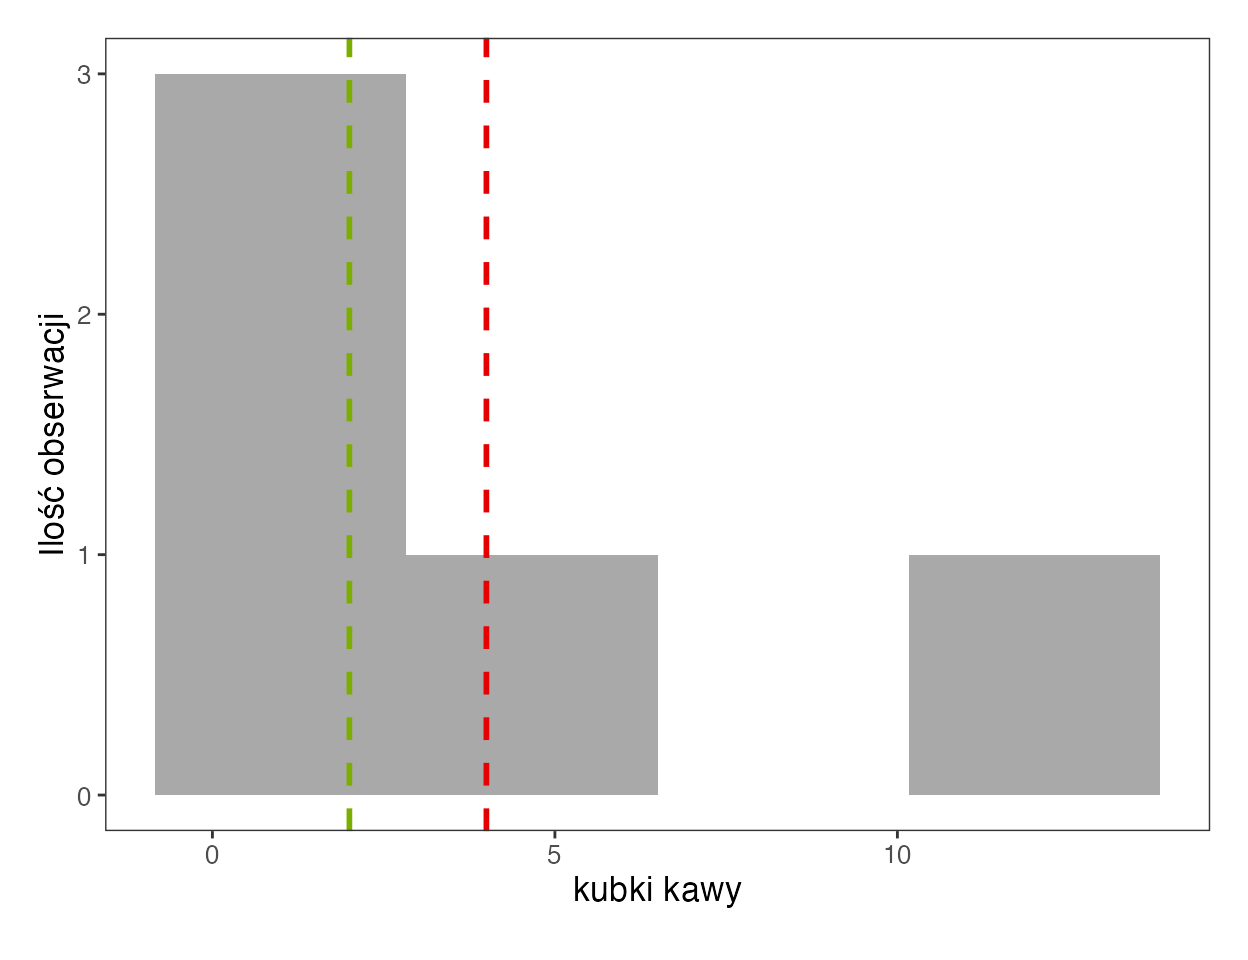
Pięcioro doktorantów zapisało, ile kubków kawy wypija dziennie: 1, 2, 2, 3 i 12. Średnia wynosi 4, ale typowa osoba pije 2 kubki – tyle wynosi mediana. Jedna osoba z wynikiem 12 podwaja średnią i ponad pięciokrotnie zwiększa odchylenie standardowe. Średnia jest wrażliwa na wartości skrajne, a mediana – nie (Field i in., 2012). Eksploracja wyłapuje też błędy wpisu (np. wiek 250 lat), braki danych i pytania, na które wszyscy odpowiedzieli tak samo.
kawa <- c(1, 2, 2, 3, 12)   # kubki kawy dziennie u pięciorga doktorantów

# 1) statystyki opisowe: średnia, mediana, odchylenie standardowe
round(c(M = mean(kawa), Me = median(kawa), SD = sd(kawa)), 2)

# 2) obserwacje odstające według reguły 1,5 × IQR (jak na wykresie pudełkowym)
boxplot.stats(kawa)$out

# 3) te same statystyki bez obserwacji odstającej
round(c(M = mean(kawa[-5]), SD = sd(kawa[-5])), 2)

# 4) kwartet Anscombe’a: cztery zbiory, prawie te same statystyki
round(sapply(1:4, function(i) {
  x <- anscombe[[i]]; y <- anscombe[[i + 4]]
  c(M_y = mean(y), SD_y = sd(y), r = cor(x, y), b = unname(coef(lm(y ~ x))[2]))
}), 2)
Wynik w konsoli R:
   M   Me   SD
4.00 2.00 4.53
[1] 12
   M   SD
2.00 0.82
     [,1] [,2] [,3] [,4]
M_y  7.50 7.50 7.50 7.50
SD_y 2.03 2.03 2.03 2.03
r    0.82 0.82 0.82 0.82
b    0.50 0.50 0.50 0.50
Bez osoby z wynikiem 12 średnia spada do 2, a odchylenie standardowe do 0,82. Nie znaczy to, że tę osobę trzeba usunąć. Najpierw sprawdzamy, czy to błąd wpisu, czy prawdziwy wynik, a decyzję opisujemy w raporcie – tak zalecają standardy raportowania (Appelbaum i in., 2018).
Tak opisujemy to w raporcie: Badani wypijali średnio 4,00 kubka kawy dziennie (SD = 4,53), jednak mediana wyniosła 2,00. Rozkład był prawostronnie skośny z powodu jednej obserwacji odstającej (12 kubków).
Druga lekcja to kwartet Anscombe’a (1973). Cztery zbiory mają po zaokrągleniu tę samą średnią y (7,50), odchylenie standardowe y (2,03), korelację (r = 0,82) i nachylenie prostej (0,50) – a wyglądają zupełnie inaczej.
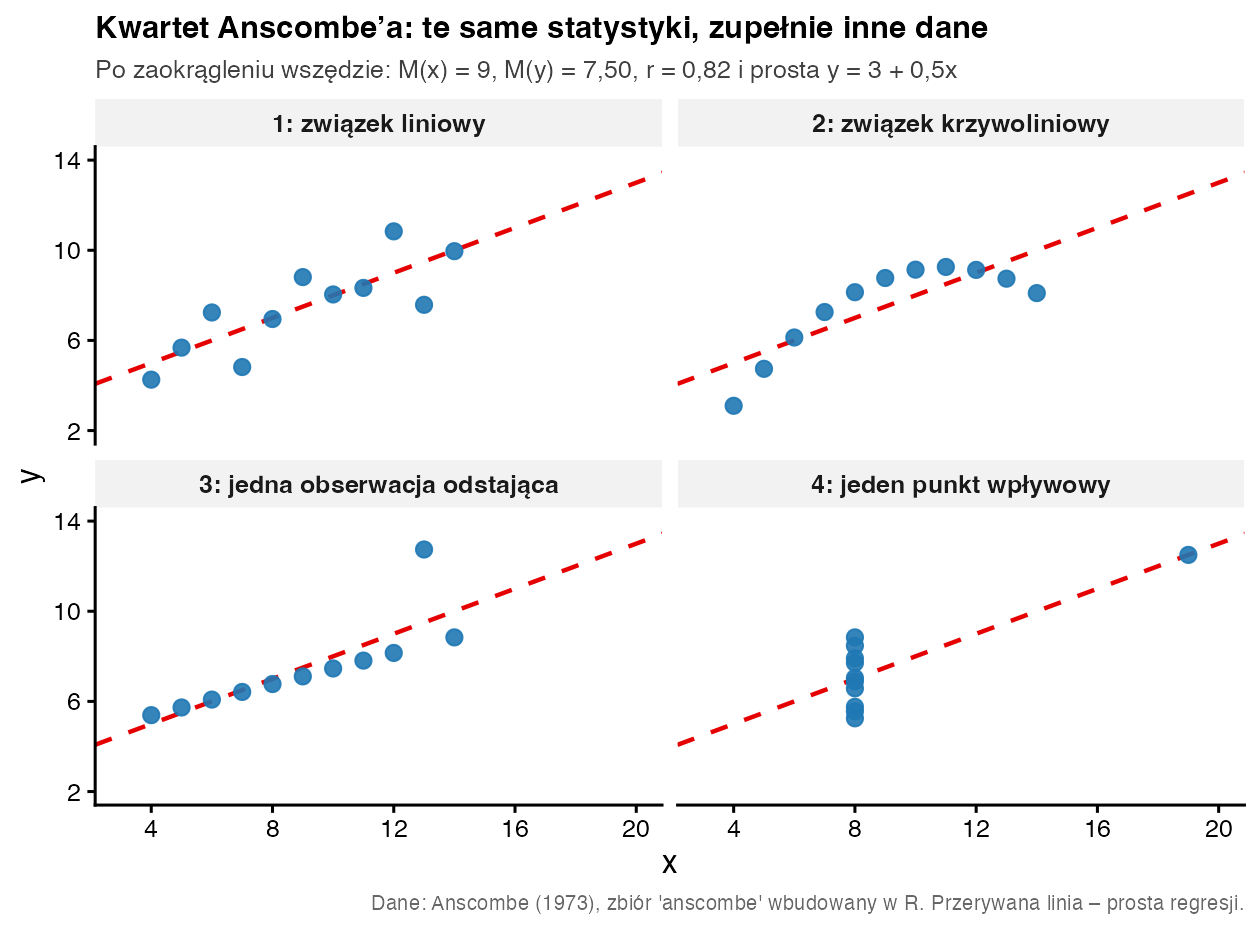
Dlatego w każdym opracowaniu oglądamy dane, zanim policzymy testy (Wilkinson i Task Force on Statistical Inference, 1999). Więcej o miarach z tego przykładu przeczytasz w hasłach mediana i odchylenie standardowe.
Terminy i ceny
Opracowanie dla studentów trwa zwykle 1–2 dni i kosztuje od 250 zł netto (połowa projektów poniżej 850 zł). Opracowanie do artykułu lub doktoratu trwa przeciętnie 5–10 dni i kosztuje od 750 zł netto. Poprawki po uwagach promotora lub recenzenta są w ustalonej cenie. Szczegóły: cena statystyki do pracy magisterskiej oraz oferta dla badaczy.
Najczęstsze pytania
Czym opracowanie danych statystycznych różni się od analizy statystycznej wyników badań?
Analiza statystyczna wyników to jeden etap – na przykład test hipotezy. Opracowanie obejmuje cały proces: od przygotowania danych po raport. Wybierz je, gdy masz surowe dane i potrzebujesz kompletnego raportu do własnej redakcji.
Co robicie z brakami danych i obserwacjami odstającymi?
Nie usuwamy ich po cichu. Sprawdzamy, ile ich jest i skąd się wzięły, wybieramy sposób postępowania i opisujemy go w raporcie, żeby promotor lub recenzent mógł go ocenić.
Czy dostanę kod R?
W projektach dla badaczy – tak, na życzenie. Kod pozwala odtworzyć każdą liczbę z raportu, co ma znaczenie przy publikacji i pytaniach recenzentów. Studenci dostają raport z tabelami, rysunkami i omówieniem wyników.
Czy opracowujecie wyniki ankiet?
Tak – od importu z Formularzy Google po tabele częstości i rzetelność skal. Szczegóły opisujemy na stronie opracowanie wyników ankiety.
Czy opracowanie statystyczne pracy magisterskiej to napisany rozdział?
Nie. Policzymy wyniki i przygotujemy opis, który dopracujesz w swojej pracy. Autorem pracy zostajesz Ty.
Bibliografia
- Anscombe, F. J. (1973). Graphs in statistical analysis. The American Statistician, 27(1), 17–21. https://doi.org/10.1080/00031305.1973.10478966
- Wilkinson, L., & Task Force on Statistical Inference. (1999). Statistical methods in psychology journals: Guidelines and explanations. American Psychologist, 54(8), 594–604. https://doi.org/10.1037/0003-066X.54.8.594
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). https://doi.org/10.1037/0000165-000
- Appelbaum, M., Cooper, H., Kline, R. B., Mayo-Wilson, E., Nezu, A. M., & Rao, S. M. (2018). Journal article reporting standards for quantitative research in psychology: The APA Publications and Communications Board task force report. American Psychologist, 73(1), 3–25. https://doi.org/10.1037/amp0000191
- Field, A., Miles, J., & Field, Z. (2012). Discovering statistics using R. SAGE.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- PoradnikStatystyka do pracy magisterskiej – cena
- PoradnikIle kosztuje pomoc przy pracy magisterskiej
- PoradnikPomoc ze statystyki i konsultacje
- PoradnikAnaliza statystyczna w pracy magisterskiej krok po kroku
- PoradnikOpracowanie wyników ankiety
- Przykładowy raportOpis próby
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.