

Mediana – wzór, przykład i porównanie ze średnią
Mediana to wynik środkowy: połowa osób ma wynik nie wyższy od niej, a połowa – nie niższy. Typowe pytanie z pracy dyplomowej: ile kubków kawy tygodniowo wypija „typowy” student w sesji, skoro jedna osoba pije ich 21?
W prostych słowachUstaw wszystkich studentów w kolejce od najmniejszego do największego wyniku i sprawdź, kto stoi w środku. Jego wynik to mediana. Skrajne wyniki na końcach kolejki nie zmieniają tego, kto stoi pośrodku. Dlatego mediana jest odporna na wartości odstające.
Kiedy stosować medianę?
- zmienna jest co najmniej porządkowa: ocena zajęć 1–5, wykształcenie;
- rozkład jest skośny albo są w nim wartości odstające: dochody, czas dojazdu, liczba wypitych kaw;
- próba jest mała i jeden nietypowy wynik mógłby „przeciągnąć” średnią.
Medianę zwykle raportuje się razem z rozstępem międzykwartylowym – zobacz hasło o kwartylach i IQR. Dla danych symetrycznych bez wartości odstających lepsza będzie średnia arytmetyczna, a dla zmiennych nominalnych – moda. O tym, czy rozkład jest skośny, powie Ci współczynnik skośności.
Wzór na medianę
- \(Me\)
- mediana (w anglojęzycznym stylu APA: Mdn)
- \(x_{(k)}\)
- wynik stojący na k-tym miejscu po uporządkowaniu od najmniejszego do największego; \(x_{(3)}\) to trzeci wynik w kolejce, a nie wynik trzeciej osoby w arkuszu
- \(n\)
- liczba wyników (bez braków danych)
- \(\frac{n+1}{2}\)
- numer miejsca środkowego wyniku, gdy n jest nieparzyste
Przykład krok po kroku
Zaczynamy od tych samych wyników snu co w haśle o średniej: 6, 2, 7, 4, 6 godzin. Potem dokładamy szóstą osobę i sprawdzamy dane o kawie.
| Pozycja | 1 | 2 | 3 | 4 | 5 | 6 | 7 |
|---|---|---|---|---|---|---|---|
| Sen, n = 5 | 2 | 4 | 6 | 6 | 7 | – | – |
| Sen, n = 6 | 2 | 3 | 4 | 6 | 6 | 7 | – |
| Kawa, n = 7 | 1 | 2 | 2 | 4 | 6 | 6 | 21 |
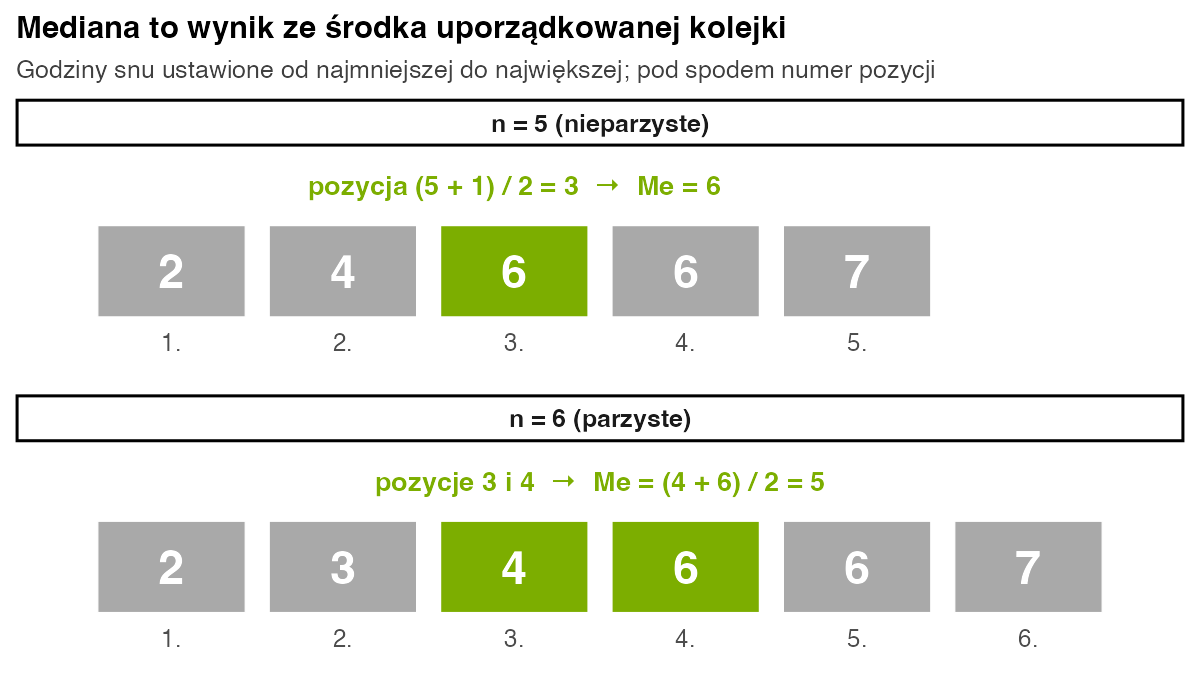
- Uporządkuj wyniki. 6, 2, 7, 4, 6 → 2, 4, 6, 6, 7.
- n nieparzyste. n = 5, więc środek to pozycja (5 + 1) / 2 = 3. Me = 6 godzin. Średnia wynosi 5 – jest niższa, bo w dół ciągnie ją osoba, która spała 2 godziny.
- n parzyste. Szósta osoba spała 3 godziny: 2, 3, 4, 6, 6, 7. Środek wypada między pozycjami 3 i 4, więc Me = (4 + 6) / 2 = 5 godzin.
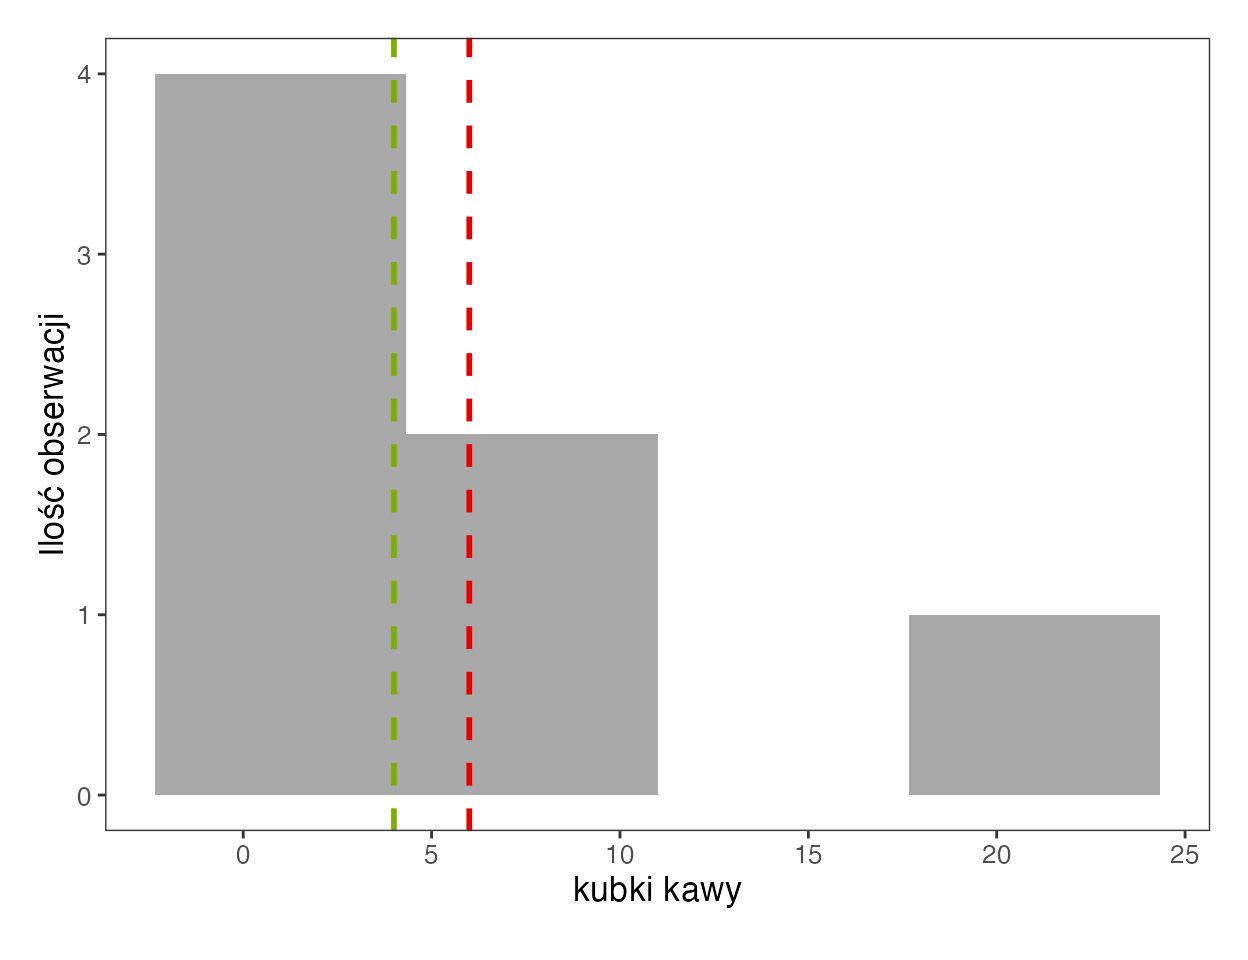
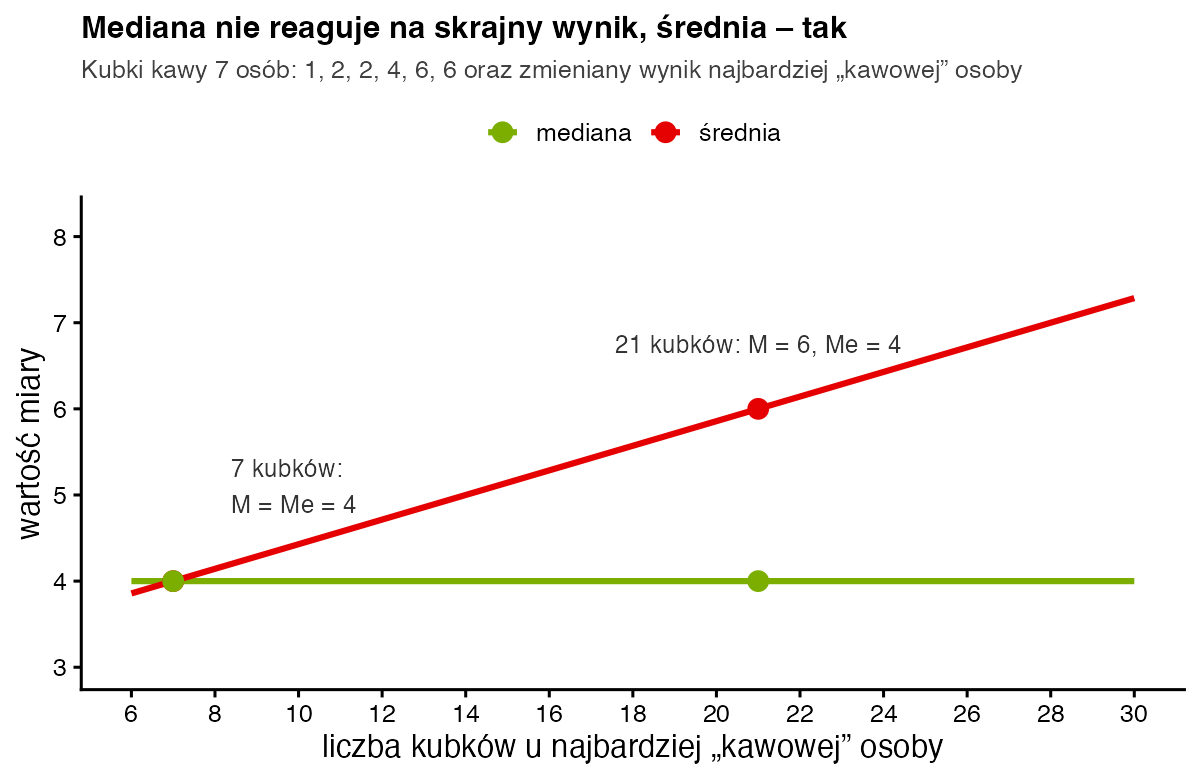
- Wartość odstająca. Siedmioro studentów pije w tygodniu sesji 1, 2, 2, 4, 6, 6 i 21 kubków kawy. Środek to pozycja 4, więc Me = 4 kubki. Średnia wynosi 42 / 7 = 6 kubków, bo w górę ciągnie ją jedna osoba.
- Test odporności. Gdyby ostatnia osoba piła 7 kubków zamiast 21, mediana nadal wynosiłaby 4, a średnia spadłaby do 28 / 7 = 4.
Jak zinterpretować i opisać wynik?
Połowa studentów pije w tygodniu sesji nie więcej niż 4 kubki kawy, a połowa – co najmniej 4. Mediana lepiej opisuje tu „typowego” studenta niż średnia, bo jest mało wrażliwa na wartości odstające (Leys i in., 2013). Podaj ją razem z rozstępem międzykwartylowym: Q1 = 2, Q3 = 6, więc IQR = 4. Nie łącz mediany z odchyleniem standardowym, bo SD tak samo mocno reaguje na skrajne wyniki jak średnia.
Zapis w stylu APA: Studenci wypijali w tygodniu sesji od 1 do 21 kubków kawy (Me = 4; IQR = 4). Rozkład był prawostronnie skośny – średnia (M = 6,00) przewyższała medianę.
Jak policzyć medianę w R?
sen  <- c(6, 2, 7, 4, 6)
kawa <- c(1, 2, 2, 4, 6, 6, 21)

# 1) „ręcznie”: sortowanie i środkowa pozycja (n nieparzyste)
x <- sort(sen); n <- length(x)
x                                     # 2 4 6 6 7
x[(n + 1) / 2]                        # 3. pozycja: 6

# 2) gotową funkcją
median(sen)
median(c(sen, 3))                     # n = 6: (4 + 6) / 2 = 5

# 3) mediana a średnia przy wartości odstającej
c(srednia = mean(kawa), mediana = median(kawa))
quantile(kawa, c(0.25, 0.5, 0.75))    # Q1, mediana, Q3
Wynik w konsoli R:
[1] 2 4 6 6 7
[1] 6
[1] 6
[1] 5
srednia mediana
      6       4
25% 50% 75%
  2   4   6
Funkcja quantile() domyślnie liczy kwartyle inną metodą niż SPSS. Dla danych o kawie wynik jest ten sam, ale w innych zbiorach Q1 i Q3 mogą się różnić.
Czy test U Manna-Whitneya porównuje mediany?
Nie do końca, choć tak często się pisze. Test U sprawdza, czy wyniki jednej grupy bywają zwykle wyższe niż wyniki drugiej. O różnicy median można mówić tylko wtedy, gdy rozkłady w obu grupach mają podobny kształt (Divine i in., 2018). Mediany grup podawaj jako opis danych, ale wynik testu formułuj ostrożnie: „wyniki w grupie A były zwykle wyższe”, a nie „mediana w grupie A była istotnie wyższa”. Więcej w haśle o teście U Manna-Whitneya.
Najczęstsze błędy
- Szukanie środka w nieposortowanych danych: w arkuszu 6, 2, 7, 4, 6 „środkowa” liczba to 7, a mediana to 6.
- Wybieranie jednej z dwóch środkowych wartości przy parzystym n zamiast ich średniej.
- Mylenie mediany ze środkiem zakresu (min + max) / 2 – dla danych o kawie to 11, a mediana wynosi 4.
- Podawanie mediany z odchyleniem standardowym zamiast z IQR.
- Liczenie mediany dla zmiennej nominalnej, np. kierunku studiów – tu sens ma tylko moda.
Bibliografia
- Manikandan, S. (2011). Measures of central tendency: Median and mode. Journal of Pharmacology and Pharmacotherapeutics, 2(3), 214–215.
- Leys, C., Ley, C., Klein, O., Bernard, P., & Licata, L. (2013). Detecting outliers: Do not use standard deviation around the mean, use absolute deviation around the median. Journal of Experimental Social Psychology, 49(4), 764–766. https://doi.org/10.1016/j.jesp.2013.03.013
- Divine, G. W., Norton, H. J., Barón, A. E., & Juarez-Colunga, E. (2018). The Wilcoxon–Mann–Whitney procedure fails as a test of medians. The American Statistician, 72(3), 278–286. https://doi.org/10.1080/00031305.2017.1305291
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówŚrednia arytmetyczna
- Słownik wzorówKwartyle i rozstęp międzykwartylowy
- Słownik wzorówModa (dominanta)
- Słownik wzorówTest U Manna-Whitneya
- PoradnikStatystyka opisowa – przykład
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
- Przykładowy raportOpis próby
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.