

Analiza statystyczna w pracy magisterskiej – krok po kroku
Analiza statystyczna w pracy magisterskiej to zaplanowana droga od hipotez, przez dobór testu, do rozdziału wyników, który obronisz przed komisją. Typowe pytanie z pracy dyplomowej: jaki test wybrać i co napisać, gdy wynik nie wyszedł istotny?
W prostych słowachNajpierw decydujesz, co i czym sprawdzisz, potem zbierasz dane, a na końcu liczysz dokładnie to, co zaplanowałeś. Do każdego testu dodajesz wielkość efektu, bo samo p nie mówi, czy różnica jest duża. Wynik nieistotny opisujesz tak samo uczciwie jak istotny.
Badania do pracy magisterskiej: od hipotez do planu analiz
Zanim otworzysz program, zapisz hipotezy i plan analiz – najlepiej jeszcze przed zebraniem danych. Plan chroni przed szukaniem istotności, czyli testowaniem wszystkiego tak długo, aż coś wyjdzie (Simmons i in., 2011). Jak sformułować hipotezę, przeczytasz w poradniku jak postawić hipotezę badawczą. Poniżej plan dla naszej mini-ankiety „Stres przed sesją”: 8 studentów, skala stresu (średnia czterech pytań 1–5), godziny snu i kierunek studiów.
| Hipoteza | Zmienne | Test | Wielkość efektu | Gdy założenia nie są spełnione |
|---|---|---|---|---|
| H1: dłuższy sen wiąże się z mniejszym stresem | sen i stres – obie ilościowe | korelacja Pearsona | r i 95% CI | korelacja Spearmana |
| H2: studenci psychologii i ekonomii różnią się poziomem stresu | kierunek (2 grupy różnych osób) i stres | test t Studenta | d Cohena | test t Welcha lub U Manna-Whitneya |
Obliczenia statystyczne do pracy magisterskiej krok po kroku
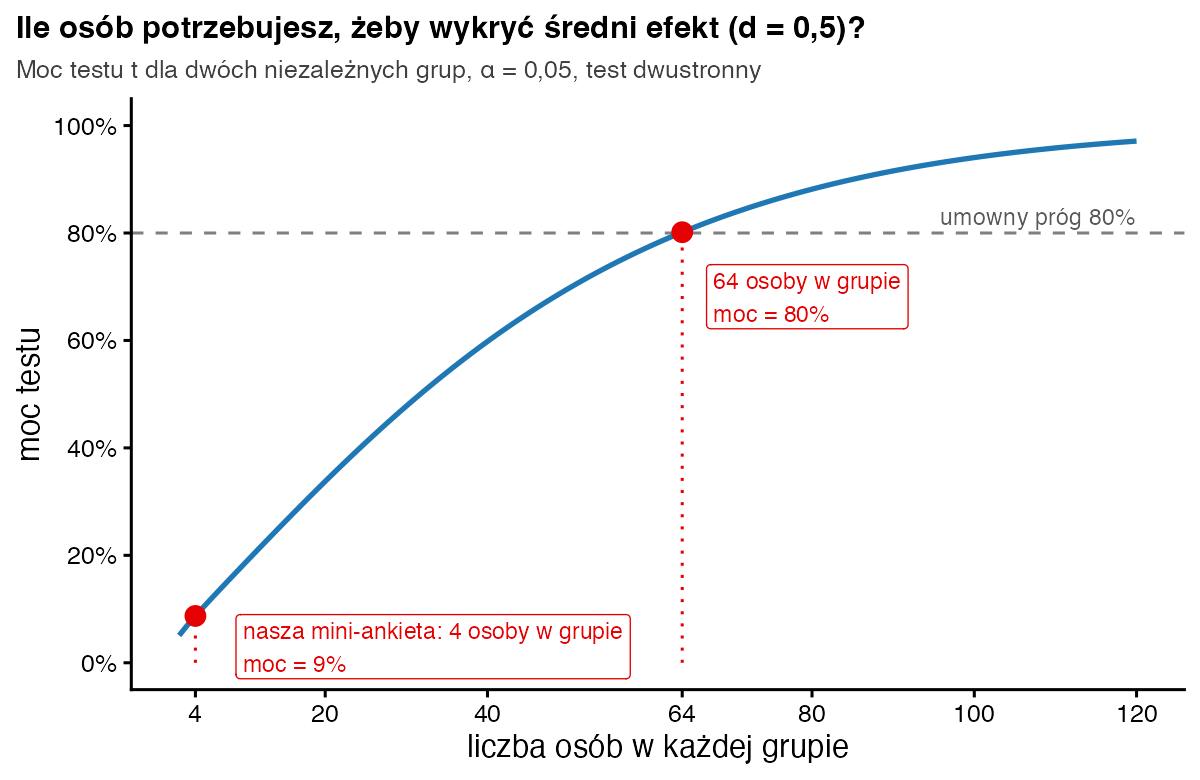
- Liczebność próby. Zaplanuj ją przed badaniem analizą mocy. Do wykrycia średniego efektu (d = 0,5) testem t z mocą 80% potrzeba 64 osób w każdej grupie (Cohen, 1992). Nasze 4 osoby w grupie to tylko ilustracja (Rys. 2). Gdy nie masz wpływu na liczebność, np. badasz małą grupę pacjentów, napisz o tym wprost w ograniczeniach.
- Przygotowanie danych. Czyszczenie, braki danych, odwrócenie pytań i wyniki skal opisujemy w poradniku jak opracować wyniki ankiety.
- Statystyki opisowe i założenia. Obejrzyj rozkład w każdej grupie na wykresie i sprawdź go testem Shapiro-Wilka, a podobieństwo wariancji – testem Levene’a. U nas p = 0,995 w obu grupach i p = 1,000 w teście Levene’a. Pamiętaj jednak, że przy 4 osobach w grupie testy założeń prawie niczego nie wykryją.
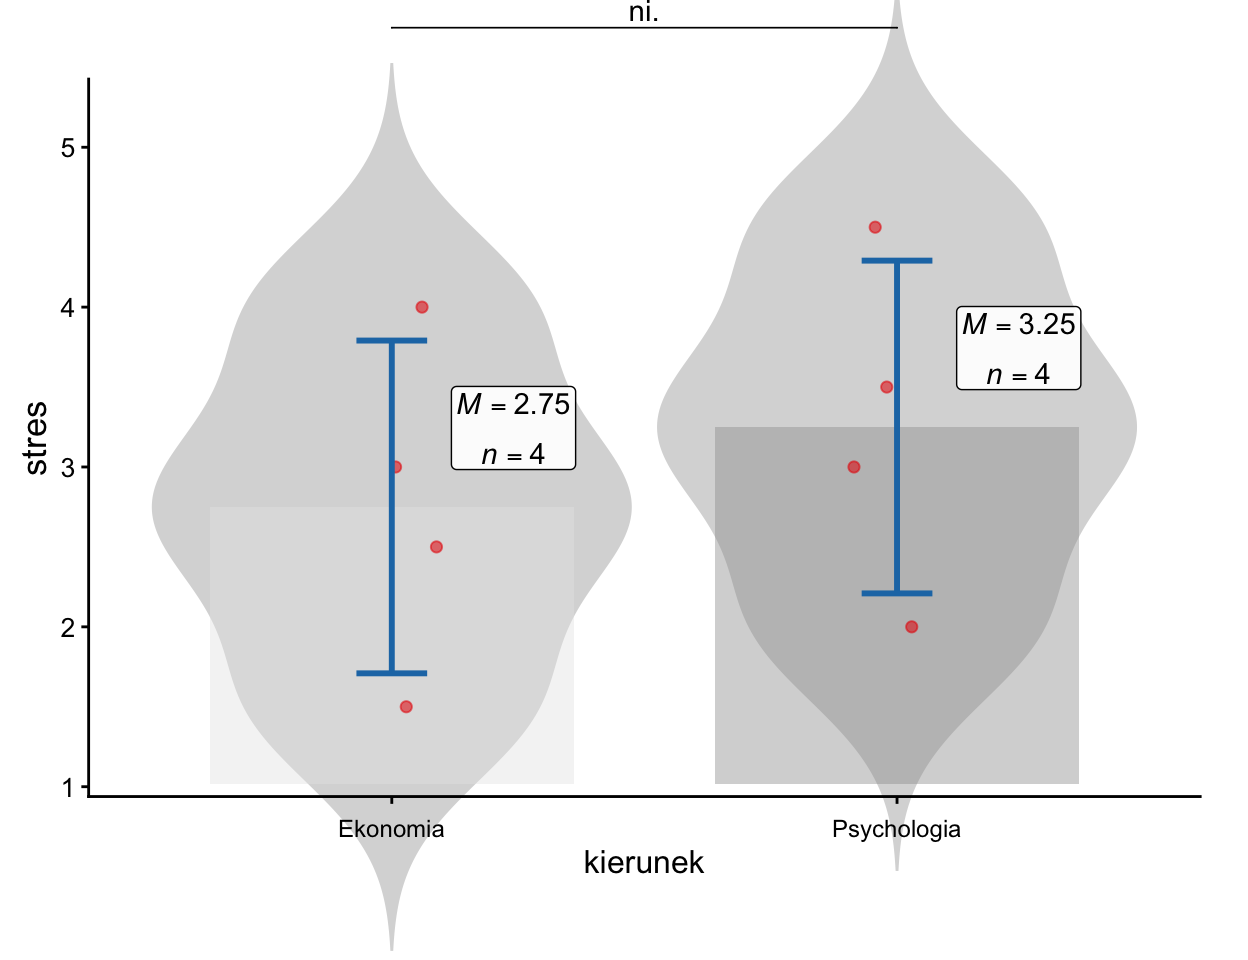
- Test i wielkość efektu. H1: r(6) = −0,87; 95% CI [−0,98; −0,44]; p = 0,005 – silny związek ujemny. H2: t(6) = 0,68; p = 0,522; d Cohena = 0,48 z 95% CI od −0,95 do 1,87 – brak podstaw do odrzucenia H0.
- Raport w stylu APA. Każdy wynik zapisz ze statystyką, stopniami swobody, p i wielkością efektu. Wzory zdań i tabel znajdziesz w poradniku jak opisać wyniki ankiety w pracy magisterskiej.
- Przygotowanie do obrony. Dla każdej hipotezy umiej powiedzieć jednym zdaniem: co sprawdzałeś, jakim testem, dlaczego tym i co wyszło.
Jak dobrać test statystyczny do hipotezy?
O wyborze decydują trzy pytania: czy porównujesz grupy, czy szukasz związku; ile masz grup; czy to te same osoby, czy różne. Rodzaj zmiennej i założenia rozstrzygają między testem parametrycznym a jego zamiennikiem. Pełne tabele decyzyjne znajdziesz we wpisach o testach parametrycznych i testach nieparametrycznych.
| Sytuacja | Test parametryczny | Gdy założenia nie są spełnione |
|---|---|---|
| dwie grupy różnych osób | test t dla prób niezależnych | test U Manna-Whitneya |
| te same osoby zbadane dwa razy | test t dla prób zależnych | test Wilcoxona |
| trzy grupy lub więcej | jednoczynnikowa ANOVA | test Kruskala-Wallisa |
| dwie zmienne ilościowe | korelacja Pearsona | korelacja Spearmana |
| dwie zmienne kategorialne | test chi-kwadrat (przy małych liczebnościach – dokładny test Fishera) | |
Swoje wybory opisz w rozdziale metodologicznym: program (np. R, SPSS albo SZTOS), przyjęty poziom istotności α = 0,05, test dla każdej hipotezy i powód jego wyboru oraz sposób potraktowania braków danych. Recenzent zobaczy wtedy, że decyzje zapadły przed obliczeniami, a nie po nich.
Jak policzyć analizę w R?
# Mini-ankieta „Stres przed sesją” po opracowaniu: kierunek, wynik skali stresu (1–5), godziny snu
ankieta <- data.frame(
  kierunek = factor(rep(c("Psychologia", "Ekonomia"), 4), levels = c("Psychologia", "Ekonomia")),
  stres = c(4.5, 1.5, 3.5, 2.5, 3.0, 4.0, 2.0, 3.0),
  sen = c(4, 8, 5, 7, 6, 6, 7, 5))

# Założenia: normalność w każdej grupie (Shapiro-Wilk) i równość wariancji (Levene)
round(tapply(ankieta$stres, ankieta$kierunek, function(x) shapiro.test(x)$p.value), 3)
car::leveneTest(stres ~ kierunek, data = ankieta)

# H1: im więcej snu, tym mniejszy stres – korelacja Pearsona
cor.test(ankieta$stres, ankieta$sen)

# H2: psychologia i ekonomia różnią się stresem – test t Studenta i d Cohena
h2 <- t.test(stres ~ kierunek, data = ankieta, var.equal = TRUE)
round(c(t = unname(h2$statistic), df = unname(h2$parameter), p = h2$p.value), 3)
effectsize::cohens_d(stres ~ kierunek, data = ankieta)

# Plan liczebności: ilu osób w grupie trzeba, by wykryć d = 0,5 z mocą 80%?
ceiling(power.t.test(delta = 0.5, sd = 1, power = 0.8)$n)
Wynik w konsoli R:
Psychologia    Ekonomia
      0.995       0.995
Levene's Test for Homogeneity of Variance (center = median)
      Df F value Pr(>F)
group  1       0      1
       6

	Pearson's product-moment correlation

data:  ankieta$stres and ankieta$sen
t = -4.3818, df = 6, p-value = 0.004659
alternative hypothesis: true correlation is not equal to 0
95 percent confidence interval:
 -0.9767539 -0.4369805
sample estimates:
       cor
-0.8728716

    t    df     p
0.679 6.000 0.522
Cohen's d |        95% CI
-------------------------
0.48      | [-0.95, 1.87]

- Estimated using pooled SD.
[1] 64
Statystyka do pracy magisterskiej – pytania na obronie
Statystyki do pracy magisterskiej nie wystarczy policzyć – trzeba je jeszcze obronić. Te pytania promotorzy i recenzenci zadają najczęściej.
„Dlaczego Pearson, a nie Spearman?” Wynik skali to średnia czterech pozycji, a rozkłady nie odbiegały wyraźnie od normalnego. Spearman dał zresztą prawie to samo (ρ = −0,87).
„Czyli kierunek studiów nie ma znaczenia?” Tego nie wiemy. d = 0,48 to efekt bliski średniemu, a przedział ufności obejmuje i zero, i duże wartości. To brak rozstrzygnięcia, a nie dowód braku różnicy.
„Czy sen zmniejsza stres?” Ankieta zebrana w jednym momencie pokazuje związek, a nie przyczynę. Równie dobrze stres może skracać sen.
„Ile testów wykonano?” Tyle, ile zaplanowano: dwa, po jednym na hipotezę. Gdy testów jest wiele, trzeba skorygować poziom istotności, np. poprawką Bonferroniego. Gdy chcesz skonsultować obliczenia ze statystykiem, zobacz, jak wygląda opracowanie wyników ankiety z naszą pomocą.
Najczęstsze błędy
- Wybieranie testu dopiero po sprawdzeniu, który daje „lepsze” p.
- Pisanie „przyjęto H0” zamiast „brak podstaw do odrzucenia H0”.
- Test dla prób niezależnych, gdy te same osoby zbadano dwa razy.
- Sprawdzanie normalności na całej próbie zamiast w każdej grupie osobno.
- Podawanie samego p bez wielkości efektu i przedziału ufności (Wasserstein i Lazar, 2016).
Bibliografia
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). https://doi.org/10.1037/0000165-000
- Cohen, J. (1992). A power primer. Psychological Bulletin, 112(1), 155–159. https://doi.org/10.1037/0033-2909.112.1.155
- Simmons, J. P., Nelson, L. D., & Simonsohn, U. (2011). False-positive psychology: Undisclosed flexibility in data collection and analysis allows presenting anything as significant. Psychological Science, 22(11), 1359–1366. https://doi.org/10.1177/0956797611417632
- Wasserstein, R. L., & Lazar, N. A. (2016). The ASA statement on p-values: Context, process, and purpose. The American Statistician, 70(2), 129–133. https://doi.org/10.1080/00031305.2016.1154108
- Field, A., Miles, J., & Field, Z. (2012). Discovering statistics using R. SAGE.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- PoradnikWeryfikacja hipotez w pracy magisterskiej
- PoradnikJak postawić hipotezę badawczą
- PoradnikDyskusja wyników w pracy magisterskiej
- Słownik wzorówIstotność statystyczna i wartość p
- Słownik wzorówd Cohena – wielkość efektu
- Przykładowy raportCase study: praca magisterska z psychologii w SZTOS
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.