

Odchylenie standardowe – wzór, przykład i interpretacja
Odchylenie standardowe (SD) mówi, jak bardzo wyniki rozrzucają się wokół średniej – o ile typowo różnią się od niej w jednostkach pomiaru. Typowe pytanie z pracy dyplomowej: czy studenci śpią przed kolokwium podobnie długo, czy jedni prawie wcale, a inni normalnie?
W prostych słowachŚrednia mówi, gdzie leży środek wyników, a odchylenie standardowe – jak daleko od tego środka zwykle się one znajdują. Małe SD oznacza, że wszyscy mają podobne wyniki. Duże SD oznacza duże różnice między ludźmi. SD jest w tych samych jednostkach co dane, więc „SD = 2” przy godzinach snu znaczy po prostu „około 2 godzin”.
Kiedy stosować odchylenie standardowe?
- zmienna jest ilościowa, a Ty podajesz jej średnią – SD to jej stały towarzysz;
- rozkład jest w miarę symetryczny; przy silnie skośnym lepiej opisać rozrzut rozstępem międzykwartylowym;
- potrzebujesz SD do dalszych obliczeń: błędu standardowego, standaryzacji albo d Cohena.
Na tej stronie liczymy SD z próby (dzielenie przez n − 1). Tej wersji używasz prawie zawsze w pracy dyplomowej, bo badasz część studentów, a wnioski chcesz odnieść do wszystkich.
Wzór na odchylenie standardowe
- \(s\)
- odchylenie standardowe z próby; w stylu APA oznaczasz je SD
- \(s^2\)
- wariancja, czyli SD do kwadratu; jest w jednostkach „do kwadratu” (godziny²), dlatego trudno ją interpretować
- \(x_i\)
- wynik i-tej osoby
- \(\bar{x}\)
- średnia arytmetyczna wszystkich wyników
- \(x_i - \bar{x}\)
- odchylenie wyniku od średniej
- \(n - 1\)
- liczba osób minus jeden (stopnie swobody, tzw. poprawka Bessela)
Przykład krok po kroku
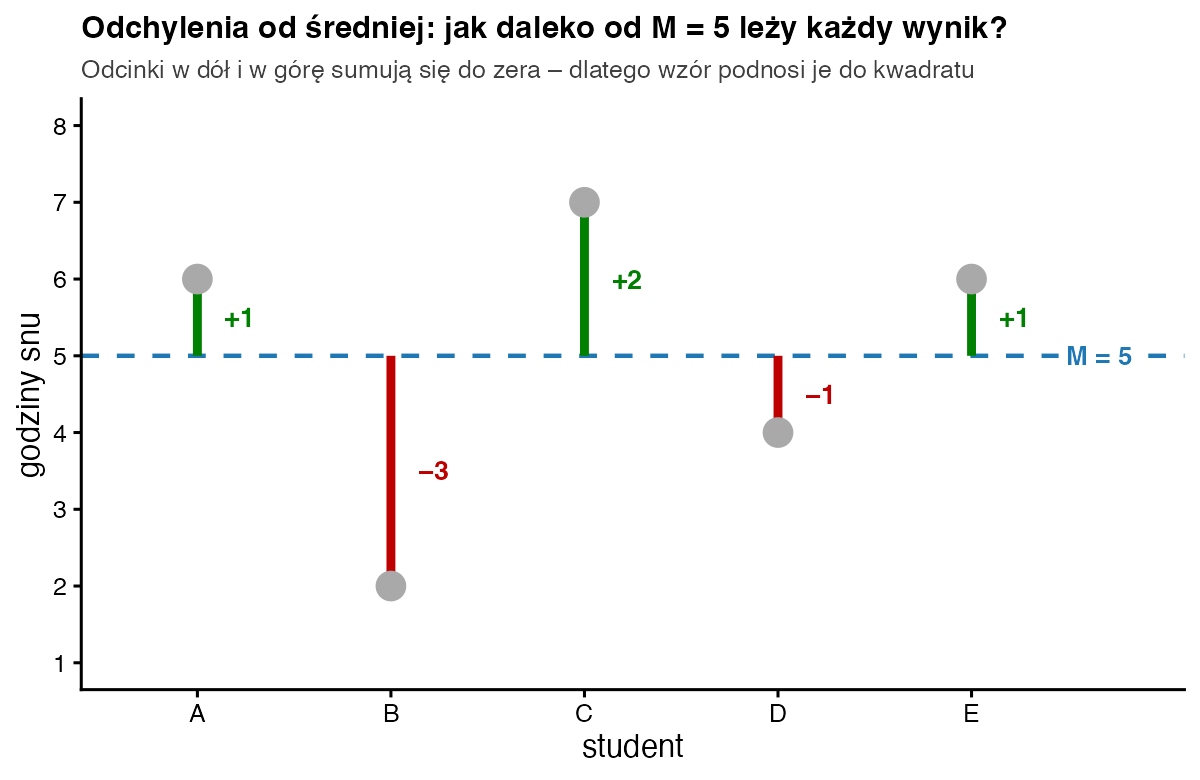
Te same godziny snu przed kolokwium co w haśle o średniej: 6, 2, 7, 4, 6. Średnia wynosi 5 godzin.
| Student | x | x − 5 | (x − 5)² |
|---|---|---|---|
| A | 6 | 1 | 1 |
| B | 2 | −3 | 9 |
| C | 7 | 2 | 4 |
| D | 4 | −1 | 1 |
| E | 6 | 1 | 1 |
| n = 5 | Σ = 25 | 0 | 16 |
- Średnia. M = 25 / 5 = 5 godzin.
- Odchylenia. Odejmij średnią od każdego wyniku: 1, −3, 2, −1, 1. Ich suma zawsze wynosi 0, więc samo uśrednienie odchyleń nic nie da.
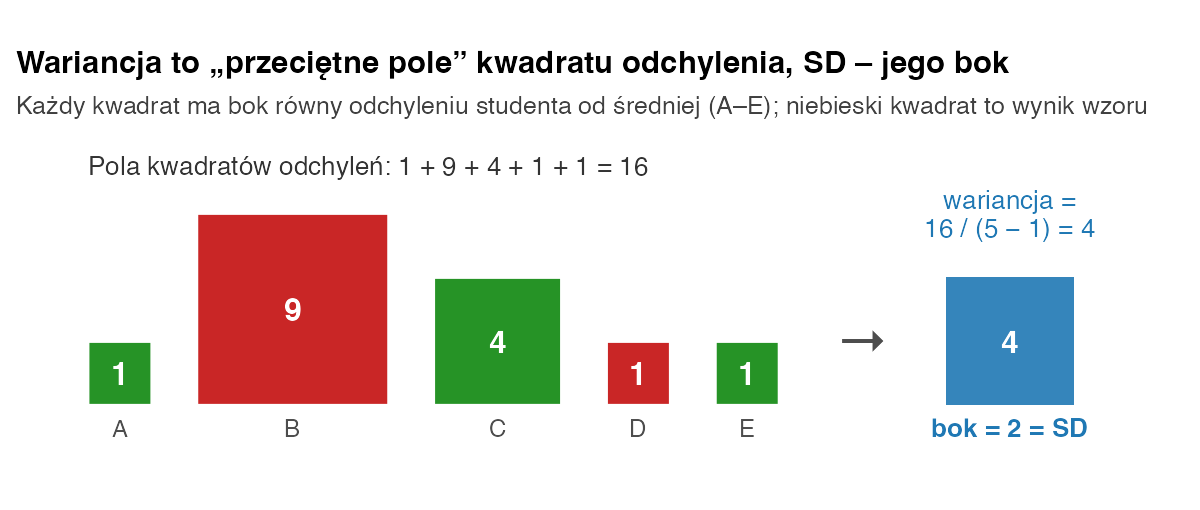
- Kwadraty. Podnieś odchylenia do kwadratu: 1, 9, 4, 1, 1. Suma kwadratów = 16.
- Wariancja. s² = 16 / (5 − 1) = 4.
- Odchylenie standardowe. s = √4 = 2 godziny.
Dlaczego dzielimy przez n − 1? Średnią policzyliśmy z tych samych pięciu wyników, więc leży ona możliwie najbliżej właśnie tych danych. Przez to odchylenia od niej są przeciętnie trochę mniejsze niż odchylenia od prawdziwej średniej wszystkich studentów. Dzielenie przez n − 1 wyrównuje to niedoszacowanie. Gdy dane obejmują całą populację, dzielisz przez N i dostajesz σ = 1,79 – zobacz hasło o odchyleniu standardowym populacji.
Jak zinterpretować i opisać wynik?
Sen studenta różni się od średniej typowo o około 2 godziny. Gdy rozkład jest zbliżony do normalnego, w przedziale M ± 1 SD mieści się około 68% wyników, a w przedziale M ± 2 SD – około 95%. Tutaj przedział od 3 do 7 godzin obejmuje cztery z pięciu osób. Przy tak małej próbie ta reguła działa tylko orientacyjnie.
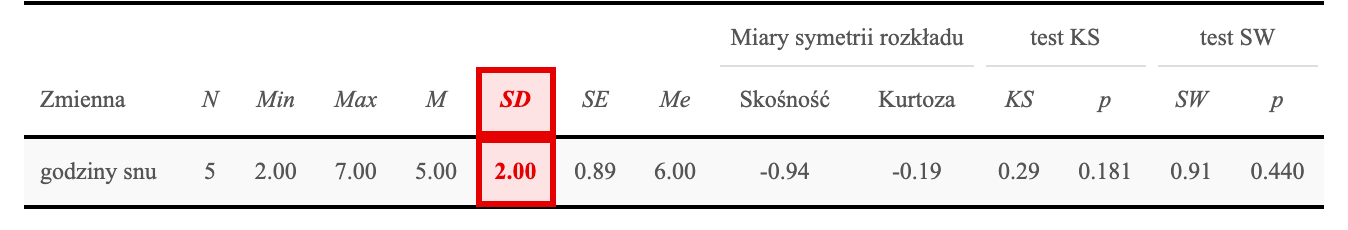
Zapis w stylu APA: W noc przed kolokwium studenci spali średnio 5 godzin (M = 5,00; SD = 2,00).
Jak policzyć odchylenie standardowe w R?
sen <- c(6, 2, 7, 4, 6)

# 1) „ręcznie”, dokładnie według wzoru
odch <- sen - mean(sen)
odch                                       # 1 -3 2 -1 1
sum(odch^2)                                # suma kwadratów: 16
sqrt(sum(odch^2) / (length(sen) - 1))      # SD = 2

# 2) gotowymi funkcjami (R zawsze dzieli przez n - 1)
var(sen)                                   # wariancja: 4
sd(sen)                                    # odchylenie standardowe: 2
psych::describe(sen)[, c("n", "mean", "sd", "se")]

# 3) współczynnik zmienności: SD jako procent średniej
100 * sd(sen) / mean(sen)                  # 40%
Wynik w konsoli R:
[1]  1 -3  2 -1  1
[1] 16
[1] 2
[1] 4
[1] 2
   n mean sd   se
X1 5    5  2 0.89
[1] 40
Funkcje sd() i var() w R, podobnie jak SPSS i SZTOS, liczą wersję z próby, czyli dzielą przez n − 1.
Jakie odchylenie standardowe jest duże, a jakie małe?
Nie ma jednej granicy, bo SD zależy od jednostek. 2 godziny różnicy w śnie to dużo, a 2 punkty na teście 0–100 – mało. Porównuj SD ze skalą pomiaru i ze średnią. Pomaga współczynnik zmienności: SD podzielone przez średnią i pomnożone przez 100%. Tutaj wynosi 2 / 5 · 100% = 40%, czyli rozrzut to aż 40% średniej długości snu. Współczynnik ma sens tylko dla zmiennych z prawdziwym zerem, takich jak czas albo liczba kubków kawy. Najbardziej przydaje się przy porównaniu dwóch grup mierzonych tym samym narzędziem.
Najczęstsze błędy
- Mylenie SD z błędem standardowym. SD opisuje rozrzut wyników ludzi, a SE – precyzję średniej (Altman i Bland, 2005).
- Używanie wzoru dla populacji (dzielenie przez n, w Excelu funkcja STDEV.P) dla danych z próby.
- Podawanie wariancji zamiast SD, czyli zapomniany pierwiastek.
- Zapis M ± SD dla skośnych danych. Dla kubków kawy z hasła o medianie wychodzi 6 ± 6,90, co sugeruje ujemną liczbę kubków. Lepiej podać medianę i IQR.
- Liczenie SD dla zmiennej nominalnej zakodowanej liczbami, np. kierunku studiów.
Bibliografia
- Pearson, K. (1894). Contributions to the mathematical theory of evolution. Philosophical Transactions of the Royal Society of London. A, 185, 71–110.
- Altman, D. G., & Bland, J. M. (2005). Standard deviations and standard errors. BMJ, 331(7521), 903. https://doi.org/10.1136/bmj.331.7521.903
- Field, A., Miles, J., & Field, Z. (2012). Discovering statistics using R. SAGE.
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówŚrednia arytmetyczna
- Słownik wzorówBłąd standardowy średniej
- Słownik wzorówOdchylenie standardowe populacji
- Słownik wzorówRozkład normalny
- PoradnikStatystyka opisowa – przykład
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
- Przykładowy raportOpis próby
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.