

Analiza regresji – przykład krok po kroku z interpretacją
Regresja liniowa wielokrotna opisuje, jak kilka predyktorów naraz wiąże się ze zmienną zależną, i pozwala tę zmienną przewidywać. Pokazujemy cały przebieg na dwóch predyktorach: współczynniki b i β, R² i skorygowane R², założenia na resztach, VIF oraz tabelę i akapit do pracy. Pytanie z pracy dyplomowej: czy liczba godzin nauki i poziom stresu pozwalają przewidzieć wynik kolokwium?
W skrócieModel i hipotezy → b, β i R² → założenia na resztach, VIF i obserwacje wpływowe → opis w stylu APA, tabela i wykres. Wzory na b i R² z rachunkiem ręcznym dla jednego predyktora znajdziesz w haśle regresja liniowa – wzór i przykład.
Regresja w statystyce – co to jest?
Regresja to model związku między zmienną zależną (tu: punkty) a predyktorami. Współczynników nie dobierasz – program je szacuje metodą najmniejszych kwadratów, czyli tak, by suma kwadratów reszt była jak najmniejsza. Ty wybierasz zmienne, i to na podstawie teorii i hipotez, a nie po obejrzeniu wyników.
Krok 1. Dane, model i hipotezy
Bierzemy tych samych dziesięciu studentów co we wpisie o korelacji Pearsona: godziny nauki w tygodniu (M = 5,00; SD = 2,40), stres przed kolokwium w skali 1–10 (M = 5,00; SD = 2,83) i punkty z kolokwium 0–20 (M = 12,00; SD = 5,40). Same korelacje z punktami wynoszą 0,80 dla nauki i −0,65 dla stresu. Model ma postać: punkty = b0 + b1 · nauka + b2 · stres + reszta.
- H0 dla modelu: predyktory razem nie wyjaśniają zmienności punktów w populacji (R² = 0); H0 dla predyktora: jego współczynnik wynosi zero przy stałym drugim predyktorze;
- H1: model wyjaśnia część zmienności, a współczynnik jest różny od zera; α = 0,05.
Krok 2. Wyniki: b, β i R²
| Predyktor | b | SE | 95% CI dla b | β | t(7) | p |
|---|---|---|---|---|---|---|
| stała | 9,13 | 1,76 | [4,97; 13,28] | – | 5,19 | 0,001 |
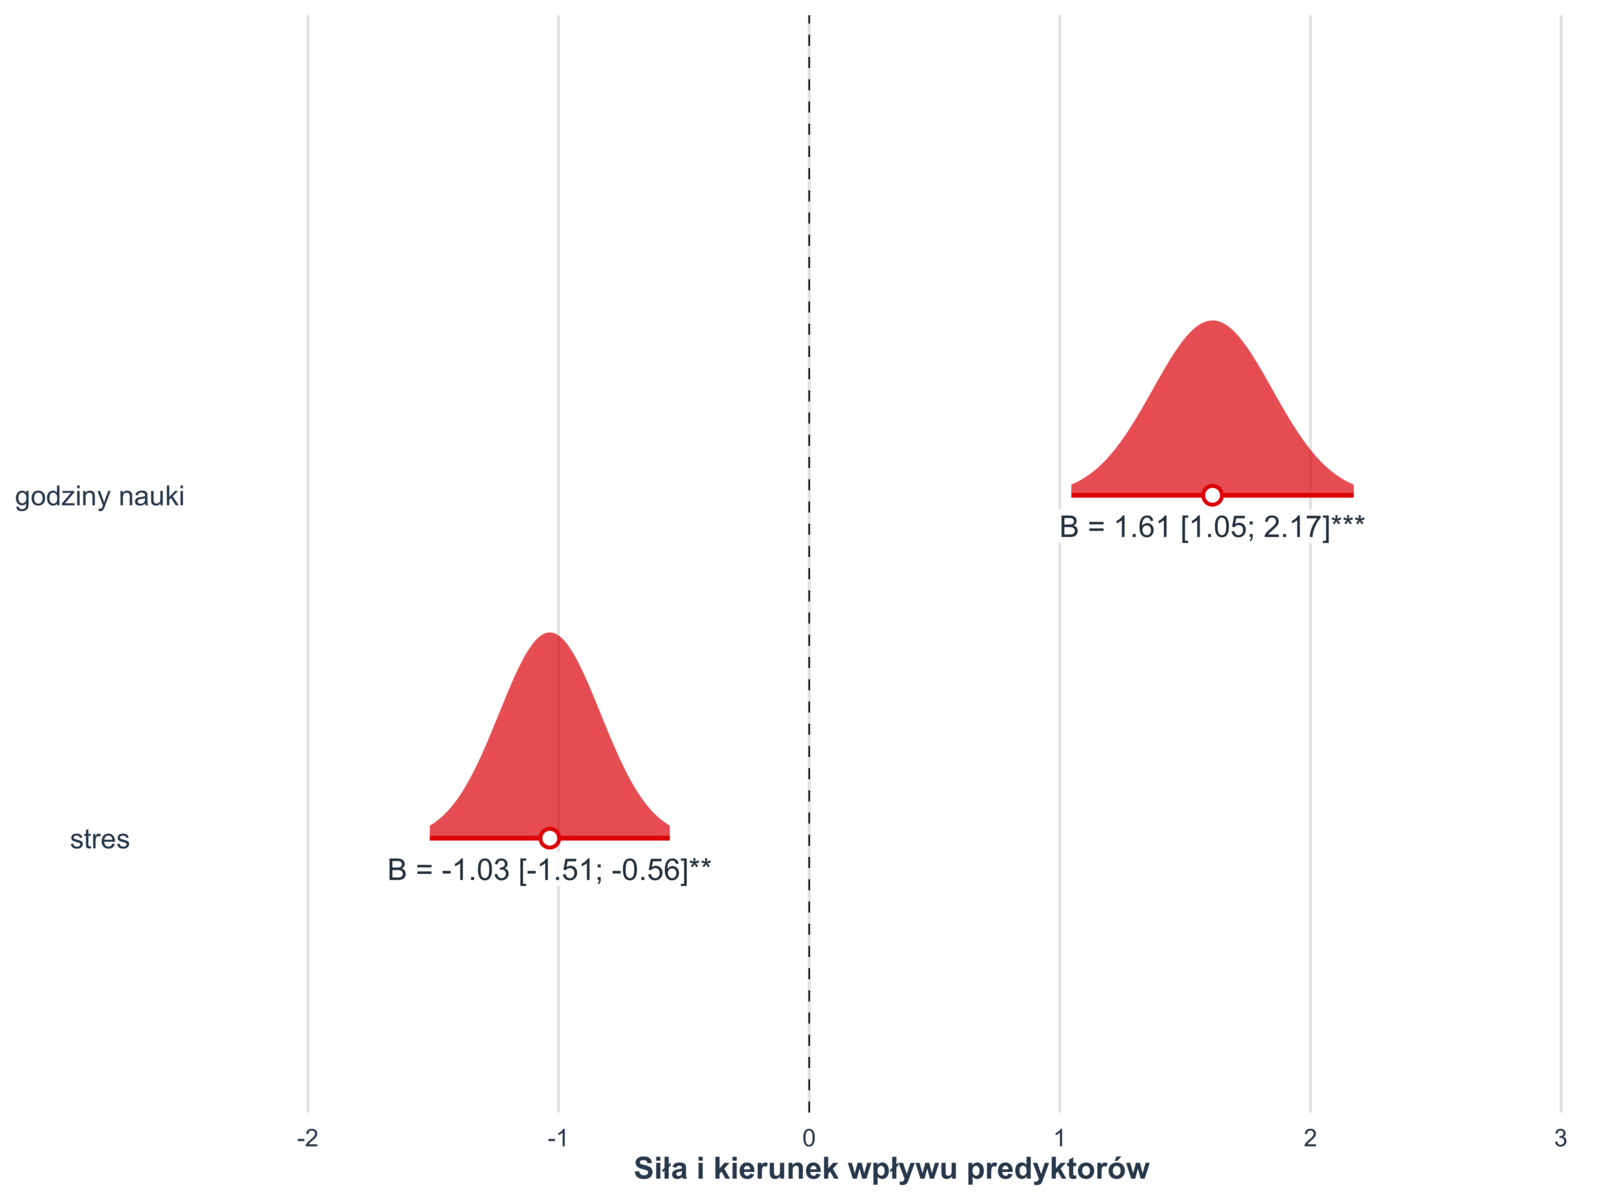
| godziny nauki | 1,61 | 0,24 | [1,05; 2,17] | 0,72 | 6,75 | < 0,001 |
| stres | −1,03 | 0,20 | [−1,51; −0,56] | −0,54 | −5,11 | 0,001 |
| R² = 0,92; skorygowane R² = 0,90; F(2, 7) = 41,85; p < 0,001; n = 10 | ||||||
- Współczynniki b są w jednostkach danych. Każda dodatkowa godzina nauki wiąże się ze średnio o 1,61 punktu wyższym wynikiem, przy tym samym poziomie stresu. Każdy punkt stresu więcej to średnio o 1,03 punktu mniej przy tej samej liczbie godzin nauki.
- Współczynniki β liczysz na zmiennych standaryzowanych, więc można je porównywać: 0,72 dla nauki i −0,54 dla stresu. Wartość bezwzględna β jest większa dla nauki, ale przedziały ufności (0,47–0,97 oraz po pominięciu znaku 0,29–0,79) mocno się nakładają, więc nie pisz, że nauka jest „ważniejsza”.
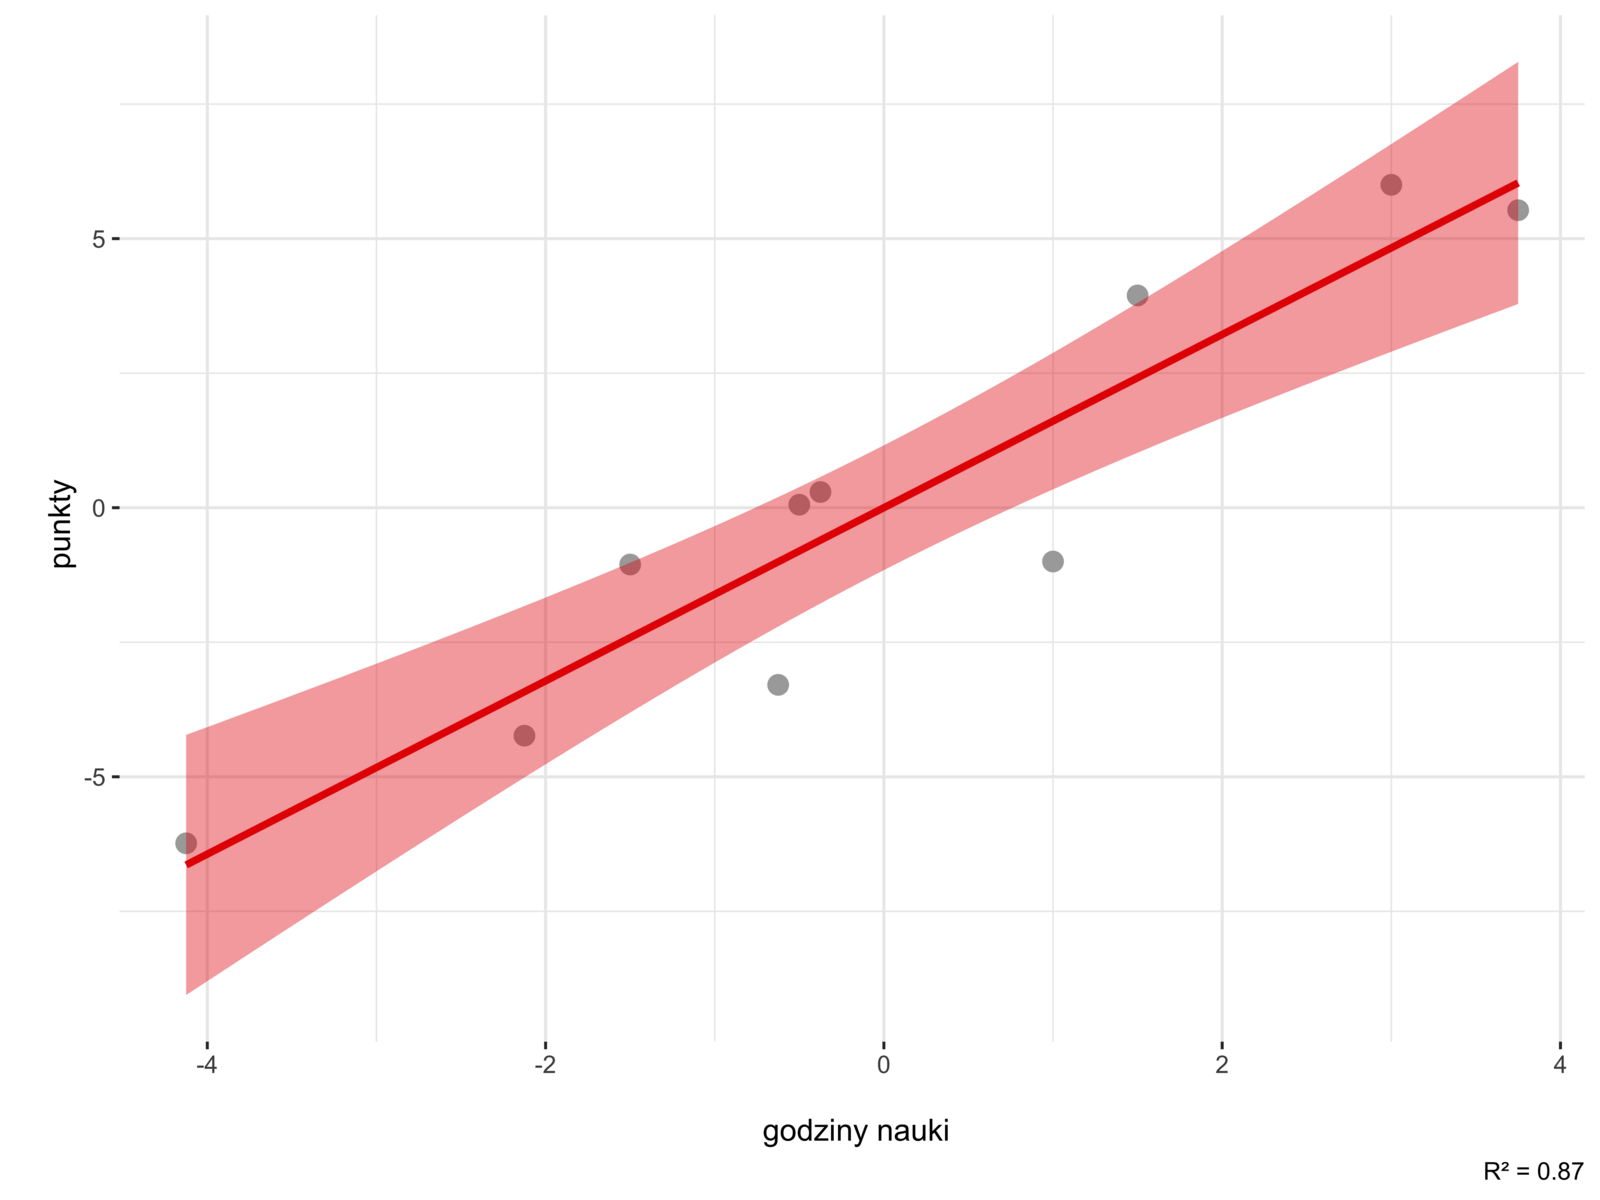
- R² = 0,92: model wyjaśnia 92% zmienności punktów w tej próbie. Sama nauka wyjaśniała 63%, więc stres dodał 29 punktów procentowych. Skorygowane R² = 0,90 karze za liczbę predyktorów i lepiej szacuje dopasowanie w populacji.
- Stała (9,13) to przewidywany wynik przy 0 godzin nauki i stresie 0. Skala stresu zaczyna się od 1, więc tej liczby nie interpretujemy.
Krok 3. Założenia regresji – sprawdzasz je na resztach
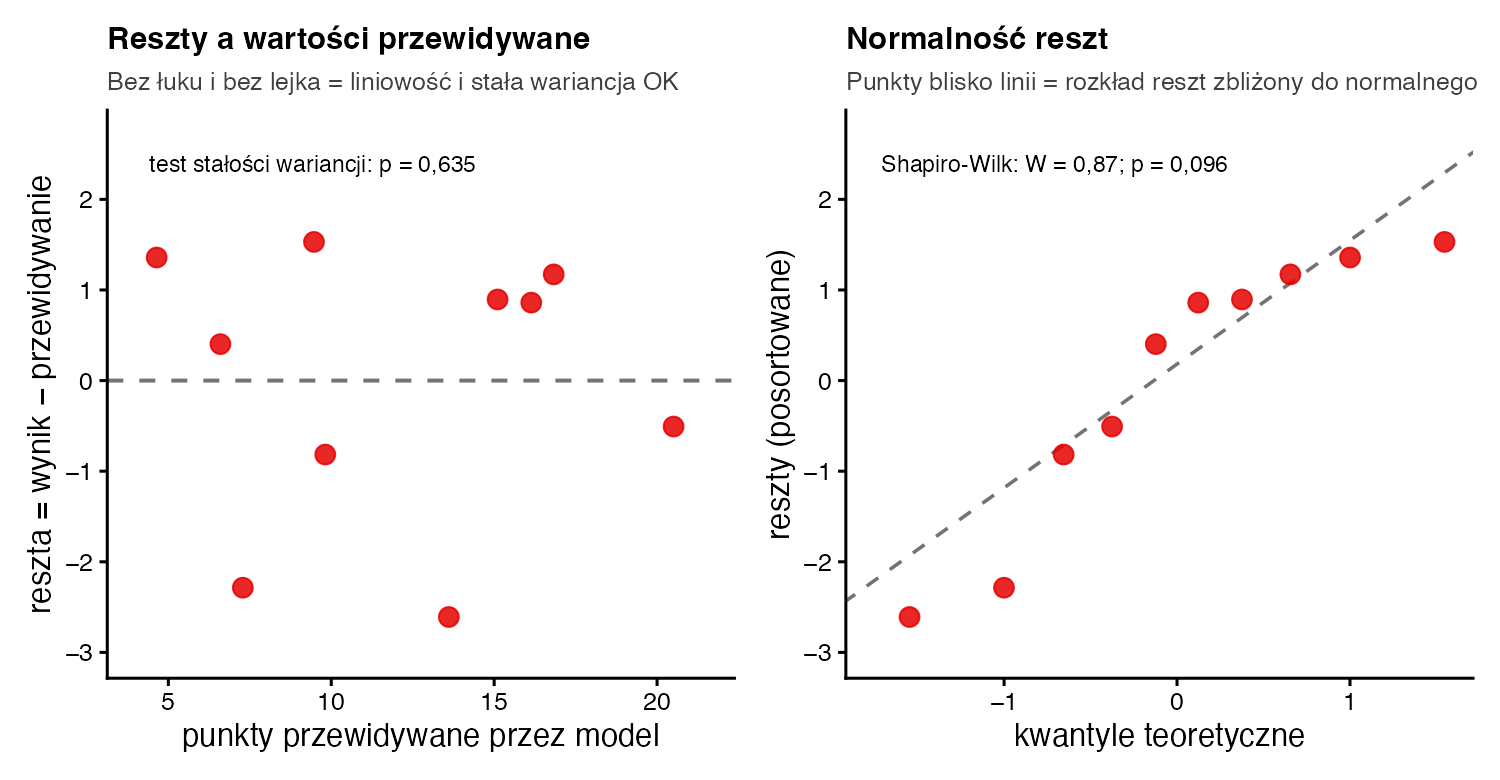
- Liniowość i stała wariancja reszt: na wykresie reszt nie ma łuku ani lejka (rys. 3); test stałości wariancji: p = 0,635.
- Normalność reszt, a nie samych zmiennych: Shapiro-Wilk W = 0,87; p = 0,096; przy małej próbie obejrzyj też wykres (rys. 3).
- Niezależność: każda osoba występuje raz.
- Współliniowość: VIF = 1,02 dla obu predyktorów – nauka i stres prawie się nie pokrywają.
- Obserwacje wpływowe: największa odległość Cooka wynosi 0,25, czyli mniej niż często stosowany próg 1. Sprawdź też, co się dzieje bez każdej osoby po kolei: b nauki mieści się wtedy w zakresie 1,51–1,68, a b stresu – od −1,18 do −0,92, wszystkie p ≤ 0,008. Nawet po usunięciu dowolnych dwóch osób oba predyktory pozostają istotne (największe p = 0,015 i 0,035).
Krok 4. Jak opisać wynik w pracy?
Zapis w stylu APA: Model regresji liniowej z liczbą godzin nauki i poziomem stresu jako predyktorami wyjaśniał 92% zmienności punktów z kolokwium, F(2, 7) = 41,85; p < 0,001; R² = 0,92; skorygowane R² = 0,90. Więcej godzin nauki wiązało się z wyższym wynikiem (b = 1,61; 95% CI [1,05; 2,17]; β = 0,72; p < 0,001), a wyższy stres – z niższym (b = −1,03; 95% CI [−1,51; −0,56]; β = −0,54; p = 0,001). Nie stwierdzono naruszenia założeń modelu ani współliniowości predyktorów (VIF = 1,02).
Pod tabelą wyjaśnij skróty (b, SE, β). W podpisie wykresu napisz, co oznaczają kropki i odcinki, i odwołaj się do niego w tekście. Pełny raport z takiej analizy pokazuje przykładowy raport SZTOS z analizy regresji.
Cała analiza w R
# Dane: 10 studentów (te same co we wpisie o korelacji Pearsona)
dane <- data.frame(nauka  = c(3, 4, 6, 5, 3, 8, 5, 1, 6, 9),          # godziny nauki w tygodniu
                   stres  = c(9, 8, 5, 2, 4, 5, 1, 4, 9, 3),          # stres przed kolokwium (1–10)
                   punkty = c(6, 5, 11, 16, 9, 18, 17, 7, 11, 20))   # punkty z kolokwium (0–20)

# 1) model regresji wielokrotnej: b, błędy standardowe, t i p
model <- lm(punkty ~ nauka + stres, data = dane)
s <- summary(model)
round(coef(s), 3)
round(confint(model), 2)                                  # 95% CI dla b

# 2) dopasowanie modelu: R², skorygowane R² i test F
round(c(R2 = s$r.squared, R2_skor = s$adj.r.squared, F = s$fstatistic[[1]]), 2)
pf(s$fstatistic[[1]], df1 = 2, df2 = 7, lower.tail = FALSE)   # p dla testu F(2, 7)

# 3) współczynniki standaryzowane beta z 95% CI
parameters::standardize_parameters(model)

# 4) założenia: normalność reszt, stała wariancja reszt, współliniowość, obserwacje wpływowe
shapiro.test(residuals(model))$p.value
car::ncvTest(model)$p
car::vif(model)
round(max(cooks.distance(model)), 2)

# 5) odporność: b i p po usunięciu każdej osoby po kolei (wiersze: minimum i maksimum)
bez <- t(sapply(1:10, function(i) {
  w <- coef(summary(lm(punkty ~ nauka + stres, data = dane[-i, ])))
  c(b_nauka = w[2, 1], p_nauka = w[2, 4], b_stres = w[3, 1], p_stres = w[3, 4]) }))
round(apply(bez, 2, range), 3)
Wynik w konsoli R:
            Estimate Std. Error t value Pr(>|t|)
(Intercept)    9.128      1.757   5.194    0.001
nauka          1.609      0.238   6.754    0.000
stres         -1.035      0.203  -5.111    0.001
            2.5 % 97.5 %
(Intercept)  4.97  13.28
nauka        1.05   2.17
stres       -1.51  -0.56
     R2 R2_skor       F
   0.92    0.90   41.85
[1] 0.0001277337
# Standardization method: refit

Parameter   | Std. Coef. |         95% CI
-----------------------------------------
(Intercept) |   1.17e-16 | [-0.24,  0.24]
nauka       |       0.72 | [ 0.47,  0.97]
stres       |      -0.54 | [-0.79, -0.29]
[1] 0.09588869
[1] 0.6345232
   nauka    stres
1.022113 1.022113
[1] 0.25
     b_nauka p_nauka b_stres p_stres
[1,]   1.514   0.000  -1.178   0.001
[2,]   1.675   0.002  -0.915   0.008
Pytania promotora i recenzenta
Czy 10 osób wystarczy do regresji?
Do ilustracji tak, do pracy nie. Często cytowana reguła Greena (1991) to co najmniej 50 + 8m osób do testu całego modelu, gdzie m to liczba predyktorów – przy dwóch predyktorach 66 osób.
Dlaczego stres jest tu wyraźnie istotny, a w samej korelacji ledwo (p = 0,043)?
Model zabiera z punktów część zmienności wyjaśnioną przez naukę. Zostaje mniej „szumu”, więc związek stresu z wynikiem widać wyraźniej. Dlatego w regresji b opisuje związek przy stałym drugim predyktorze.
Czy mogę napisać, że stres obniża wynik?
Nie przy danych korelacyjnych. Pisz „wiązał się z niższym wynikiem”. Wniosek przyczynowy wymaga eksperymentu.
Bibliografia
- Galton, F. (1886). Regression towards mediocrity in hereditary stature. The Journal of the Anthropological Institute of Great Britain and Ireland, 15, 246–263.
- Green, S. B. (1991). How many subjects does it take to do a regression analysis? Multivariate Behavioral Research, 26(3), 499–510. https://doi.org/10.1207/s15327906mbr2603_7
- Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). SAGE.
- Field, A., Miles, J., & Field, Z. (2012). Discovering statistics using R. SAGE.
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). https://doi.org/10.1037/0000165-000
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówRegresja liniowa
- Słownik wzorówVIF – współliniowość predyktorów
- Słownik wzorówOdległość Cooka
- PoradnikKorelacja Pearsona – przykład
- PoradnikKorelacja Spearmana – przykład
- Przykładowy raportAnaliza regresji
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.