

Korelacja Spearmana – przykład krok po kroku z interpretacją
Korelacja rang Spearmana mówi, czy dwie zmienne układają się w ten sam porządek. To naturalny wybór dla pytań ankiety na skali 1–5 i dla danych z wynikami odstającymi. Pokazujemy cały przebieg: od decyzji „Spearman czy Pearson”, przez macierz korelacji do pracy, po akapit APA. Pytanie z pracy dyplomowej: czy ocena zajęć i liczba godzin nauki wiążą się z poczuciem przygotowania do kolokwium?
W skróciePytanie i hipotezy → dlaczego Spearman → dane i mediany → macierz korelacji Spearmana → opis w stylu APA bez wniosków przyczynowych. Wzór na rs i rachunek na pięciu osobach znajdziesz w haśle korelacja rang Spearmana – wzór i przykład.
Krok 1. Pytanie badawcze i hipotezy
Dziesięciu studentów odpowiedziało na trzy pytania ankiety (1 = zdecydowanie nie, 5 = zdecydowanie tak): „Zajęcia są ciekawe”, „Prowadzący jasno tłumaczy” i „Czuję się przygotowany do kolokwium”. Podali też, ile godzin w tygodniu się uczą. Hipotezy dotyczą dwóch par: przygotowanie a jasność tłumaczenia oraz przygotowanie a godziny nauki. Pozostałe pary opisujemy pomocniczo.
- H0: w populacji korelacja rang danej pary wynosi zero (\(\rho_s = 0\));
- H1: korelacja jest różna od zera (\(\rho_s \neq 0\)); α = 0,05.
Krok 2. Kiedy Spearman zamiast Pearsona?
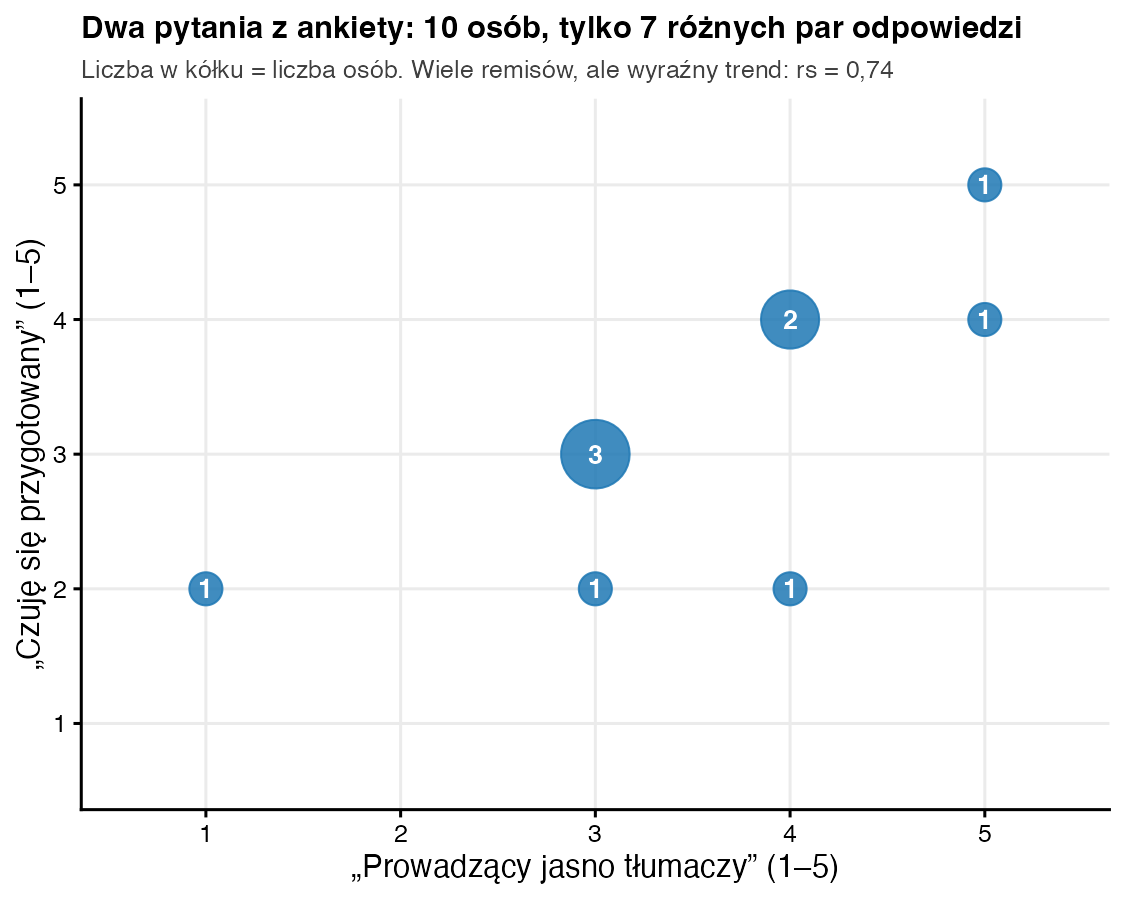
- Pojedyncze pytania Likerta są porządkowe. Dziesięć osób dało tylko siedem różnych par odpowiedzi na dwa pytania (rys. 1). Spearman korzysta z kolejności, a nie z odległości między „3” a „4”.
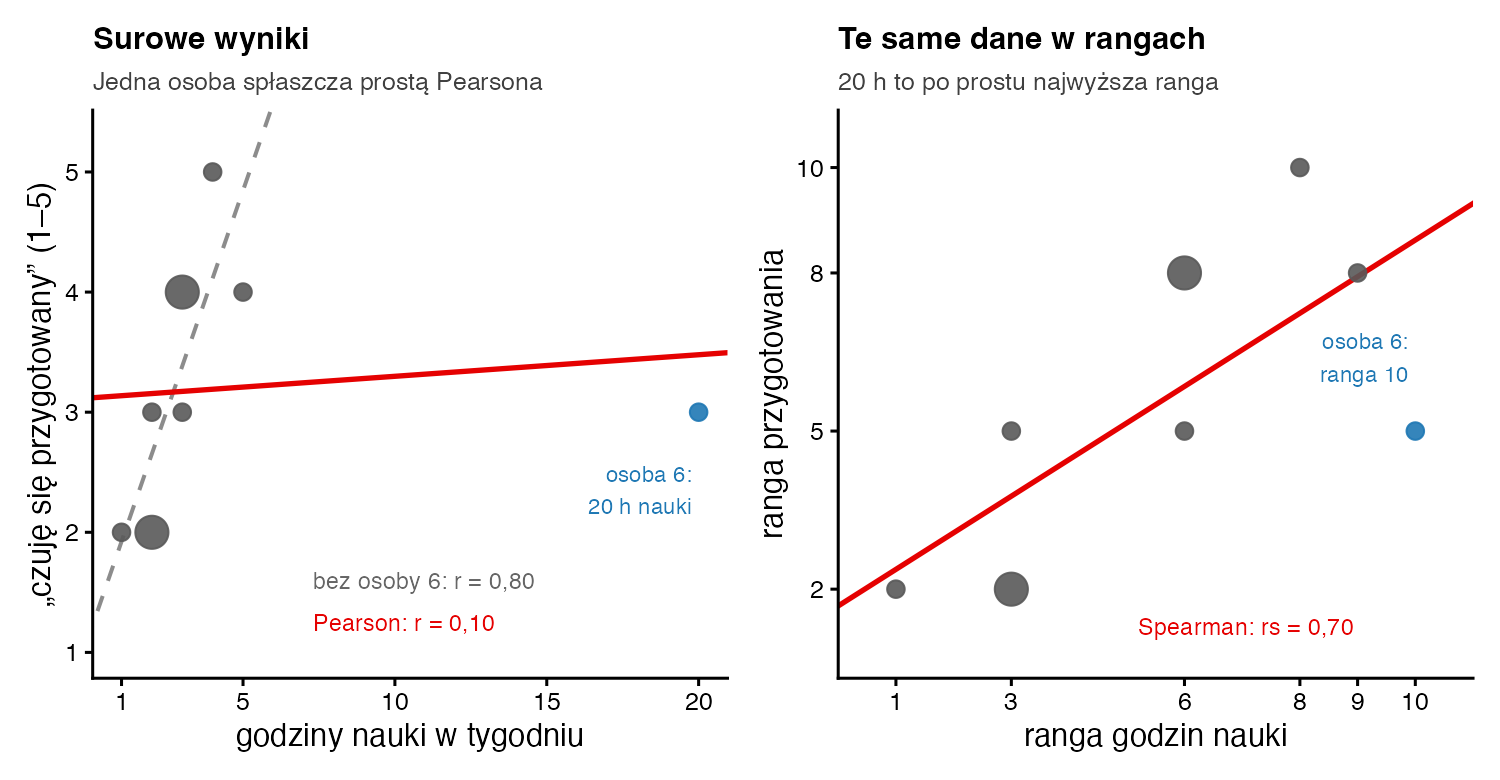
- Wynik odstający. Osoba 6 uczy się 20 godzin, a pozostali 1–5 godzin. Pearson dla pary godziny–przygotowanie daje r = 0,10, a bez tej osoby r = 0,80. Spearman daje rs = 0,70, bo 20 godzin to po prostu najwyższa ranga (rys. 2).
- Związek monotoniczny („im więcej, tym więcej”) nie musi być liniowy.
Gdy wyników odstających nie ma, oba współczynniki są zbliżone: dla pary jasność–przygotowanie Pearson daje 0,73, a Spearman 0,74. Gdy obie zmienne są ilościowe, związek jest liniowy i nie ma wyników odstających, wybierz korelację Pearsona. Decyzję podejmij przed liczeniem i opisz ją w rozdziale o metodzie.
Krok 3. Dane i statystyki opisowe
| Zmienna | Osoby 1–10 | Me | Min–max |
|---|---|---|---|
| Zajęcia są ciekawe | 3, 5, 4, 2, 4, 3, 5, 2, 3, 4 | 3,5 | 2–5 |
| Prowadzący jasno tłumaczy | 4, 5, 3, 3, 5, 3, 4, 1, 3, 4 | 3,5 | 1–5 |
| Czuję się przygotowany | 4, 5, 2, 3, 4, 3, 4, 2, 3, 2 | 3,0 | 2–5 |
| Godziny nauki w tygodniu | 5, 4, 2, 2, 3, 20, 3, 1, 3, 2 | 3,0 | 1–20 |
Krok 4. Macierz korelacji Spearmana
| Zmienna | Me | 1 | 2 | 3 |
|---|---|---|---|---|
| 1. Zajęcia są ciekawe | 3,5 | – | ||
| 2. Prowadzący jasno tłumaczy | 3,5 | 0,75* | – | |
| 3. Czuję się przygotowany | 3,0 | 0,45 | 0,74* | – |
| 4. Godziny nauki | 3,0 | 0,26 | 0,45 | 0,70* |
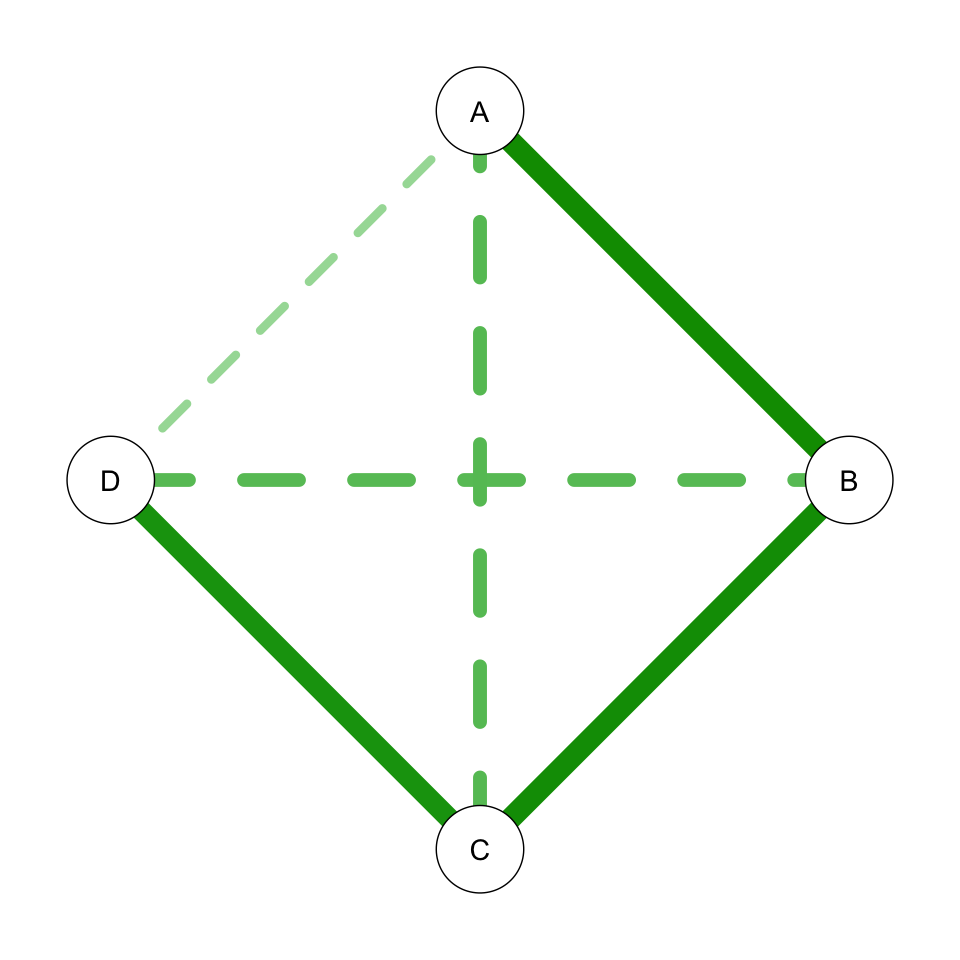
Pod tabelą dopisz notę: n = 10; * p < 0,05. Przy remisach R nie liczy dokładnego p, więc p pochodzi z przybliżenia rozkładem t, a 95% przedziały ufności – z przybliżenia Fishera. Poczucie przygotowania wiąże się z jasnością tłumaczenia (rs = 0,74; p = 0,015; 95% CI [0,21; 0,93]) i z liczbą godzin nauki (rs = 0,70; p = 0,023; 95% CI [0,13; 0,92]). Według konwencji Cohena (1988) to związki silne, ale szerokie przedziały pokazują, jak mało wiemy przy 10 osobach. Widać to też po usuwaniu po jednej osobie: oba rs zostają silne (0,61–0,93), ale w czterech z dwudziestu takich prób p przekracza 0,05. Dla dwóch par z hipotez korekta Holma daje p = 0,029 – wniosek bez zmian. Gdy testujesz wiele par bez hipotez, skorzystaj z korekty, jak we wpisie o korelacji Pearsona.
Krok 5. Jak opisać wynik w pracy?
Zapis w stylu APA: Poczucie przygotowania do kolokwium było dodatnio skorelowane z oceną jasności tłumaczenia, rs(8) = 0,74; p = 0,015; 95% CI [0,21; 0,93], oraz z liczbą godzin nauki, rs(8) = 0,70; p = 0,023; 95% CI [0,13; 0,92]. Ze względu na porządkowy charakter pytań i wynik odstający w liczbie godzin nauki zastosowano korelację rang Spearmana. Pełną macierz korelacji przedstawia Tabela 2.
Pisz o związku, a nie o wpływie: „osoby, które oceniały tłumaczenie jako jaśniejsze, częściej czuły się przygotowane”. Pełny raport z analizy korelacji pokazuje przykładowy raport SZTOS.
Cała analiza w R
# Dane: 10 studentów; trzy pytania ankiety (1 = zdecydowanie nie, 5 = zdecydowanie tak) i godziny nauki w tygodniu
dane <- data.frame(
  ciekawe       = c(3, 5, 4, 2, 4, 3, 5, 2, 3, 4),   # „Zajęcia są ciekawe”
  jasno         = c(4, 5, 3, 3, 5, 3, 4, 1, 3, 4),   # „Prowadzący jasno tłumaczy”
  przygotowanie = c(4, 5, 2, 3, 4, 3, 4, 2, 3, 2),   # „Czuję się przygotowany do kolokwium”
  godziny       = c(5, 4, 2, 2, 3, 20, 3, 1, 3, 2))  # godziny nauki w tygodniu

# 1) opis: mediany i zakres (przy pytaniach 1–5 nie licz średnich jak dla skali ilościowej)
sapply(dane, function(x) c(Me = median(x), min = min(x), max = max(x)))

# 2) macierz korelacji Spearmana; przy remisach p z przybliżenia rozkładem t
kor <- psych::corr.test(dane, method = "spearman", adjust = "none")
round(kor$r, 2)
round(kor$p, 3)

# 3) para z hipotezy: godziny nauki a przygotowanie – Spearman i dla porównania Pearson
cor.test(dane$godziny, dane$przygotowanie, method = "spearman", exact = FALSE)
round(cor(dane$godziny, dane$przygotowanie), 2)               # Pearson z osobą, która uczyła się 20 h
round(cor(dane$godziny[-6], dane$przygotowanie[-6]), 2)       # Pearson bez niej
Wynik w konsoli R:
    ciekawe jasno przygotowanie godziny
Me      3.5   3.5             3       3
min     2.0   1.0             2       1
max     5.0   5.0             5      20
              ciekawe jasno przygotowanie godziny
ciekawe          1.00  0.75          0.45    0.26
jasno            0.75  1.00          0.74    0.45
przygotowanie    0.45  0.74          1.00    0.70
godziny          0.26  0.45          0.70    1.00
              ciekawe jasno przygotowanie godziny
ciekawe         0.000 0.013         0.187   0.463
jasno           0.013 0.000         0.015   0.192
przygotowanie   0.187 0.015         0.000   0.023
godziny         0.463 0.192         0.023   0.000

	Spearman's rank correlation rho

data:  dane$godziny and dane$przygotowanie
S = 48.958, p-value = 0.02327
alternative hypothesis: true rho is not equal to 0
sample estimates:
      rho
0.7032844

[1] 0.1
[1] 0.8
Pytania promotora i recenzenta
Czy osobę z 20 godzinami nauki trzeba usunąć?
Nie, jeśli to prawdziwa odpowiedź, a nie błąd wpisu. Korelacja rang ogranicza jej wpływ bez usuwania danych. Opisz ją w tekście i pokaż na wykresie.
Spearman czy tau Kendalla?
Oba opierają się na rangach. Tau Kendalla bywa polecane przy bardzo małych próbach z wieloma remisami. Dla pary godziny–przygotowanie daje τ = 0,59; p = 0,034, czyli ten sam wniosek.
A jeśli łączę kilka pytań w skalę?
Suma lub średnia kilku pytań ma więcej możliwych wartości i często rozkład zbliżony do normalnego. Wtedy zwykle wystarczy korelacja Pearsona. Najpierw sprawdź jednak rzetelność skali – zobacz alfę Cronbacha na przykładzie. Spearmana zostaw dla pojedynczych pytań i danych z wynikami odstającymi. Inne metody oparte na rangach opisujemy we wpisie o testach nieparametrycznych.
Bibliografia
- Spearman, C. (1904). The proof and measurement of association between two things. The American Journal of Psychology, 15(1), 72–101. https://doi.org/10.2307/1412159
- de Winter, J. C. F., Gosling, S. D., & Potter, J. (2016). Comparing the Pearson and Spearman correlation coefficients across distributions and sample sizes: A tutorial using simulations and empirical data. Psychological Methods, 21(3), 273–290.
- Holm, S. (1979). A simple sequentially rejective multiple test procedure. Scandinavian Journal of Statistics, 6(2), 65–70.
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówKorelacja Spearmana
- Słownik wzorówTau Kendalla
- PoradnikKorelacja Pearsona – przykład
- PoradnikTesty nieparametryczne
- PoradnikRegresja liniowa – przykład
- Przykładowy raportAnaliza korelacji
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.