

Regresja liniowa – wzór i przykład krok po kroku
Regresja liniowa prosta opisuje związek dwóch zmiennych ilościowych za pomocą prostej \(\hat{y} = a + bx\) i pozwala przewidywać jedną zmienną na podstawie drugiej. Typowe pytanie z pracy dyplomowej: o ile punktów średnio rośnie wynik z kolokwium z każdą dodatkową godziną nauki?
W prostych słowachSzukasz prostej, która przechodzi jak najbliżej wszystkich punktów na wykresie. Jej nachylenie mówi, o ile średnio zmienia się wynik, gdy druga zmienna rośnie o jeden. Pionowe odległości punktów od prostej to błędy przewidywania, czyli reszty. Najlepsza prosta to ta, dla której suma kwadratów reszt jest najmniejsza.
Kiedy stosować regresję liniową?
- chcesz przewidywać zmienną ilościową (zmienną zależną y, np. punkty) na podstawie innej zmiennej (predyktora x, np. godzin nauki);
- związek jest w przybliżeniu liniowy – sprawdź to na wykresie rozrzutu;
- obserwacje są niezależne – każda osoba występuje w danych raz;
- reszty mają podobny rozrzut w całym zakresie x i rozkład zbliżony do normalnego. Założenia dotyczą reszt, a nie samych zmiennych x i y.
Gdy chcesz tylko opisać siłę związku, wystarczy korelacja Pearsona. Gdy zmienna zależna ma dwie kategorie (zdał/nie zdał), potrzebujesz regresji logistycznej. Przy kilku predyktorach mówimy o regresji wielokrotnej, \(\hat{y} = a + b_1x_1 + b_2x_2 + \dots\) – każde b opisuje wtedy zmianę y przy stałych pozostałych predyktorach, a ich wzajemne powiązanie sprawdzasz współczynnikiem VIF.
Wzór na regresję liniową
- \(\hat{y}\)
- wynik przewidywany przez prostą (czytaj: „y z daszkiem”)
- \(x_i,\ y_i\)
- wyniki i-tej osoby: predyktor (godziny) i zmienna zależna (punkty)
- \(\bar{x},\ \bar{y}\)
- średnie obu zmiennych
- \(b\)
- współczynnik nachylenia: o ile średnio zmienia się y, gdy x rośnie o 1
- \(a\)
- wyraz wolny (stała): przewidywany wynik dla x = 0
- \(y_i - \hat{y}_i\)
- reszta, czyli błąd przewidywania dla i-tej osoby
- \(R^2\)
- współczynnik determinacji: jaka część zmienności y jest wyjaśniona przez prostą
- \(t,\ SE_b,\ df\)
- statystyka testu istotności b, błąd standardowy b i stopnie swobody
Przykład krok po kroku
Te same dane co w haśle o korelacji Pearsona: pięcioro studentów zapisało, ile godzin uczyło się do kolokwium (x) i ile punktów zdobyło (y).
| x | y | x − 3 | y − 6 | (x − 3)(y − 6) | (x − 3)² | ŷ | reszta y − ŷ | reszta² |
|---|---|---|---|---|---|---|---|---|
| 1 | 4 | −2 | −2 | 4 | 4 | 2,8 | 1,2 | 1,44 |
| 2 | 2 | −1 | −4 | 4 | 1 | 4,4 | −2,4 | 5,76 |
| 3 | 8 | 0 | 2 | 0 | 0 | 6,0 | 2,0 | 4,00 |
| 4 | 6 | 1 | 0 | 0 | 1 | 7,6 | −1,6 | 2,56 |
| 5 | 10 | 2 | 4 | 8 | 4 | 9,2 | 0,8 | 0,64 |
| Σ = 15 | Σ = 30 | 0 | 0 | 16 | 10 | 30 | 0 | 14,4 |
- Średnie. \(\bar{x} = 15/5 = 3\), \(\bar{y} = 30/5 = 6\).
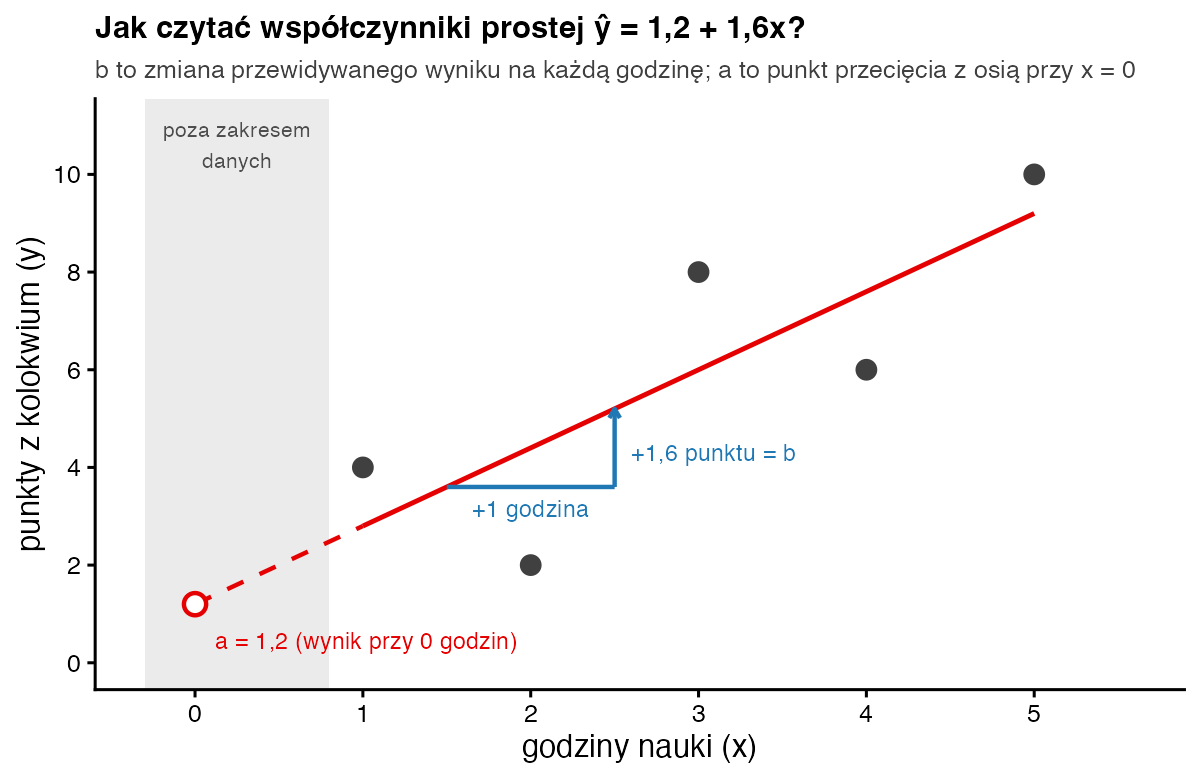
- Nachylenie. b = 16 / 10 = 1,6.
- Wyraz wolny. a = 6 − 1,6 · 3 = 1,2. Równanie prostej: ŷ = 1,2 + 1,6x.
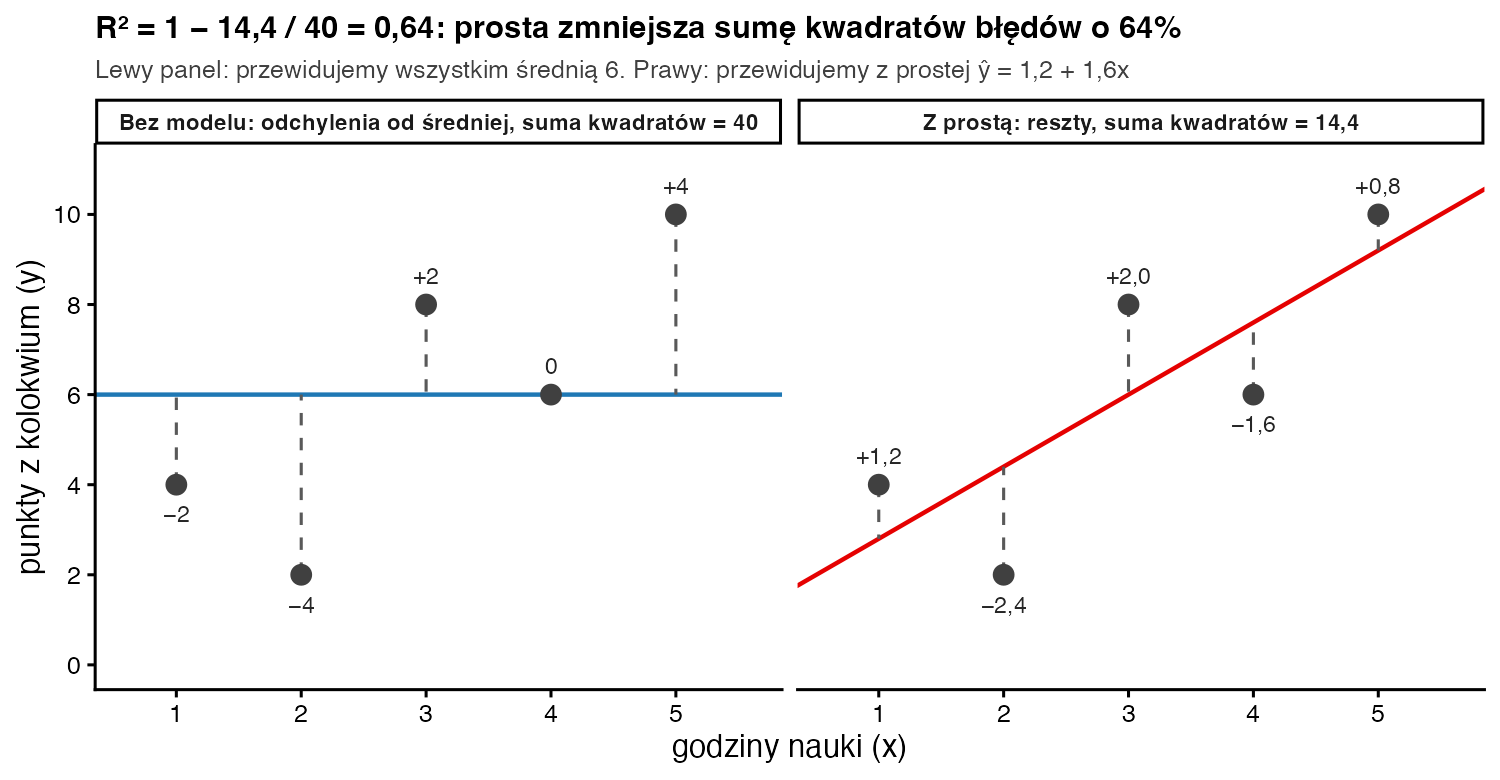
- Reszty. Dla x = 1: ŷ = 1,2 + 1,6 = 2,8, a reszta 4 − 2,8 = 1,2. Reszty zawsze sumują się do zera.
- R². Bez modelu suma kwadratów odchyleń od średniej wynosi Σ(y − 6)² = 4 + 16 + 4 + 0 + 16 = 40. Z prostą zostaje 14,4. R² = 1 − 14,4 / 40 = 0,64.
- Istotność b. \(SE_b = \sqrt{(14{,}4/3)/10} = \sqrt{0{,}48} = 0{,}693\); t = 1,6 / 0,693 = 2,31; df = 3; p = 0,104 – wynik nieistotny przy α = 0,05.
Jak zinterpretować i opisać wynik?
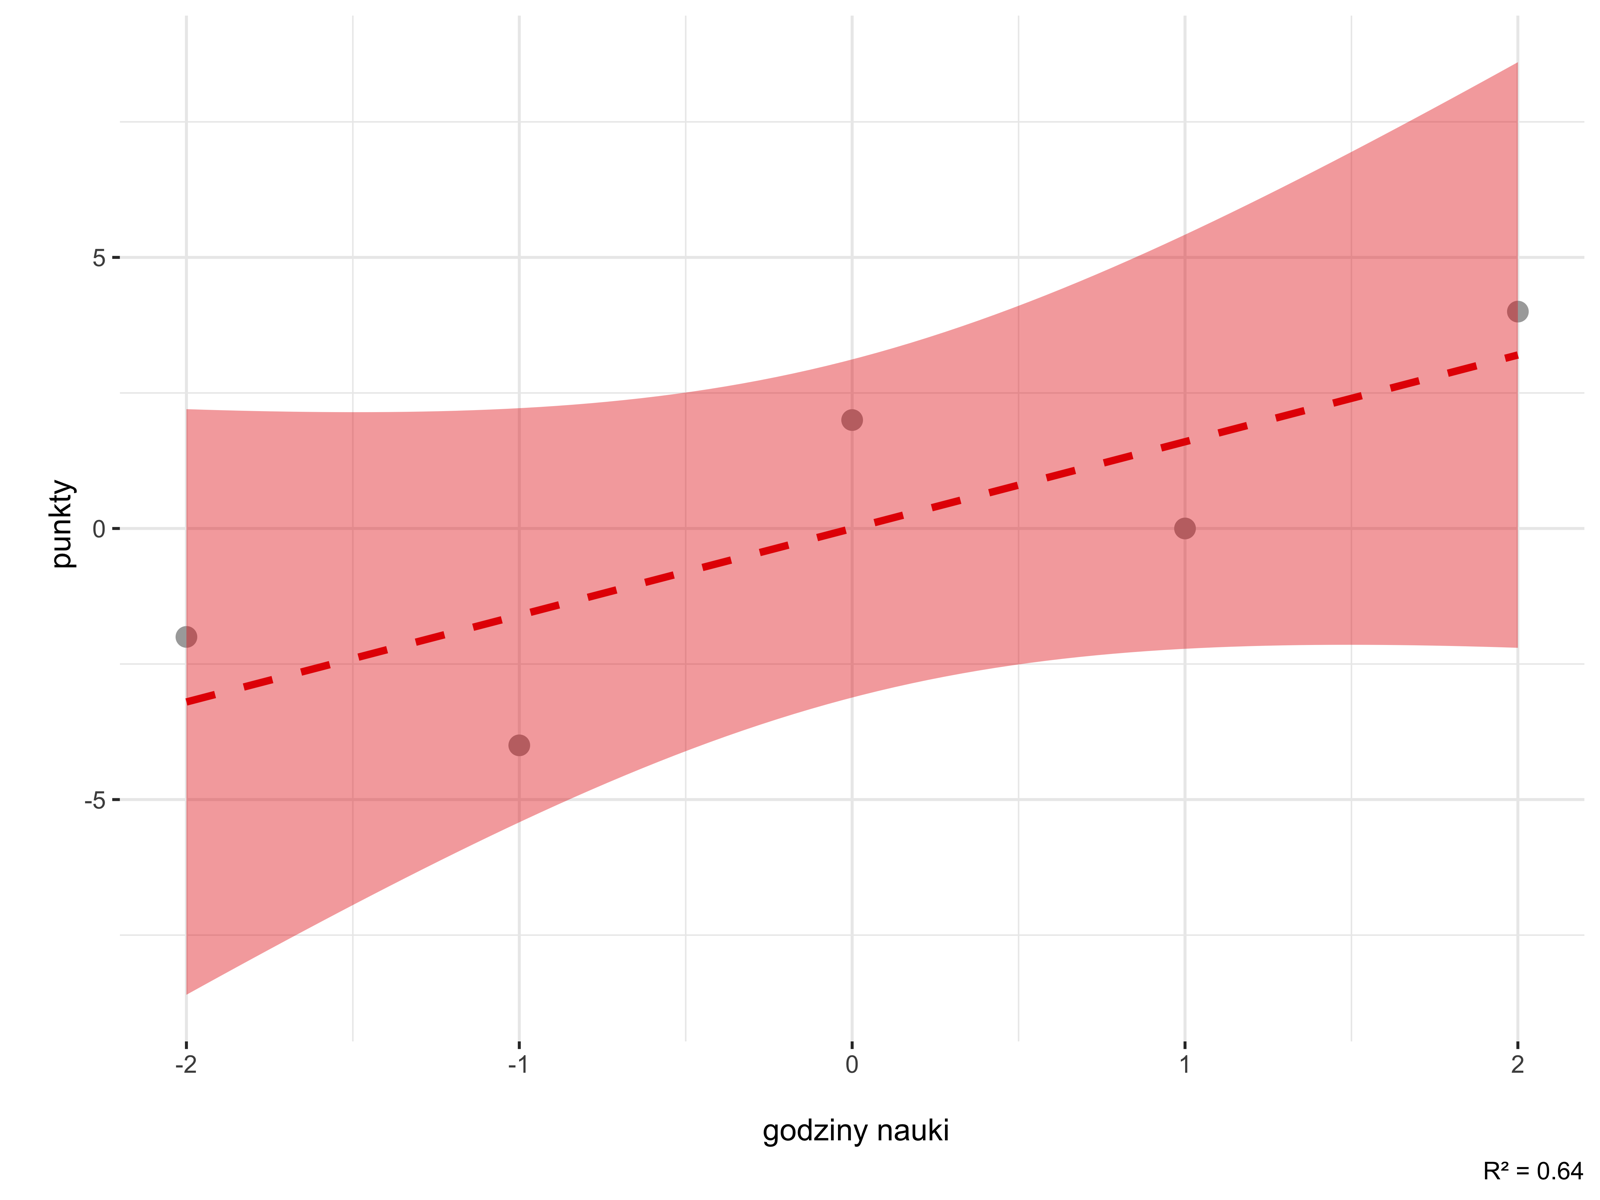
Każda dodatkowa godzina nauki wiąże się ze średnio o 1,6 punktu wyższym wynikiem, a model wyjaśnia 64% zmienności punktów. Współczynnik standaryzowany β = 0,80 jest w regresji prostej równy r Pearsona. To opis związku, a nie dowód przyczyny. 95% przedział ufności dla b (od −0,60 do 3,80) obejmuje zero, więc przy pięciu osobach nie możemy wykluczyć braku związku w populacji.
Zapis w stylu APA: Liczba godzin nauki wyjaśniała 64% zmienności punktów z kolokwium, R² = 0,64; F(1, 3) = 5,33; p = 0,104. Każda dodatkowa godzina wiązała się ze średnio o 1,6 punktu wyższym wynikiem, b = 1,60; 95% CI [−0,60; 3,80]; t(3) = 2,31; p = 0,104, jednak przy tak małej próbie efekt nie był istotny statystycznie.
Jak policzyć regresję liniową w R?
godziny <- c(1, 2, 3, 4, 5)
punkty  <- c(4, 2, 8, 6, 10)

# 1) „ręcznie”, według wzorów metody najmniejszych kwadratów
b <- sum((godziny - mean(godziny)) * (punkty - mean(punkty))) /
     sum((godziny - mean(godziny))^2)
a <- mean(punkty) - b * mean(godziny)
reszty <- punkty - (a + b * godziny)
c(a = a, b = b, R2 = 1 - sum(reszty^2) / sum((punkty - mean(punkty))^2))

# 2) gotową funkcją
model <- lm(punkty ~ godziny)
summary(model)
confint(model)          # 95% przedziały ufności dla a i b
Wynik w konsoli R:
   a    b   R2
1.20 1.60 0.64

Call:
lm(formula = punkty ~ godziny)

Residuals:
   1    2    3    4    5
 1.2 -2.4  2.0 -1.6  0.8

Coefficients:
            Estimate Std. Error t value Pr(>|t|)
(Intercept)   1.2000     2.2978   0.522    0.638
godziny       1.6000     0.6928   2.309    0.104

Residual standard error: 2.191 on 3 degrees of freedom
Multiple R-squared:   0.64,	Adjusted R-squared:   0.52
F-statistic: 5.333 on 1 and 3 DF,  p-value: 0.1041

                 2.5 %   97.5 %
(Intercept) -6.1127049 8.512705
godziny     -0.6048635 3.804863
W tabeli Coefficients wiersz godziny to b, a (Intercept) to a. Wartość p dla b (0,104) jest taka sama jak p testu F całego modelu i jak p korelacji Pearsona – przy jednym predyktorze to ten sam test.
Jak sprawdzić założenia regresji liniowej?
Założenia sprawdzasz na resztach, czyli po dopasowaniu modelu. Na wykresie reszt względem wartości przewidywanych punkty nie powinny układać się w łuk ani w lejek. Wykres kwantyl-kwantyl reszt pokaże, czy ich rozkład jest zbliżony do normalnego. Na koniec poszukaj obserwacji wpływowych: dużych reszt standaryzowanych, wysokiej dźwigni i dużej odległości Cooka. Testowanie normalności samego y przed analizą jest zbędne.
Najczęstsze błędy
- Interpretowanie wyrazu wolnego, gdy x = 0 leży poza zakresem danych.
- Język przyczynowy („nauka zwiększa wynik o 1,6 punktu”) przy danych z badania korelacyjnego.
- Sprawdzanie normalności zmiennych x i y zamiast reszt modelu.
- Przewidywanie daleko poza zakresem danych, np. wyniku dla 20 godzin nauki.
- Podawanie samego R² bez współczynnika b, jego przedziału ufności i wartości p.
Bibliografia
- Galton, F. (1886). Regression towards mediocrity in hereditary stature. The Journal of the Anthropological Institute of Great Britain and Ireland, 15, 246–263.
- Montgomery, D. C., Peck, E. A., & Vining, G. G. (2012). Introduction to linear regression analysis (5th ed.). Wiley.
- Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). SAGE.
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówKorelacja Pearsona
- Słownik wzorówVIF – współliniowość predyktorów
- Słownik wzorówOdległość Cooka
- Słownik wzorówRegresja logistyczna
- PoradnikRegresja liniowa – przykład
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
- Przykładowy raportAnaliza regresji
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.