

VIF – współczynnik inflacji wariancji: wzór i przykład
VIF (ang. variance inflation factor, współczynnik inflacji wariancji) mówi, na ile predyktor w regresji wielorakiej pokrywa się z pozostałymi predyktorami. Typowe pytanie z pracy dyplomowej: czy w jednym modelu mogę jednocześnie umieścić godziny nauki i liczbę wypitych kubków kawy, skoro jedno i drugie rośnie razem?
W prostych słowachJeśli dwa predyktory niosą prawie tę samą informację, model ma kłopot z rozstrzygnięciem, któremu z nich przypisać wpływ. Oszacowania stają się chwiejne: niewielka zmiana w danych potrafi je mocno przesunąć, a nawet odwrócić znak. VIF mówi, ile razy rośnie przez to wariancja współczynnika, czyli kwadrat jego błędu standardowego. VIF = 1 oznacza, że predyktor niczego nie dzieli z pozostałymi.
Kiedy stosować VIF?
- budujesz regresję liniową z co najmniej dwoma predyktorami;
- predyktory mogą być ze sobą powiązane (godziny nauki, kawa, liczba podejść do testów próbnych);
- chcesz interpretować osobne współczynniki b – gdy model służy tylko do przewidywania, współliniowość przeszkadza mniej;
- w modelu są interakcje lub kwadraty zmiennych – wtedy wysoki VIF bywa sztuczny i zwykle spada po wycentrowaniu zmiennych.
VIF to część diagnostyki regresji liniowej, obok wartości dźwigni i odległości Cooka. Cały opis modelu w pracy pokazuje przykład analizy regresji.
Wzór na VIF
- \(j\)
- numer predyktora, dla którego liczysz VIF
- \(R_j^2\)
- współczynnik determinacji z regresji pomocniczej, w której predyktor j jest wyjaśniany przez wszystkie pozostałe predyktory (bez zmiennej zależnej)
- tolerancja
- część zmienności predyktora, której nie da się odtworzyć z pozostałych predyktorów
- \(\sqrt{\mathrm{VIF}_j}\)
- ile razy większy jest błąd standardowy współczynnika \(b_j\) niż przy predyktorach nieskorelowanych (przy tym samym rozrzucie reszt)
Przykład krok po kroku
Pięcioro studentów podało, ile godzin się uczyło (x₁), ile kubków kawy wypiło w dniu nauki (x₂) i ile punktów zdobyło na kolokwium (4, 2, 8, 6, 10). Średnio uczyli się 3 godziny i pili 3 kubki.
| Godziny x₁ | Kawa x₂ | x₁ − 3 | x₂ − 3 | (x₁ − 3)(x₂ − 3) | (x₁ − 3)² | (x₂ − 3)² |
|---|---|---|---|---|---|---|
| 1 | 1 | −2 | −2 | 4 | 4 | 4 |
| 2 | 3 | −1 | 0 | 0 | 1 | 0 |
| 3 | 3 | 0 | 0 | 0 | 0 | 0 |
| 4 | 3 | 1 | 0 | 0 | 1 | 0 |
| 5 | 5 | 2 | 2 | 4 | 4 | 4 |
| Σ = 15 | Σ = 15 | 0 | 0 | 8 | 10 | 8 |
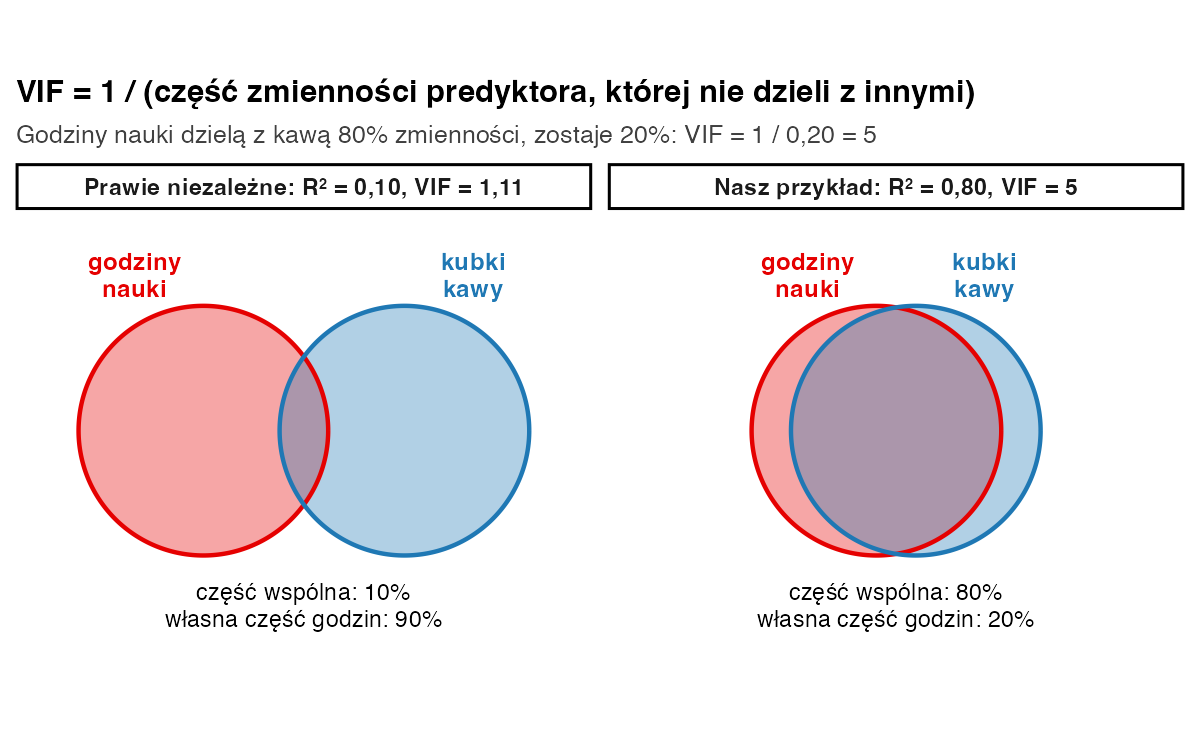
- Regresja pomocnicza. Przy dwóch predyktorach \(R_1^2\) to kwadrat ich korelacji Pearsona: \(r = 8/\sqrt{10 \cdot 8} = 0{,}894\), więc \(R^2 = 64/80 = 0{,}80\). Kawa „odtwarza” 80% zmienności godzin nauki.
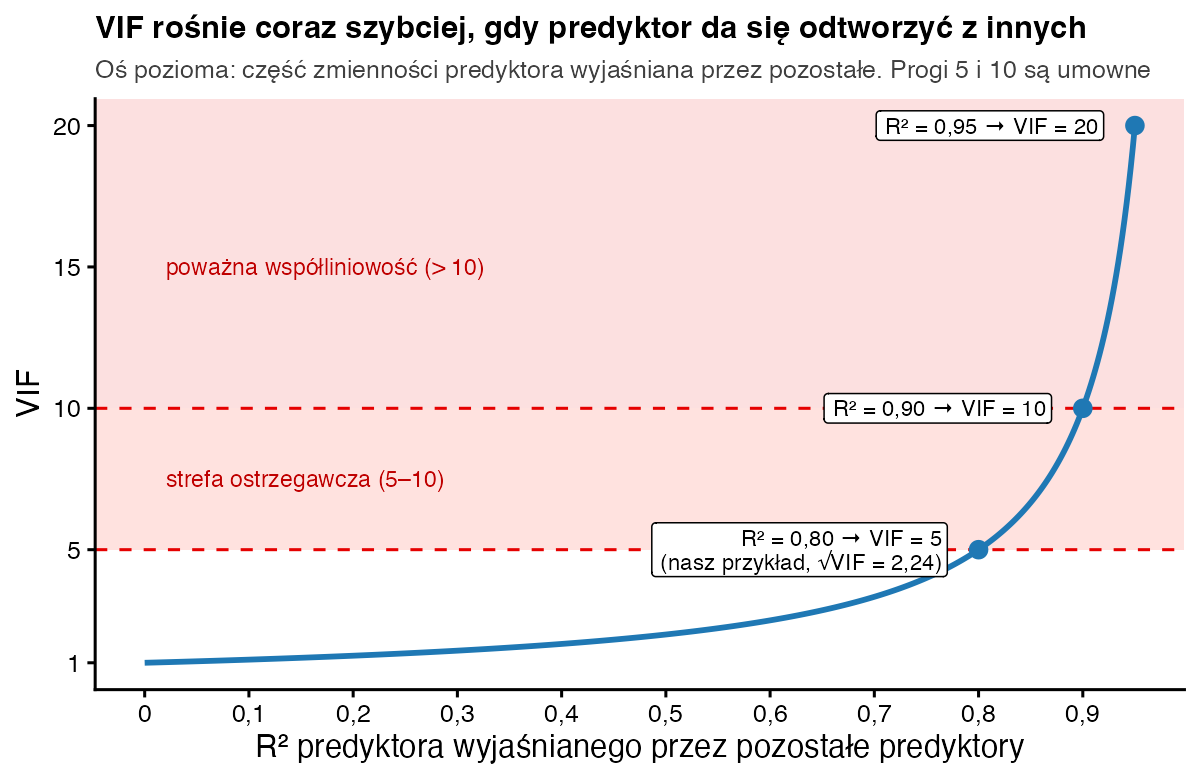
- VIF. VIF = 1 / (1 − 0,80) = 1 / 0,20 = 5. Przy dwóch predyktorach oba mają ten sam VIF.
- Tolerancja i pierwiastek. Tolerancja = 0,20; √5 = 2,24.
- Sprawdzenie w modelu. Model ma postać punkty = 1,5 + 2,0 · godziny − 0,5 · kawa (R² = 0,65, rozrzut reszt s = √7 = 2,646). Bez współliniowości błąd standardowy b dla godzin wynosiłby 2,646 / √10 = 0,837. Przy VIF = 5 wynosi 0,837 · √5 = 0,837 · 2,236 = 1,87.
- Skutek. Kawa sama w sobie koreluje z punktami dodatnio (r = 0,67), a w modelu dostaje znak ujemny (b = −0,5). Taka „zamiana znaku” to typowy objaw współliniowości.
Jak zinterpretować i opisać wynik?
VIF = 1 oznacza brak współliniowości. Najczęściej spotkasz progi VIF > 5 („warto się przyjrzeć”) i VIF > 10 („poważny problem”). To tylko reguły kciuka: O’Brien (2007) pokazuje, że nawet VIF powyżej 10 nie musi przekreślać modelu przy dużej próbie, a przy małej kłopoty zaczynają się wcześniej. Co możesz zrobić? Usunąć jeden z dublujących się predyktorów, połączyć je we wspólny wskaźnik albo zebrać więcej danych. Nie usuwaj predyktora, który wynika z hipotezy, tylko dlatego, że ma wysoki VIF.
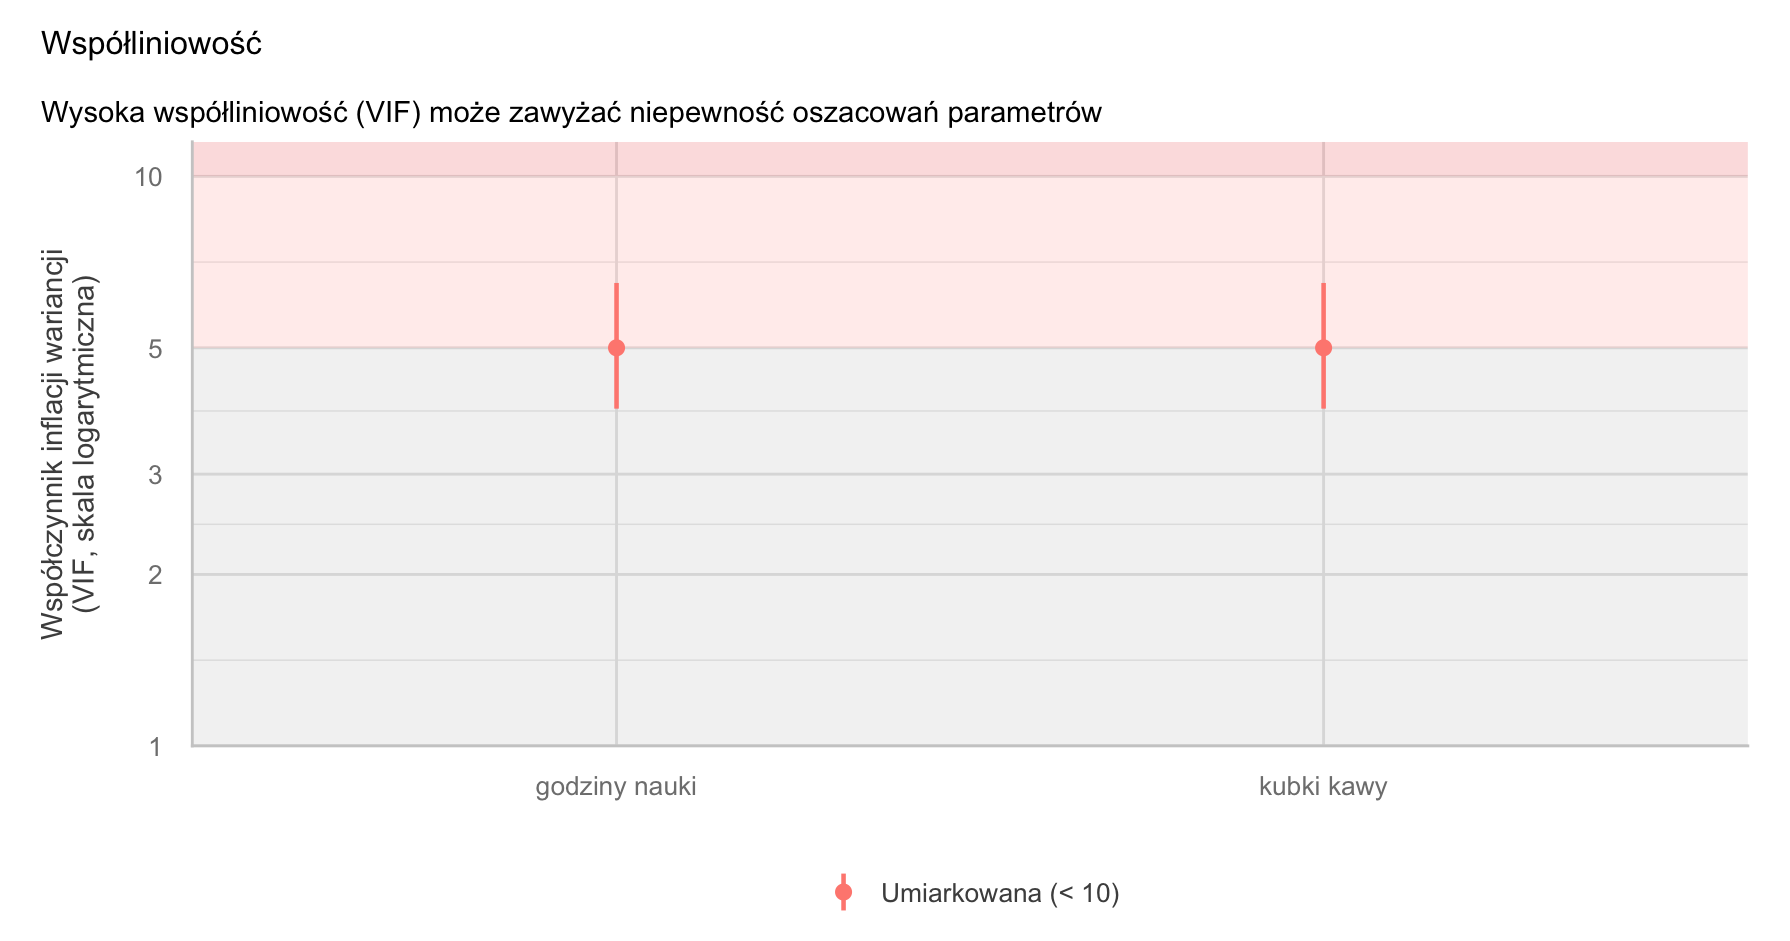
Zapis w stylu APA: Współliniowość predyktorów oceniono współczynnikiem VIF. Dla godzin nauki i liczby kubków kawy VIF wyniósł 5,00 (tolerancja = 0,20), co odpowiada często stosowanemu progowi ostrzegawczemu (por. O’Brien, 2007) i wskazuje na umiarkowaną współliniowość.
Jak policzyć VIF w R?
punkty  <- c(4, 2, 8, 6, 10)
godziny <- c(1, 2, 3, 4, 5)
kawa    <- c(1, 3, 3, 3, 5)     # kubki kawy wypite w dniu nauki

# 1) „ręcznie”: jak dobrze kawa przewiduje godziny nauki?
R2 <- summary(lm(godziny ~ kawa))$r.squared
R2                              # 0.8
1 / (1 - R2)                    # VIF = 5

# 2) gotową funkcją z pakietu car
m <- lm(punkty ~ godziny + kawa)
car::vif(m)
1 / car::vif(m)                 # tolerancja
round(summary(m)$coefficients, 2)
Wynik w konsoli R:
[1] 0.8
[1] 5
godziny    kawa
      5       5
godziny    kawa
    0.2     0.2
            Estimate Std. Error t value Pr(>|t|)
(Intercept)      1.5       3.05    0.49     0.67
godziny          2.0       1.87    1.07     0.40
kawa            -0.5       2.09   -0.24     0.83
Dla predyktorów kategorialnych o kilku poziomach car::vif() poda uogólniony VIF (GVIF). Wtedy porównuj wartość GVIF^(1/(2·Df)) z pierwiastkami zwykłych progów (Fox i Monette, 1992).
Czy macierz korelacji wystarczy do oceny współliniowości?
Nie. Korelacje pokazują tylko pary zmiennych. VIF bierze pod uwagę wszystkie pozostałe predyktory naraz, więc wykryje sytuację, w której jedna zmienna jest prawie sumą dwóch innych, choć z każdą z nich osobno koreluje umiarkowanie. Tylko przy dwóch predyktorach oba podejścia są równoważne: VIF = 1/(1 − r²), tak jak w naszym przykładzie.
Najczęstsze błędy
- Liczenie VIF z udziałem zmiennej zależnej – VIF dotyczy wyłącznie predyktorów.
- Ocena współliniowości tylko na podstawie korelacji parami.
- Mechaniczne usuwanie predyktorów z VIF > 5 bez uzasadnienia teoretycznego.
- Branie wysokiego VIF przy interakcjach i kwadratach zmiennych za problem – często znika po wycentrowaniu.
- Pisanie, że VIF mierzy siłę związku predyktora z wynikiem – VIF w ogóle nie zależy od zmiennej zależnej.
Bibliografia
- O’Brien, R. M. (2007). A caution regarding rules of thumb for variance inflation factors. Quality & Quantity, 41(5), 673–690. https://doi.org/10.1007/s11135-006-9018-6
- Belsley, D. A., Kuh, E., & Welsch, R. E. (1980). Regression diagnostics: Identifying influential data and sources of collinearity. Wiley.
- Fox, J., & Monette, G. (1992). Generalized collinearity diagnostics. Journal of the American Statistical Association, 87(417), 178–183.
- Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). SAGE.
- Field, A., Miles, J., & Field, Z. (2012). Discovering statistics using R. SAGE.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówRegresja liniowa
- Słownik wzorówKorelacja Pearsona
- Słownik wzorówRegresja logistyczna
- PoradnikRegresja liniowa – przykład
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
- Przykładowy raportAnaliza regresji
Przygotowujesz artykuł, doktorat lub grant?
Zaplanujemy i wykonamy analizy, przygotujemy raport z tabelami, wykresami i kodem R oraz pomożemy odpowiedzieć na uwagi recenzentów dotyczące statystyki.