

Korelacja Pearsona – przykład krok po kroku z interpretacją
Korelacja Pearsona mierzy siłę i kierunek liniowego związku dwóch zmiennych ilościowych. W pracy rzadko liczysz jedną korelację, zwykle kilka naraz. Pokazujemy więc cały przebieg na czterech zmiennych: od założeń, przez macierz korelacji do pracy i korektę na wielokrotne porównania, po akapit APA. Pytanie z pracy dyplomowej: czy sen, nauka i stres wiążą się z wynikiem kolokwium?
W skróciePytanie i hipotezy → statystyki opisowe → wykresy rozrzutu i założenia → macierz korelacji → korekta na wielokrotne porównania → opis w stylu APA bez wniosków przyczynowych. Wzór na r i obliczenia ręczne na pięciu osobach znajdziesz w haśle korelacja Pearsona – wzór i przykład.
Pytanie badawcze i hipotezy
Dziesięciu studentów podało, ile godzin spało w noc przed kolokwium, ile godzin uczyło się w tygodniu przed nim i jak silny stres odczuwało (skala 1–10). Zapisaliśmy też ich punkty z kolokwium (0–20). Cztery zmienne dają 6 par, czyli 6 korelacji.
- H0: w populacji korelacja danej pary zmiennych wynosi zero (\(\rho = 0\));
- H1: korelacja jest różna od zera (\(\rho \neq 0\)); poziom istotności α = 0,05, osobno dla każdej pary.
Dane i statystyki opisowe
| Osoba | Sen (h) | Nauka (h) | Stres (1–10) | Punkty (0–20) |
|---|---|---|---|---|
| 1 | 6 | 3 | 9 | 6 |
| 2 | 7 | 4 | 8 | 5 |
| 3 | 6 | 6 | 5 | 11 |
| 4 | 9 | 5 | 2 | 16 |
| 5 | 7 | 3 | 4 | 9 |
| 6 | 8 | 8 | 5 | 18 |
| 7 | 8 | 5 | 1 | 17 |
| 8 | 7 | 1 | 4 | 7 |
| 9 | 5 | 6 | 9 | 11 |
| 10 | 7 | 9 | 3 | 20 |
| M (SD) | 7,00 (1,15) | 5,00 (2,40) | 5,00 (2,83) | 12,00 (5,40) |
Sprawdzenie założeń
- Zmienne ilościowe i niezależne obserwacje: każda osoba to jeden wiersz danych.
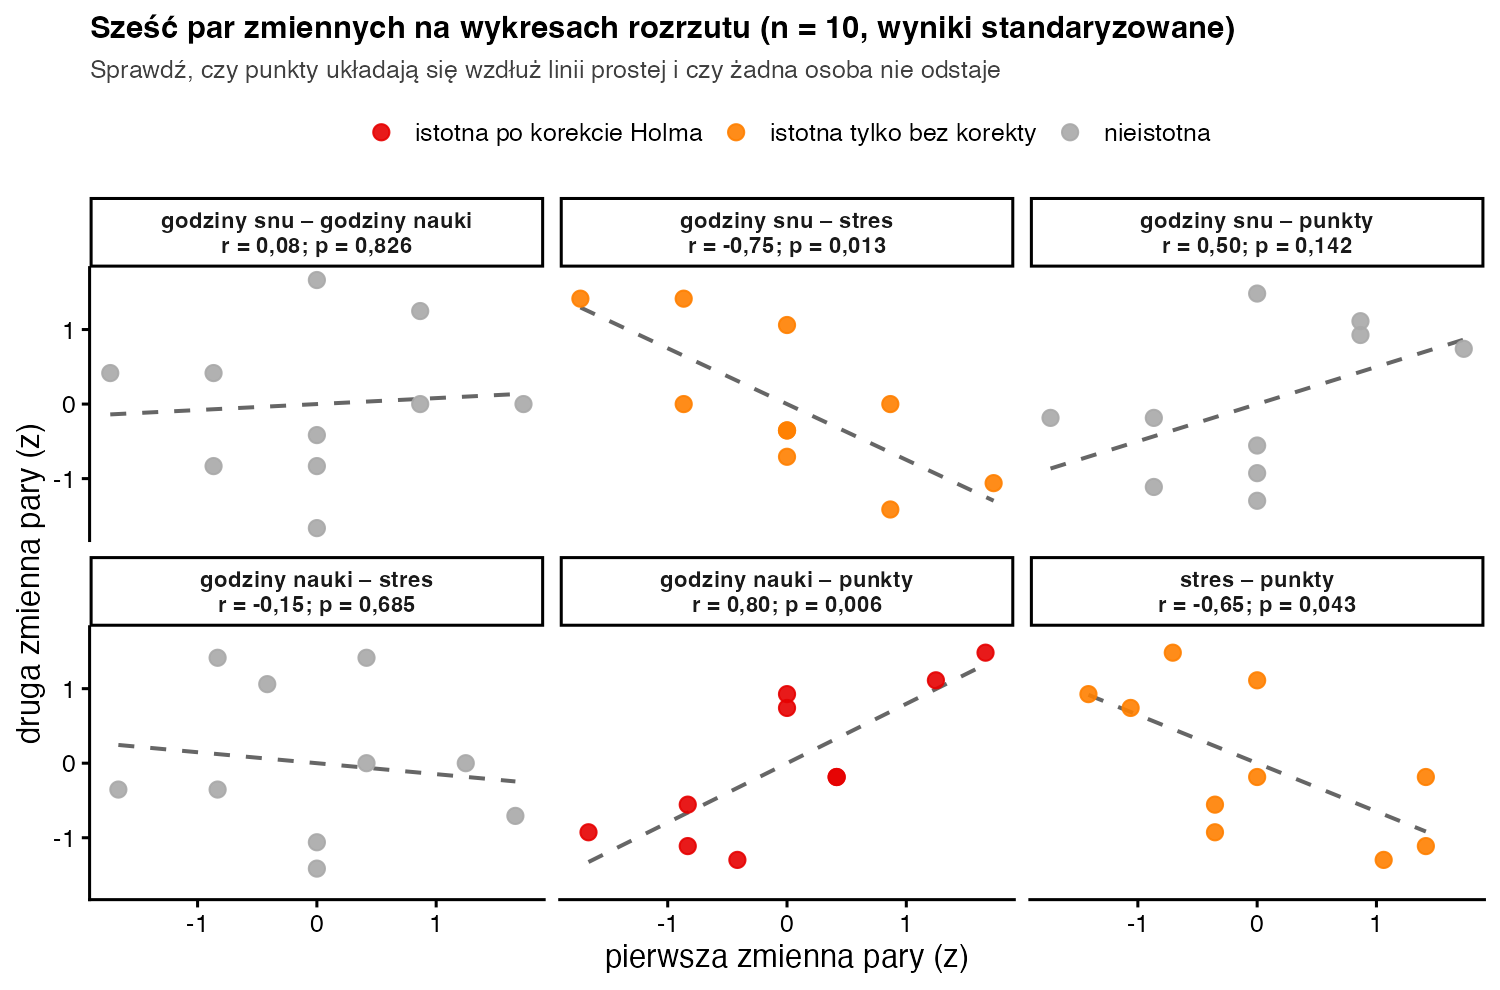
- Związek liniowy i brak skrajnych obserwacji. To oceniasz na wykresach rozrzutu (rys. 1), bo jedna nietypowa osoba potrafi wyraźnie zmienić r (Anscombe, 1973). Sprawdź też, czy wynik nie zależy od jednej osoby: usuń po kolei każdą i policz r ponownie. Dla nauki i punktów r mieści się wtedy między 0,71 a 0,84, a największa odległość Cooka wynosi 0,23 – mniej niż umowny próg 4/n = 0,40.
- Rozkłady zbliżone do normalnego – ważne dla testu istotności. Test Shapiro-Wilka dał dla czterech zmiennych p od 0,336 do 0,939.
Macierz korelacji – wynik
| Zmienna | M | SD | 1 | 2 | 3 |
|---|---|---|---|---|---|
| 1. Godziny snu | 7,00 | 1,15 | – | ||
| 2. Godziny nauki | 5,00 | 2,40 | 0,08 | – | |
| 3. Stres | 5,00 | 2,83 | −0,75* | −0,15 | – |
| 4. Punkty | 12,00 | 5,40 | 0,50 | 0,80** | −0,65* |
Pod tabelą dopisz notę: n = 10; * p < 0,05; ** p < 0,01 (bez korekty). Najsilniej z punktami wiąże się czas nauki: r = 0,80; p = 0,006; 95% CI [0,34; 0,95]. Według konwencji Cohena (1988) to związek silny. Wyższy stres idzie w parze z mniejszą liczbą punktów (r = −0,65; p = 0,043) i z krótszym snem (r = −0,75; p = 0,013). Korelacja snu z punktami (r = 0,50; p = 0,142) nie jest istotna, ale jej przedział ufności [−0,19; 0,86] pokazuje, że 10 osób to za mało, by cokolwiek rozstrzygnąć.
Korekta na wielokrotne porównania
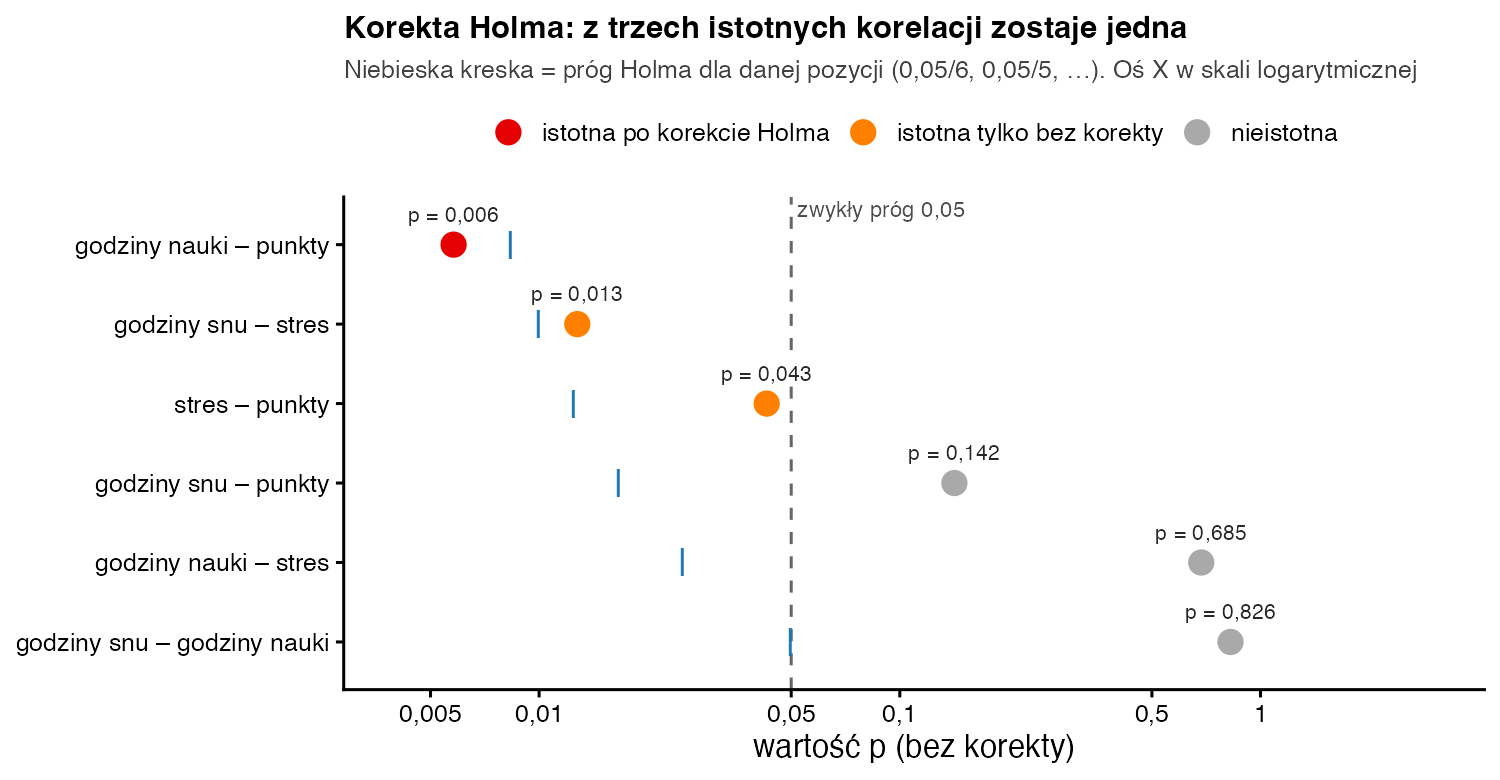
Sześć testów to sześć okazji do fałszywego alarmu. Korekta Holma (1979) zaostrza progi: najmniejsze p porównujesz z 0,05/6, następne z 0,05/5 i tak dalej. Po korekcie istotna pozostaje tylko korelacja nauki z punktami (p = 0,035). Skorygowane p wynosi dla pary sen–stres 0,064, a dla pary stres–punkty 0,171. Więcej o logice poprawek przeczytasz w haśle poprawka Bonferroniego. Jeśli hipoteza z góry dotyczyła tylko jednej pary, korekta nie jest potrzebna – napisz to w rozdziale o metodzie.
Jak opisać wynik w pracy?
Zapis w stylu APA: Liczba godzin nauki była silnie dodatnio skorelowana z liczbą punktów z kolokwium, r(8) = 0,80; p = 0,006; 95% CI [0,34; 0,95], a związek pozostał istotny po korekcie Holma. Poziom stresu był ujemnie skorelowany z punktami, r(8) = −0,65; p = 0,043, i z czasem snu, r(8) = −0,75; p = 0,013, jednak po korekcie Holma korelacje te nie były istotne. Pełną macierz korelacji przedstawia Tabela 2.
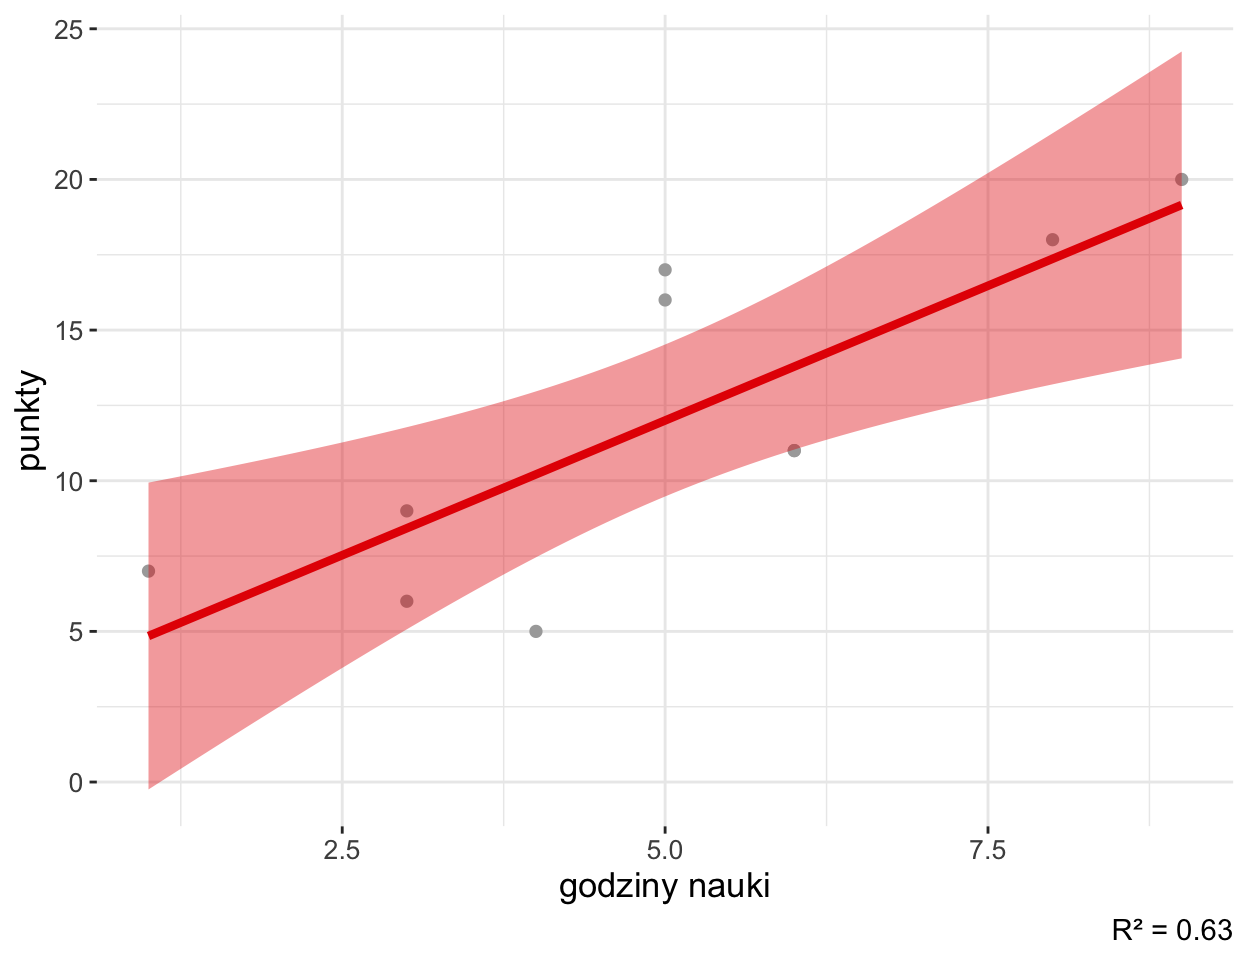
W tekście opisuj r słowami („im dłużej studenci się uczyli, tym więcej punktów zdobywali”), unikając słów „wpływa” i „powoduje”. Pod wykresem rozrzutu wyjaśnij, co oznaczają kropki, linia i pas, a w tekście odwołaj się do niego, np. „Związek ilustruje Rysunek 2”. Do wykresu wybierz parę najważniejszą dla Twojej hipotezy, a nie wszystkie sześć. Pełny raport z takiej analizy pokazuje przykładowy raport SZTOS z analizy korelacji.
Cała analiza w R
# Dane: 10 studentów
dane <- data.frame(
  sen    = c(6, 7, 6, 9, 7, 8, 8, 7, 5, 7),            # godziny snu przed kolokwium
  nauka  = c(3, 4, 6, 5, 3, 8, 5, 1, 6, 9),            # godziny nauki w tygodniu przed kolokwium
  stres  = c(9, 8, 5, 2, 4, 5, 1, 4, 9, 3),            # stres (1–10)
  punkty = c(6, 5, 11, 16, 9, 18, 17, 7, 11, 20))      # punkty z kolokwium (0–20)

# 1) statystyki opisowe i normalność rozkładów (p Shapiro-Wilka)
round(sapply(dane, function(x) c(M = mean(x), SD = sd(x), p_SW = shapiro.test(x)$p.value)), 3)

# 2) wykresy rozrzutu wszystkich par: liniowość i wartości odstające
pairs(dane)

# 3) macierz korelacji Pearsona; p bez korekty (pod przekątną) i po korekcie Holma (nad nią)
kor <- psych::corr.test(dane, method = "pearson", adjust = "holm")
round(kor$r, 2)
round(kor$p, 3)

# 4) najważniejsza para: r, test t i 95% przedział ufności
cor.test(dane$nauka, dane$punkty)

# 5) odporność: r bez każdej osoby po kolei (min i max) i największa odległość Cooka
round(range(sapply(1:10, function(i) cor(dane$nauka[-i], dane$punkty[-i]))), 2)
round(max(cooks.distance(lm(punkty ~ nauka, data = dane))), 2)
Wynik w konsoli R:
       sen nauka stres punkty
M    7.000 5.000 5.000 12.000
SD   1.155 2.404 2.828  5.395
p_SW 0.703 0.939 0.336  0.389
         sen nauka stres punkty
sen     1.00  0.08 -0.75   0.50
nauka   0.08  1.00 -0.15   0.80
stres  -0.75 -0.15  1.00  -0.65
punkty  0.50  0.80 -0.65   1.00
         sen nauka stres punkty
sen    0.000 1.000 0.064  0.425
nauka  0.826 0.000 1.000  0.035
stres  0.013 0.685 0.000  0.171
punkty 0.142 0.006 0.043  0.000

	Pearson's product-moment correlation

data:  dane$nauka and dane$punkty
t = 3.7293, df = 8, p-value = 0.005793
alternative hypothesis: true correlation is not equal to 0
95 percent confidence interval:
 0.3353954 0.9498739
sample estimates:
      cor
0.7967657

[1] 0.71 0.84
[1] 0.23
Korelacja to nie przyczynowość
Ujemna korelacja stresu ze snem nie mówi, co jest przyczyną. Stres może utrudniać zasypianie, krótki sen może zwiększać stres, a obie zmienne mogą zależeć od trzeciej, np. od zaległości przed sesją. Wniosek przyczynowy wymaga eksperymentu albo przynajmniej modelu, który kontroluje inne zmienne – zobacz regresję liniową na przykładzie.
Pytania promotora i recenzenta
Pearson czy Spearman?
Pearsona wybierz dla zmiennych ilościowych o związku liniowym, bez skrajnych obserwacji. Przy pojedynczych pytaniach na skali 1–5, wynikach odstających albo związku tylko rosnącym, a nie liniowym, lepsza jest korelacja rang – zobacz korelację Spearmana na przykładzie.
Czy nieistotne r = 0,50 oznacza brak związku?
Nie. Brak istotności przy 10 osobach oznacza, że dane nie pozwalają odróżnić związku od przypadku. W pracy podaj r z przedziałem ufności i nie pisz, że „związku nie ma”.
Bibliografia
- Pearson, K. (1895). Notes on regression and inheritance in the case of two parents. Proceedings of the Royal Society of London, 58, 240–242. https://doi.org/10.1098/rspl.1895.0041
- Holm, S. (1979). A simple sequentially rejective multiple test procedure. Scandinavian Journal of Statistics, 6(2), 65–70.
- Anscombe, F. J. (1973). Graphs in statistical analysis. The American Statistician, 27(1), 17–21. https://doi.org/10.1080/00031305.1973.10478966
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Field, A., Miles, J., & Field, Z. (2012). Discovering statistics using R. SAGE.
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówKorelacja Pearsona
- PoradnikKorelacja Spearmana – przykład
- Słownik wzorówRegresja liniowa
- PoradnikRegresja liniowa – przykład
- Przykładowy raportAnaliza korelacji
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.