

Błąd I rodzaju (α) – definicja, wzór i przykład
Błąd I rodzaju to odrzucenie hipotezy zerowej, która w rzeczywistości jest prawdziwa – statystyczny „fałszywy alarm”. Typowe pytanie z pracy dyplomowej: jak duże jest ryzyko, że mój istotny wynik to przypadek, zwłaszcza gdy wykonałem kilkanaście testów?
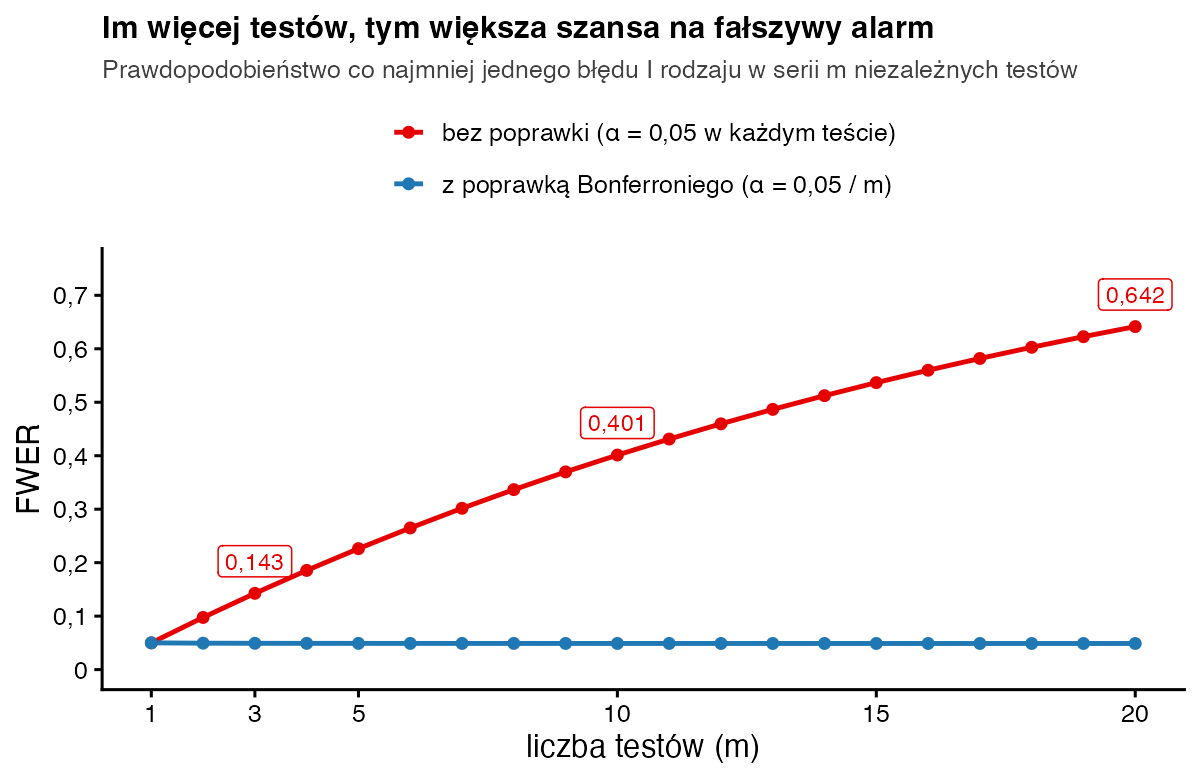
W prostych słowachWyobraź sobie czujnik dymu, który czasem wyje, choć nic się nie pali. Poziom istotności α = 0,05 to zgoda na to, że gdy żadnego efektu nie ma, test „zawyje” średnio w 5 badaniach na 100. Im więcej testów robisz, tym większa szansa, że któryś z nich da fałszywy alarm.
Kiedy myśleć o błędzie I rodzaju?
- przed badaniem ustalasz poziom istotności α – zwykle 0,05, czasem 0,01;
- wykonujesz wiele testów na tych samych danych (kilkanaście zmiennych, porównania wszystkich par grup) – wtedy ryzyko fałszywego alarmu szybko rośnie;
- opisujesz pojedynczy istotny wynik, którego nikt jeszcze nie powtórzył.
To jedna strona medalu. Drugą jest błąd II rodzaju, czyli przeoczenie prawdziwego efektu. Jak z α powstaje decyzja „istotne / nieistotne”, wyjaśnia hasło o istotności statystycznej i wartości p. Przy wielu porównaniach pomaga poprawka Bonferroniego.
| H0 prawdziwa (efektu nie ma) | H0 fałszywa (efekt jest) | |
|---|---|---|
| odrzucasz H0 | błąd I rodzaju (α) | trafna decyzja (moc = 1 − β) |
| nie odrzucasz H0 | trafna decyzja (1 − α) | błąd II rodzaju (β) |
Wzór na błąd I rodzaju
- \(\alpha\)
- prawdopodobieństwo fałszywego alarmu w jednym teście
- \(\mid H_0 \text{ prawdziwa}\)
- warunek: liczymy je w świecie, w którym efektu naprawdę nie ma
- \(m\)
- liczba wykonanych testów
- \(\text{FWER}\)
- prawdopodobieństwo co najmniej jednego fałszywego alarmu w serii m niezależnych testów
- \(\alpha_{\text{Bonf}}\)
- poziom istotności dla pojedynczego testu po poprawce Bonferroniego
Przykład krok po kroku
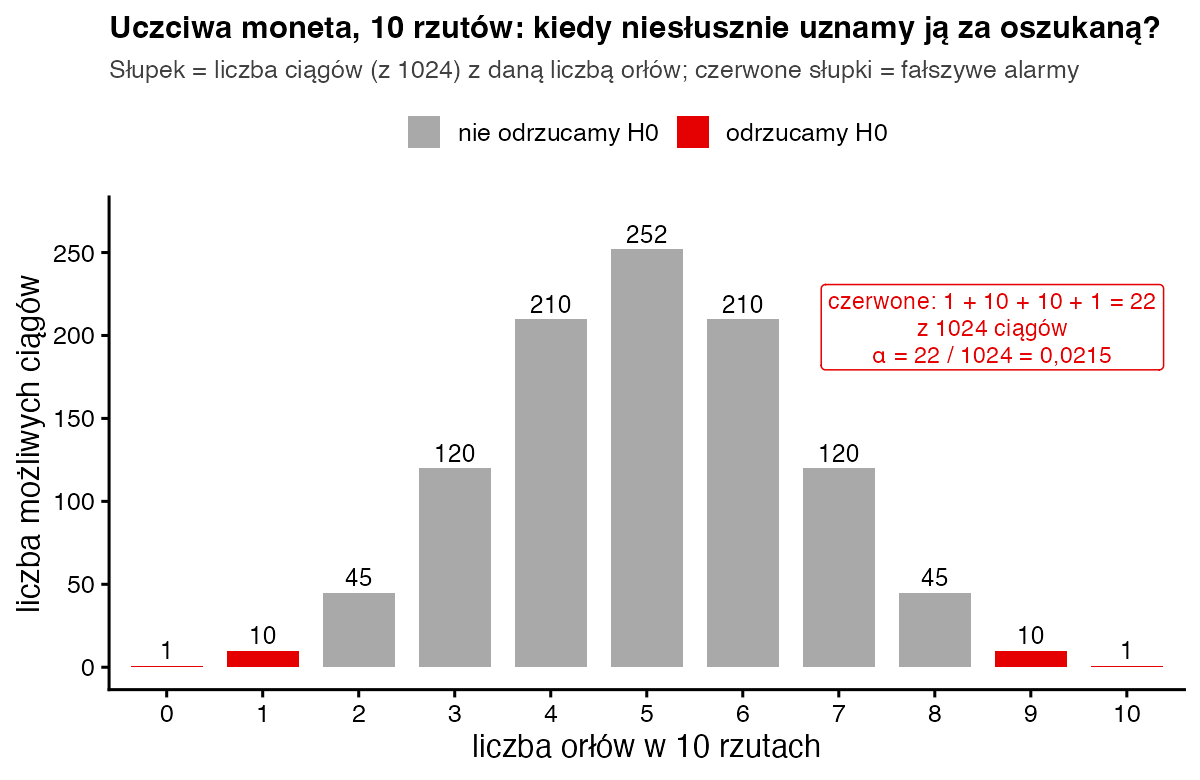
Kolega twierdzi, że jego moneta jest oszukana. Rzucasz nią 10 razy. H0: moneta jest uczciwa. Umawiasz się, że odrzucisz H0, gdy wypadnie 0, 1, 9 albo 10 orłów. Jak często taka reguła skrzywdzi uczciwą monetę?
| Liczba orłów X | Liczba ciągów C(10, X) | Prawdopodobieństwo (z 1024) |
|---|---|---|
| 0 | 1 | 0,0010 |
| 1 | 10 | 0,0098 |
| 9 | 10 | 0,0098 |
| 10 | 1 | 0,0010 |
| razem | 22 | 0,0215 |
- Wszystkie wyniki. 10 rzutów daje 2¹⁰ = 1024 równie prawdopodobne ciągi orłów i reszek.
- Obszar odrzucenia. Ciągów z 0, 1, 9 lub 10 orłami jest 1 + 10 + 10 + 1 = 22.
- Błąd I rodzaju. α = 22 / 1024 = 0,0215. Uczciwą monetę niesłusznie uznasz za oszukaną średnio w 2 seriach na 100.
- Trzy testy. Gdy wykonujesz 3 niezależne testy, każdy na poziomie 0,05: FWER = 1 − 0,95³ = 1 − 0,857 = 0,143.
- Poprawka. Bonferroni: 0,05 / 3 = 0,0167 na test. Wtedy FWER = 1 − (1 − 0,0167)³ = 0,049.
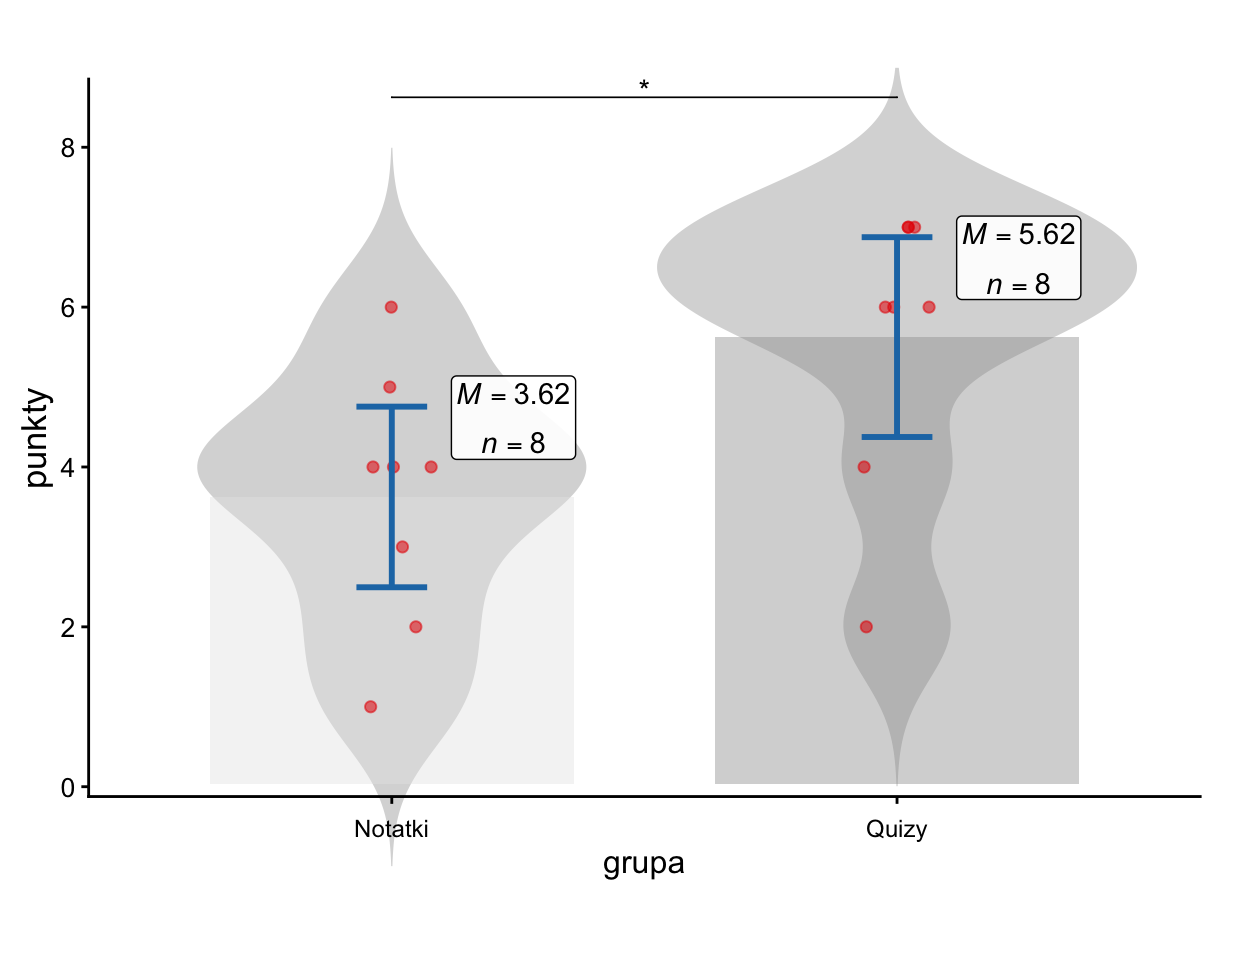
- Twoje badanie. W przykładzie Notatki i Quizy z hasła o teście t Studenta wyszło p = 0,017. Gdyby metoda nauki naprawdę nie miała znaczenia, ten wynik byłby właśnie błędem I rodzaju – z samych danych nie da się tego rozstrzygnąć.
Jak zinterpretować i opisać wynik?
α = 0,05 nie znaczy, że „istotny wynik jest fałszywy z prawdopodobieństwem 5%”. To szansa fałszywego alarmu pod warunkiem, że efektu nie ma. Jak często istotne wyniki okazują się fałszywe, zależy też od mocy badania i od tego, jak często badane efekty istnieją (Greenland i in., 2016). W metodzie pracy podaj przyjęte α, liczbę testów i ewentualną poprawkę, a przy wynikach – dokładne p.
Zapis w stylu APA: Przyjęto poziom istotności α = 0,05. Ponieważ porównano trzy pary grup, zastosowano poprawkę Bonferroniego, uznając za istotne wyniki z p < 0,0167 (0,05 / 3).
Jak policzyć błąd I rodzaju w R?
# 1) moneta: 10 rzutów, odrzucamy H0 („moneta uczciwa”), gdy orłów jest 0, 1, 9 lub 10
uklady <- choose(10, c(0, 1, 9, 10))
uklady                                    # liczba ciągów z danym wynikiem
sum(uklady) / 2^10                        # alfa = 22 / 1024
sum(dbinom(c(0, 1, 9, 10), 10, 0.5))      # to samo z rozkładu dwumianowego

# 2) wiele testów: szansa co najmniej jednego fałszywego alarmu (FWER)
m <- c(1, 3, 10, 20)
round(data.frame(m, FWER = 1 - (1 - 0.05)^m,
                 Bonferroni = 1 - (1 - 0.05 / m)^m), 3)

# 3) symulacja: 10 000 testów t, gdy H0 jest prawdziwa
set.seed(1)
p <- replicate(10000, t.test(rnorm(8, 5, 2), rnorm(8, 5, 2))$p.value)
mean(p < 0.05)                            # odsetek fałszywych alarmów
Wynik w konsoli R:
[1]  1 10 10  1
[1] 0.02148438
[1] 0.02148437
   m  FWER Bonferroni
1  1 0.050      0.050
2  3 0.143      0.049
3 10 0.401      0.049
4 20 0.642      0.049
[1] 0.0467
Ostatnia liczba to wynik symulacji: gdy H0 jest prawdziwa, około 5% testów (tu 4,7%) daje p < 0,05.
Błąd I i II rodzaju – jak zapamiętać różnicę?
Błąd I rodzaju to „widzę efekt, którego nie ma” (fałszywy alarm, wynik fałszywie dodatni). Błąd II rodzaju to „nie widzę efektu, który jest” (przeoczenie). Oba ryzyka są ze sobą powiązane: gdy przy tej samej liczbie osób zmniejszysz α z 0,05 do 0,01, rzadziej podniesiesz fałszywy alarm, ale częściej przeoczysz prawdziwy efekt. Najprostszym sposobem, by zmniejszyć oba ryzyka naraz, jest większa próba (pomaga też dokładniejszy pomiar).
Najczęstsze błędy
- Mylenie α z prawdopodobieństwem, że odrzucona H0 była prawdziwa.
- Wykonywanie wielu testów bez poprawki i opisywanie tylko tych istotnych (Simmons i in., 2011).
- Zmiana α albo przejście na test jednostronny dopiero po zobaczeniu danych.
- Przekonanie, że im mniejsze α, tym zawsze lepiej – rośnie wtedy ryzyko błędu II rodzaju.
- Traktowanie pojedynczego istotnego wyniku jako dowodu ostatecznego zamiast wyniku do powtórzenia.
Bibliografia
- Neyman, J., & Pearson, E. S. (1933). On the problem of the most efficient tests of statistical hypotheses. Philosophical Transactions of the Royal Society of London. Series A, 231, 289–337. https://doi.org/10.1098/rsta.1933.0009
- Greenland, S., Senn, S. J., Rothman, K. J., Carlin, J. B., Poole, C., Goodman, S. N., & Altman, D. G. (2016). Statistical tests, P values, confidence intervals, and power: A guide to misinterpretations. European Journal of Epidemiology, 31(4), 337–350. https://doi.org/10.1007/s10654-016-0149-3
- Simmons, J. P., Nelson, L. D., & Simonsohn, U. (2011). False-positive psychology: Undisclosed flexibility in data collection and analysis allows presenting anything as significant. Psychological Science, 22(11), 1359–1366. https://doi.org/10.1177/0956797611417632
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówBłąd II rodzaju (β) i moc testu
- Słownik wzorówIstotność statystyczna i wartość p
- Słownik wzorówPoprawka Bonferroniego
- PoradnikTest statystyczny – na czym polega
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.