

Istotność statystyczna i wartość p – wzór i przykład
Istotność statystyczna to umowna decyzja: wynik uznajemy za istotny, gdy wartość p jest mniejsza lub równa przyjętemu poziomowi α (najczęściej 0,05). Typowe pytanie z pracy dyplomowej: czy studenci uczący się z quizów naprawdę wypadają lepiej niż ci, którzy uczą się z notatek, czy różnica mogła wyjść przypadkiem?
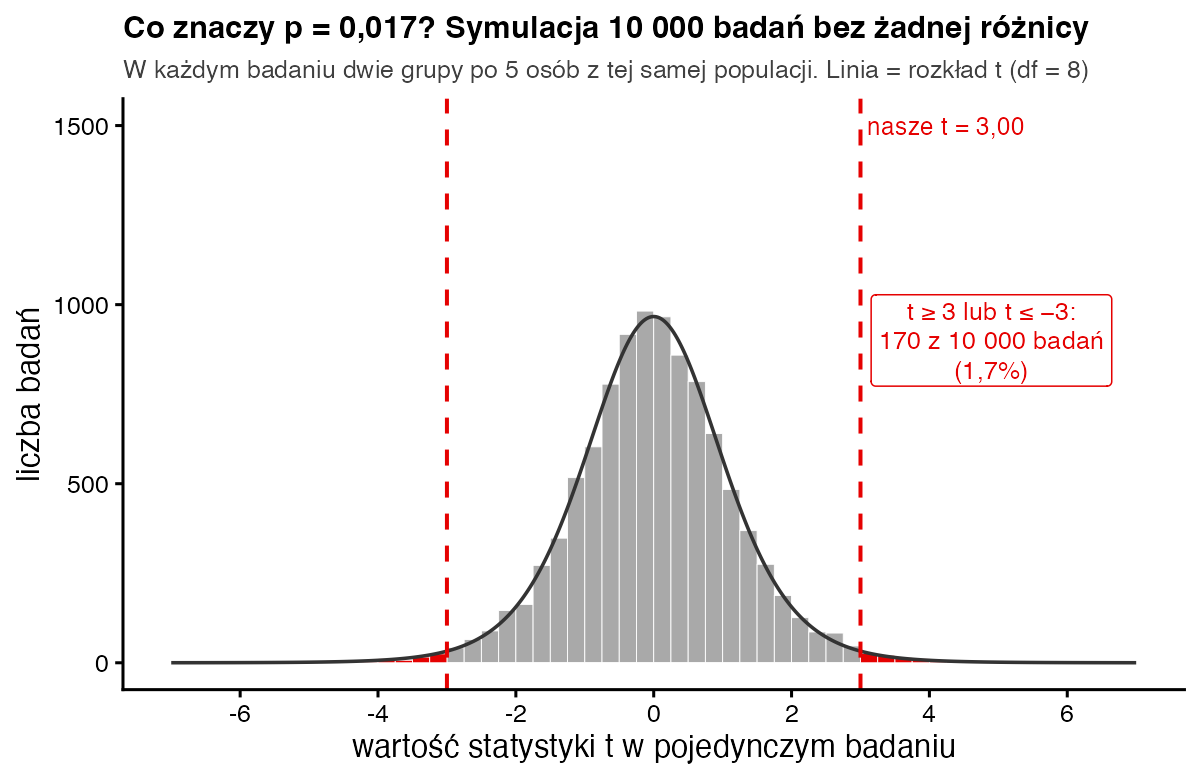
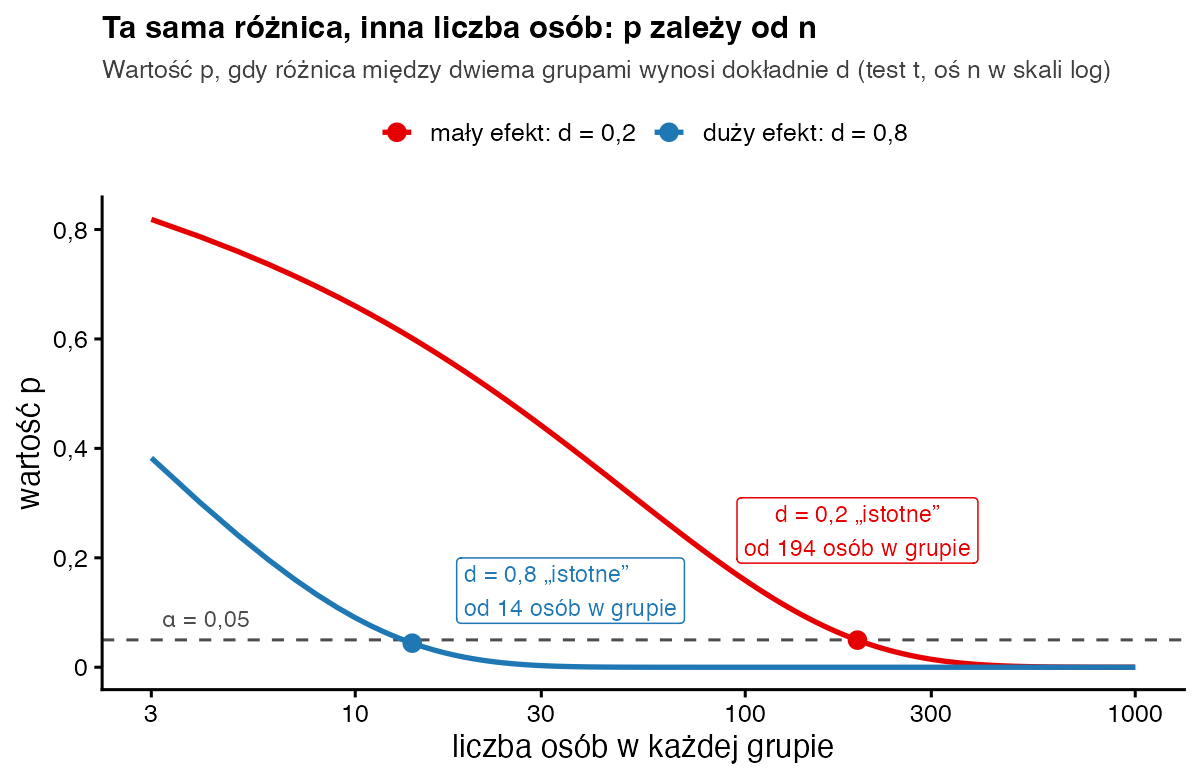
W prostych słowachWartość p odpowiada na pytanie: jak często dostalibyśmy taki wynik albo jeszcze bardziej skrajny, gdyby naprawdę nie było żadnej różnicy? Małe p oznacza, że w świecie „bez różnicy” nasz wynik byłby rzadki, więc dane słabo pasują do takiego świata. Istotność nie mówi jednak, czy różnica jest duża ani czy ma znaczenie w praktyce.
Kiedy mówimy o istotności statystycznej?
- stawiasz hipotezę zerową H0 (brak różnicy lub związku) i hipotezę alternatywną H1;
- przed zebraniem danych ustalasz poziom istotności α (zwykle 0,05) i decydujesz, czy test jest dwustronny (różnica w dowolną stronę), czy jednostronny;
- liczysz test statystyczny (t, U, chi-kwadrat, F), a program podaje wartość p;
- porównujesz p z α i opisujesz decyzję razem z wielkością efektu.
Poziom α to Twoja zgoda na ryzyko błędu I rodzaju, czyli „fałszywego alarmu”. Ryzyko przeoczenia prawdziwego efektu opisuje błąd II rodzaju i moc testu. Całą procedurę opisujemy w tekście o weryfikacji hipotez w pracy magisterskiej.
Wzór na wartość p
- \(t_{\text{obs}}\)
- statystyka testu policzona z Twoich danych (tu: t z testu t Studenta)
- \(T_{df}\)
- statystyka, jaką dawałyby kolejne badania, gdyby H0 była prawdziwa; ma rozkład t o df stopniach swobody
- \(\mid H_0\)
- „przy założeniu, że H0 jest prawdziwa” – p liczymy w świecie bez różnicy
- \(2 \cdot\)
- test dwustronny: dodajemy pola obu ogonów rozkładu
- \(\alpha\)
- poziom istotności ustalony przed badaniem, najczęściej 0,05
Sama istotność nie ma osobnego wzoru – to decyzja „p ≤ α”.
Przykład krok po kroku
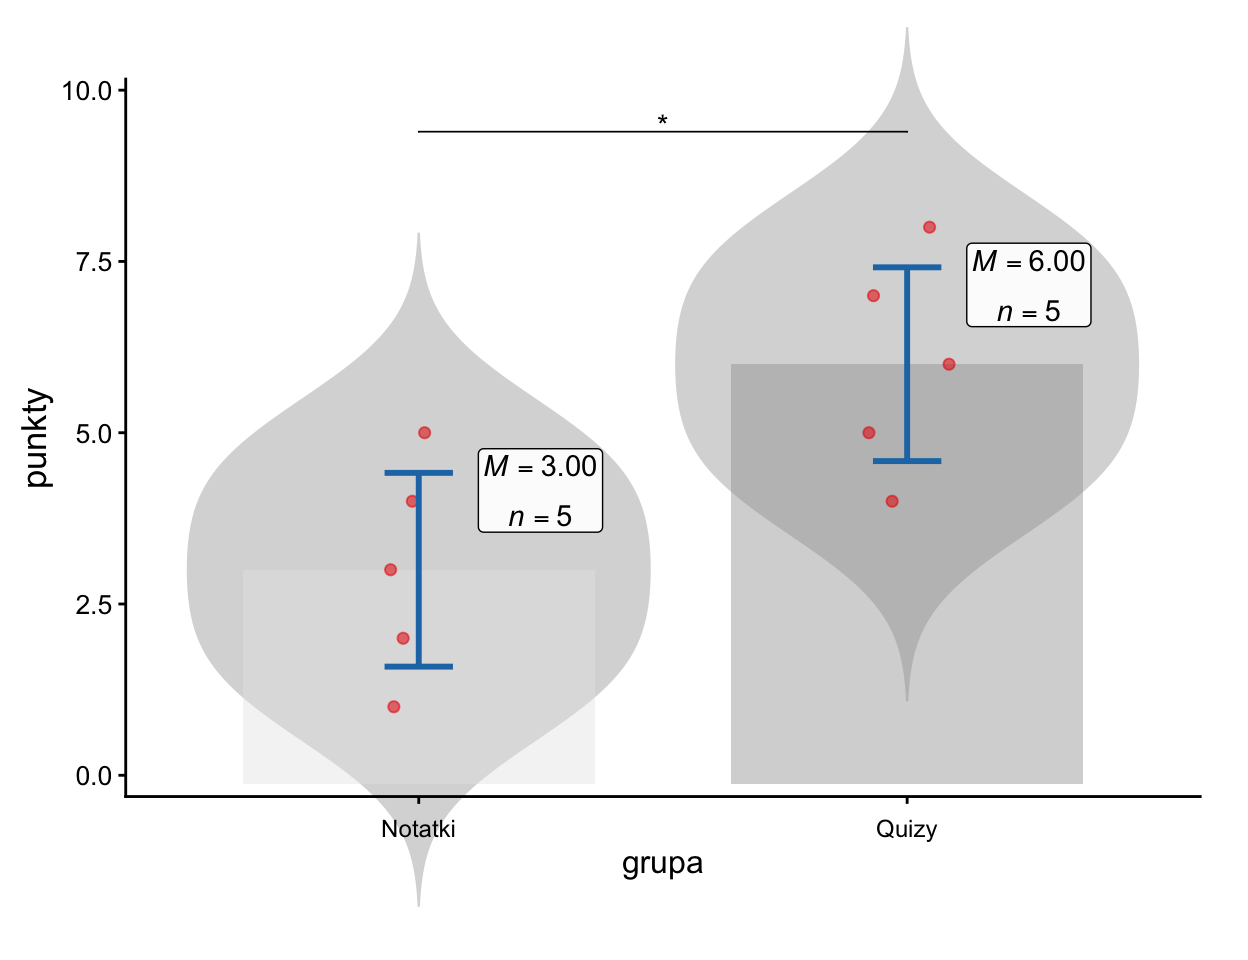
Wracamy do danych z hasła o teście t Studenta. Notatki: 1, 2, 3, 4, 5 punktów. Quizy: 4, 5, 6, 7, 8 punktów. Test dał t = 3,00 przy df = 8. Tabela pokazuje, jak z wartości t powstaje p.
| t | pole jednego ogona | p dwustronne | decyzja |
|---|---|---|---|
| 1,00 | 0,173 | 0,347 | nie odrzucamy H0 |
| 2,00 | 0,040 | 0,081 | nie odrzucamy H0 |
| 2,306 | 0,025 | 0,050 | granica (wartość krytyczna) |
| 3,00 (nasz wynik) | 0,0085 | 0,017 | odrzucamy H0 |
| 4,00 | 0,002 | 0,004 | odrzucamy H0 |
- Hipotezy. H0: średnie w populacji są równe. H1: są różne. Ustalamy α = 0,05 i test dwustronny.
- Statystyka. t = (6 − 3) / 1 = 3,00; df = 5 + 5 − 2 = 8.
- Jeden ogon. Pole pod krzywą rozkładu t(8) na prawo od 3,00 wynosi 0,0085 (z programu lub tablic).
- Dwa ogony. p = 2 · 0,0085 = 0,017, bo równie „dziwny” byłby wynik t = −3,00.
- Decyzja. 0,017 ≤ 0,05, więc odrzucamy H0. To samo widać bez p: t = 3,00 jest dalej od zera niż wartość krytyczna 2,306.
- Wielkość efektu. d Cohena = 1,90, a 95% przedział ufności dla różnicy średnich obejmuje od 0,69 do 5,31 punktu.
Jak zinterpretować i opisać wynik?
Poprawny opis brzmi tak: „Gdyby metoda nauki nie miała znaczenia, różnicę tak dużą lub większą otrzymalibyśmy w około 1,7% podobnych badań”. Niepoprawne jest zdanie „prawdopodobieństwo, że H0 jest prawdziwa, wynosi 1,7%”. Wartość p nie mówi też, jak duża jest różnica. Do tego służą wielkość efektu (umownie d = 0,2 to efekt mały, 0,5 – średni, 0,8 – duży; Cohen, 1988) i przedział ufności (Wasserstein i Lazar, 2016). Podawaj dokładne p z trzema miejscami po przecinku. Zamiast „p = 0,000” pisz „p < 0,001”.
Zapis w stylu APA: Studenci uczący się z quizów (M = 6,00; SD = 1,58) uzyskali istotnie więcej punktów niż studenci uczący się z notatek (M = 3,00; SD = 1,58), t(8) = 3,00; p = 0,017; d = 1,90; 95% CI różnicy [0,69; 5,31].
Jak policzyć wartość p w R?
notatki <- c(1, 2, 3, 4, 5)
quizy   <- c(4, 5, 6, 7, 8)

# 1) „ręcznie”: statystyka t, a potem pole dwóch ogonów rozkładu t
t  <- (mean(quizy) - mean(notatki)) / sqrt(var(quizy)/5 + var(notatki)/5)
df <- 5 + 5 - 2
p  <- 2 * pt(-abs(t), df)             # p dwustronne
c(t = t, df = df, p = p)
qt(0.975, df)                         # wartość krytyczna dla alfa = 0.05
p <= 0.05                             # TRUE = wynik istotny statystycznie

# 2) gotową funkcją
t.test(quizy, notatki, var.equal = TRUE)$p.value

# 3) co znaczy p? 10 000 badań, w których H0 jest prawdziwa
set.seed(2026)
t_sym <- replicate(10000, t.test(rnorm(5), rnorm(5), var.equal = TRUE)$statistic)
mean(abs(t_sym) >= 3)                 # odsetek wyników co najmniej tak skrajnych
Wynik w konsoli R:
         t         df          p
3.00000000 8.00000000 0.01707168
[1] 2.306004
[1] TRUE
[1] 0.01707168
[1] 0.017
Część 3 kodu to symulacja z rysunku 1: gdy H0 jest prawdziwa, około 1,7% badań daje wynik tak skrajny jak nasz.
Wynik p = 0,06 – czy to „prawie istotne”?
Jeśli przed badaniem przyjąłeś α = 0,05, to p = 0,06 oznacza brak podstaw do odrzucenia H0. Nie nazywaj tego „trendem” ani „wynikiem prawie istotnym”. Nie zmieniaj też α ani testu po zobaczeniu danych. Napisz dokładne p, podaj wielkość efektu z przedziałem ufności i dodaj, że przy tej liczbie osób badanie mogło mieć za małą moc. Brak istotności nie dowodzi, że różnicy nie ma.
Najczęstsze błędy
- Traktowanie p jako prawdopodobieństwa, że H0 jest prawdziwa. Tymczasem p liczymy przy założeniu, że H0 jest prawdziwa.
- Pisanie „przyjęto H0”, gdy p > 0,05. Poprawnie: „brak podstaw do odrzucenia H0”.
- Utożsamianie istotności z ważnością – przy tysiącach osób nawet drobna różnica bywa istotna.
- Raportowanie „p = 0,000” albo samego „p < 0,05” zamiast dokładnej wartości.
- Liczenie wielu testów bez poprawki (np. Bonferroniego) i opisywanie tylko tego jednego „istotnego”.
Bibliografia
- Fisher, R. A. (1925). Statistical methods for research workers. Oliver and Boyd.
- Neyman, J., & Pearson, E. S. (1933). On the problem of the most efficient tests of statistical hypotheses. Philosophical Transactions of the Royal Society of London. Series A, 231, 289–337. https://doi.org/10.1098/rsta.1933.0009
- Wasserstein, R. L., & Lazar, N. A. (2016). The ASA statement on p-values: Context, process, and purpose. The American Statistician, 70(2), 129–133. https://doi.org/10.1080/00031305.2016.1154108
- Greenland, S., Senn, S. J., Rothman, K. J., Carlin, J. B., Poole, C., Goodman, S. N., & Altman, D. G. (2016). Statistical tests, P values, confidence intervals, and power: A guide to misinterpretations. European Journal of Epidemiology, 31(4), 337–350. https://doi.org/10.1007/s10654-016-0149-3
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówBłąd I rodzaju (α)
- Słownik wzorówBłąd II rodzaju (β) i moc testu
- Słownik wzorówPrzedział ufności dla średniej
- Słownik wzorówd Cohena – wielkość efektu
- PoradnikWeryfikacja hipotez w pracy magisterskiej
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.