

Test statystyczny – na czym polega?
Test statystyczny to reguła decyzji: porównujesz wynik z próby z rozkładem, jaki miałaby statystyka testowa przy prawdziwej hipotezie zerowej, i na tej podstawie odrzucasz H0 albo nie. Typowe pytanie z pracy dyplomowej: co właściwie znaczy „wynik istotny statystycznie” i jak to poprawnie zapisać?
W prostych słowachZakładasz na próbę, że efektu nie ma. Sprawdzasz, jak wyglądałyby wyniki w takim świecie. Jeśli Twój wynik byłby w nim bardzo rzadki, odrzucasz założenie „efektu nie ma”. Test nie mówi, jak duży jest efekt, ani nie dowodzi, że Twoja hipoteza jest prawdziwa.
Elementy testu statystycznego
Przykład: pięcioro studentów uczyło się z notatek (1, 2, 3, 4, 5 punktów), a pięcioro z quizów (4, 5, 6, 7, 8 punktów). Czy metoda nauki ma znaczenie?
| Element | Co to jest | W przykładzie |
|---|---|---|
| hipoteza zerowa H0 | brak różnicy lub związku w populacji | średnie punkty po obu metodach są równe |
| hipoteza alternatywna H1 | to, czego szukasz | średnie są różne (test dwustronny) |
| statystyka testowa | jedna liczba podsumowująca dane | różnica średnich = 3 punkty; t = 3,00 |
| rozkład przy H0 | jakie wartości przyjmuje statystyka, gdy H0 jest prawdziwa | rozkład t z 8 stopniami swobody albo rozkład z tasowania etykiet |
| poziom istotności α | zgoda na ryzyko fałszywego alarmu, ustalona przed badaniem | 0,05 |
| wartość p | prawdopodobieństwo wyniku co najmniej tak skrajnego, gdy H0 jest prawdziwa | 0,017 |
| decyzja | odrzucasz H0, gdy p ≤ α | odrzucamy H0 |
Uwaga na częsty błąd: test nie „ocenia prawdopodobieństwa zdarzenia” ani hipotezy. Wartość p liczymy przy założeniu, że H0 jest prawdziwa, więc nie może mówić, jak prawdopodobna jest sama H0 (Wasserstein i Lazar, 2016; Greenland i in., 2016). Te same kroki powtarzają się w każdym teście – t, U, chi-kwadrat czy F. Zmienia się tylko statystyka i jej rozkład przy H0.
Rozkład statystyki przy H0 – symulacja
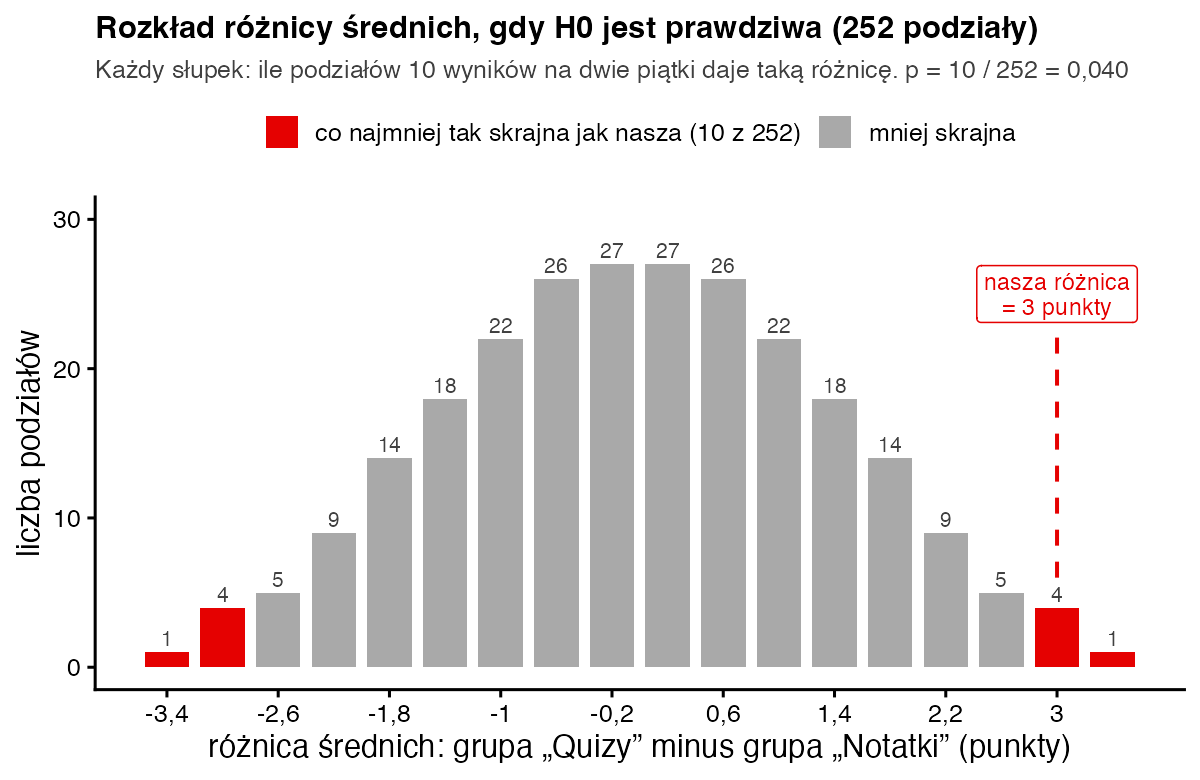
Gdyby metoda nauki nie miała znaczenia, etykiety „Notatki” i „Quizy” byłyby przypadkowe. Możesz więc tasować je wiele razy i patrzeć, jakie różnice średnich wychodzą. Dziesięć wyników da się podzielić na dwie piątki na 252 sposoby. Tylko w 10 z nich różnica jest co najmniej tak duża jak nasze 3 punkty (w dowolną stronę), więc p = 10 / 252 = 0,040. Ten pomysł pochodzi od Fishera (1935) i nazywa się testem permutacyjnym.
Dwa podejścia, ta sama decyzja
Klasyczny test t Studenta zamiast tasowania korzysta z gotowego rozkładu t. Daje t(8) = 3,00 i p = 0,017, a wartość krytyczna dla α = 0,05 wynosi 2,306. Test permutacyjny daje p = 0,040, a jego przybliżenie z 10 000 losowych przetasowań – 0,037. Wartości p się różnią, bo różne są rozkłady odniesienia, ale decyzja jest ta sama: odrzucamy H0.
Błędy I i II rodzaju i moc testu
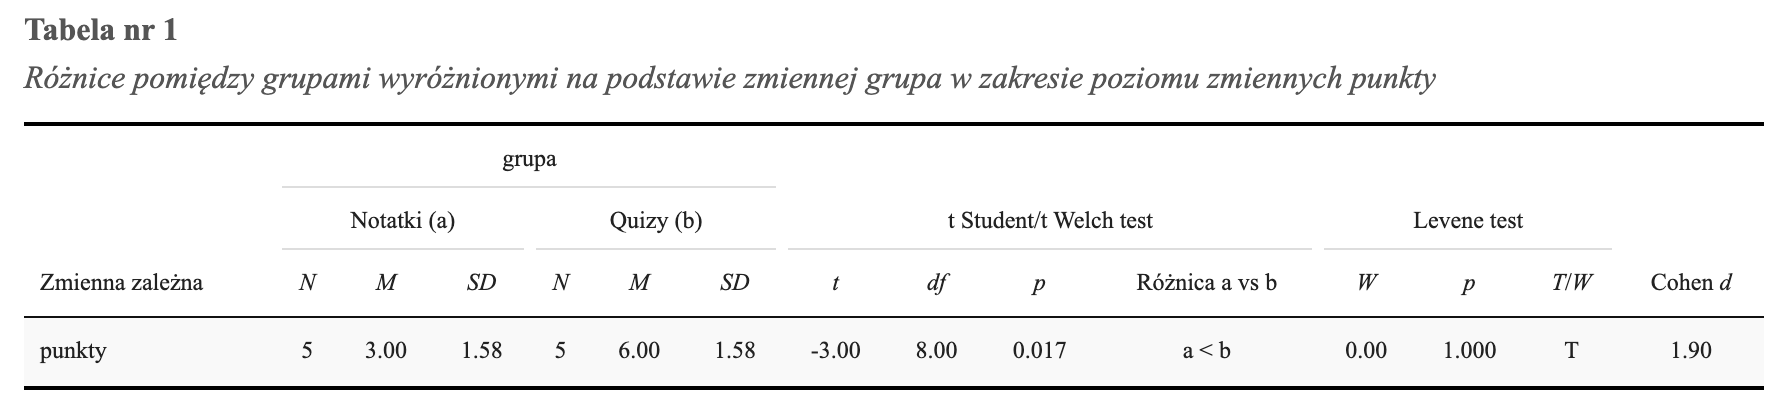
Test może się pomylić na dwa sposoby. Błąd I rodzaju to odrzucenie prawdziwej H0, czyli fałszywy alarm; jego ryzyko to α. Błąd II rodzaju to nieodrzucenie fałszywej H0, czyli przeoczenie efektu; jego ryzyko to β. Moc testu, 1 − β, to szansa wykrycia efektu, który naprawdę istnieje (Neyman i Pearson, 1933). Oba ryzyka są ze sobą powiązane. Gdy przy tej samej liczbie osób zmniejszysz α z 0,05 do 0,01, rzadziej podniesiesz fałszywy alarm, ale częściej przeoczysz prawdziwy efekt. Oba ryzyka naraz zmniejsza dopiero większa próba, dlatego jej wielkość planuje się przed badaniem.
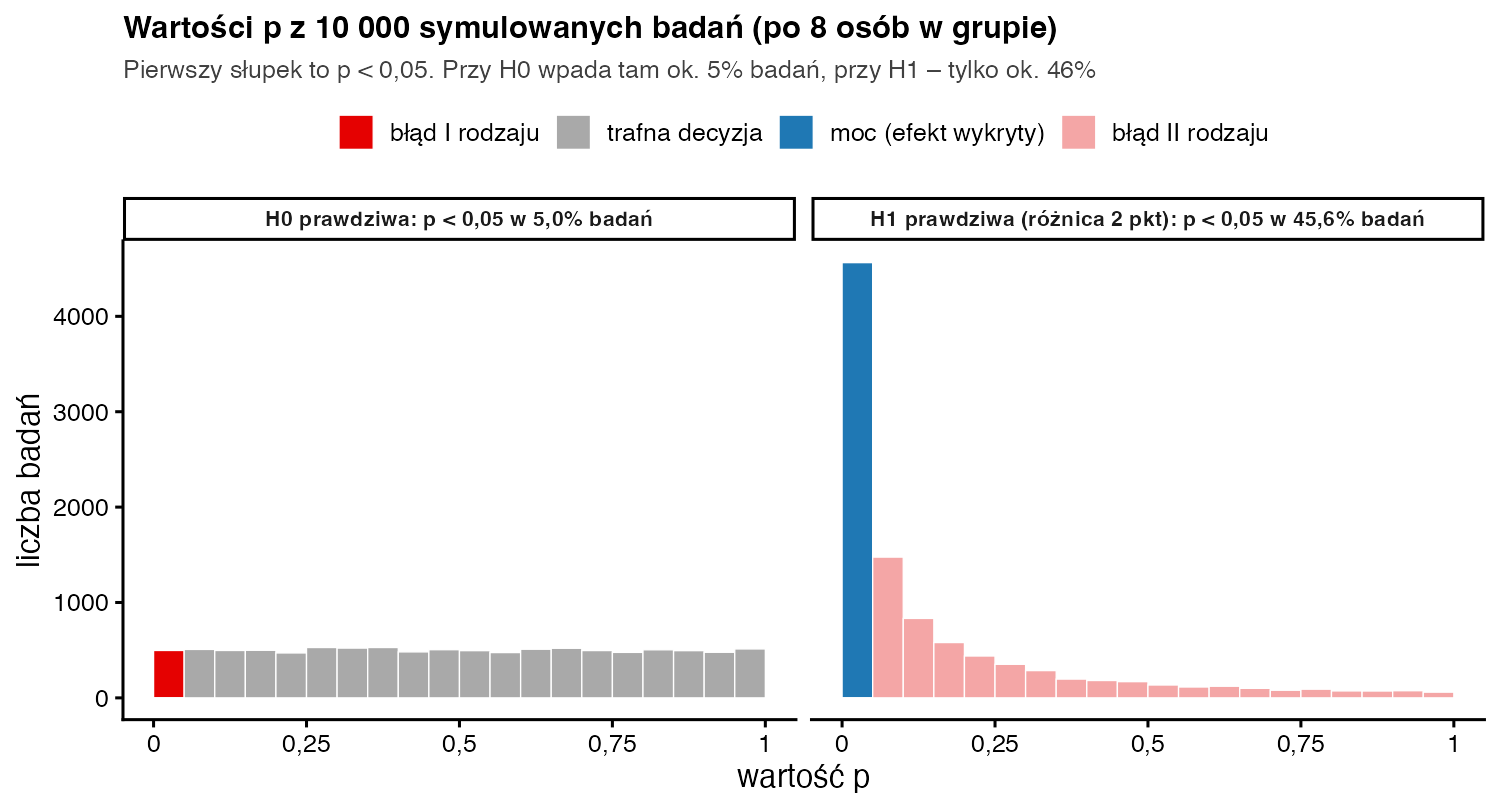
Zapis w stylu APA: Studenci uczący się z quizów (M = 6,00; SD = 1,58) uzyskali istotnie więcej punktów niż studenci uczący się z notatek (M = 3,00; SD = 1,58), t(8) = 3,00; p = 0,017; d = 1,90. Test permutacyjny dał zgodny wynik, p = 0,040.
Jak przeprowadzić test statystyczny w R?
notatki <- c(1, 2, 3, 4, 5); quizy <- c(4, 5, 6, 7, 8)    # punkty z kolokwium
punkty  <- c(notatki, quizy)
roznica <- mean(quizy) - mean(notatki)                   # statystyka testowa: 3 punkty

# H0: metoda nauki nie ma znaczenia, więc etykiety grup są przypadkowe.
# Symulacja rozkładu przy H0: 10 000 razy tasujemy etykiety i liczymy różnicę średnich
set.seed(2026)
pod_H0 <- replicate(10000, {
  g <- sample(punkty)
  mean(g[6:10]) - mean(g[1:5])
})
mean(abs(pod_H0) >= roznica)                             # p z symulacji

# Dokładnie: wszystkie podziały 10 osób na dwie piątki
podzialy  <- combn(10, 5)
wszystkie <- apply(podzialy, 2, function(i) mean(punkty[-i]) - mean(punkty[i]))
c(podzialow = length(wszystkie), skrajnych = sum(abs(wszystkie) >= roznica),
  p = mean(abs(wszystkie) >= roznica))

# Klasycznie: rozkład t Studenta przy H0
t.test(quizy, notatki, var.equal = TRUE)
qt(0.975, df = 8)                                        # wartość krytyczna dla alfa = 0,05
Wynik w konsoli R:
[1] 0.0369
   podzialow    skrajnych            p
252.00000000  10.00000000   0.03968254

	Two Sample t-test

data:  quizy and notatki
t = 3, df = 8, p-value = 0.01707
alternative hypothesis: true difference in means is not equal to 0
95 percent confidence interval:
 0.6939959 5.3060041
sample estimates:
mean of x mean of y
        6         3

[1] 2.306004
Test jednostronny czy dwustronny?
Test dwustronny szuka różnicy w obie strony i jest bezpiecznym wyborem domyślnym. Jednostronny ma sens tylko wtedy, gdy kierunek hipotezy zapisałeś przed zebraniem danych, a wynik w przeciwną stronę nie miałby dla Ciebie znaczenia. Zmiana na test jednostronny po zobaczeniu wyników, żeby zmieścić się pod 0,05, to błąd. Który test wybrać do Twoich danych, podpowiada mapa metod statystycznych, a procedurę w pracy dyplomowej – wpis weryfikacja hipotez w pracy magisterskiej.
Najczęstsze błędy
- Traktowanie p jako prawdopodobieństwa, że H0 jest prawdziwa.
- Pisanie „przyjmujemy H0” zamiast „brak podstaw do odrzucenia H0”.
- Mylenie istotności statystycznej z wielkością efektu.
- Ustalanie α albo kierunku testu po zobaczeniu danych.
- Uogólnianie istotnego wyniku z próby wygodnej na całą populację – o tym decyduje dobór próby, a nie p.
Bibliografia
- Fisher, R. A. (1935). The design of experiments. Oliver and Boyd.
- Neyman, J., & Pearson, E. S. (1933). On the problem of the most efficient tests of statistical hypotheses. Philosophical Transactions of the Royal Society of London. Series A, 231, 289–337. https://doi.org/10.1098/rsta.1933.0009
- Wasserstein, R. L., & Lazar, N. A. (2016). The ASA statement on p-values: Context, process, and purpose. The American Statistician, 70(2), 129–133. https://doi.org/10.1080/00031305.2016.1154108
- Greenland, S., Senn, S. J., Rothman, K. J., Carlin, J. B., Poole, C., Goodman, S. N., & Altman, D. G. (2016). Statistical tests, P values, confidence intervals, and power: A guide to misinterpretations. European Journal of Epidemiology, 31(4), 337–350. https://doi.org/10.1007/s10654-016-0149-3
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówIstotność statystyczna i wartość p
- Słownik wzorówBłąd I rodzaju (α)
- Słownik wzorówBłąd II rodzaju (β) i moc testu
- PoradnikWeryfikacja hipotez w pracy magisterskiej
- PoradnikAnaliza statystyczna – co to jest
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.