

Test t Studenta dla prób niezależnych – wzór i przykład
Test t Studenta dla prób niezależnych sprawdza, czy średnie w dwóch różnych grupach osób różnią się bardziej, niż mogłyby się różnić przez czysty przypadek. Typowe pytanie z pracy dyplomowej: czy studenci uczący się z quizów zdobywają więcej punktów niż ci, którzy uczą się z notatek?
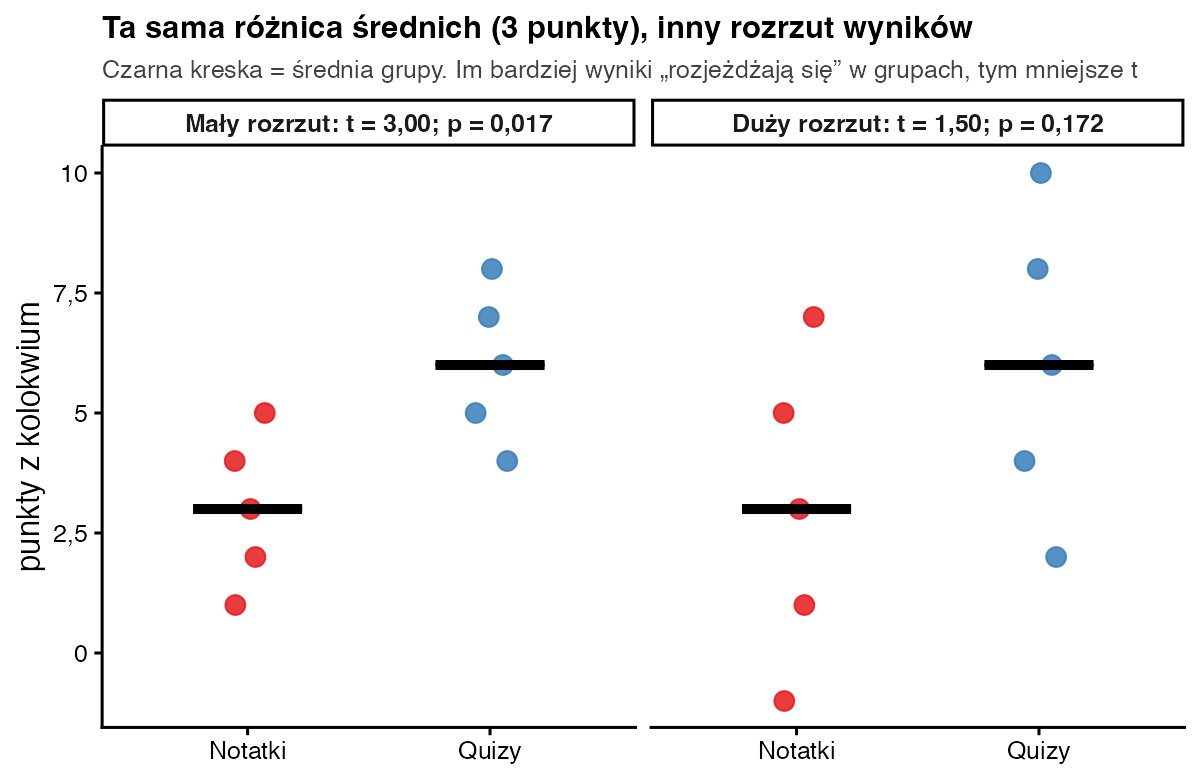
W prostych słowacht = różnica średnich ÷ „szum”. Licznik mówi, o ile grupy się różnią. Mianownik mówi, o ile ta różnica mogłaby się wahać, gdybyśmy zbadali inne osoby. Im dalej t od zera (w plus lub w minus), tym trudniej uznać różnicę za przypadek.
Kiedy stosować test t dla prób niezależnych?
- porównujesz dwie grupy różnych osób (np. kobiety i mężczyzn, grupę eksperymentalną i kontrolną);
- zmienna zależna jest ilościowa (punkty, czas, wynik skali);
- wyniki w każdej grupie mają rozkład zbliżony do normalnego – przy kilkudziesięciu osobach w grupie test jest na to dość odporny;
- rozrzut wyników w grupach jest podobny – jeśli nie jest, wybierz test t Welcha (podobieństwo wariancji sprawdzisz testem Levene’a).
Gdy te same osoby mierzysz dwa razy (przed i po), potrzebujesz testu t dla prób zależnych. Gdy wyniki są porządkowe albo bardzo skośne – testu U Manna-Whitneya.
Wzór na test t dla prób niezależnych
- \(\bar{x}_1,\ \bar{x}_2\)
- średnie w grupie 1 i w grupie 2 (zobacz: średnia arytmetyczna)
- \(s_1^2,\ s_2^2\)
- wariancje w grupach, czyli kwadraty odchyleń standardowych
- \(s_p^2\)
- wariancja połączona – „uśredniony” rozrzut wyników obu grup
- \(n_1,\ n_2\)
- liczba osób w każdej grupie
- \(df = n_1 + n_2 - 2\)
- stopnie swobody – potrzebne, żeby odczytać wartość p
Przykład krok po kroku
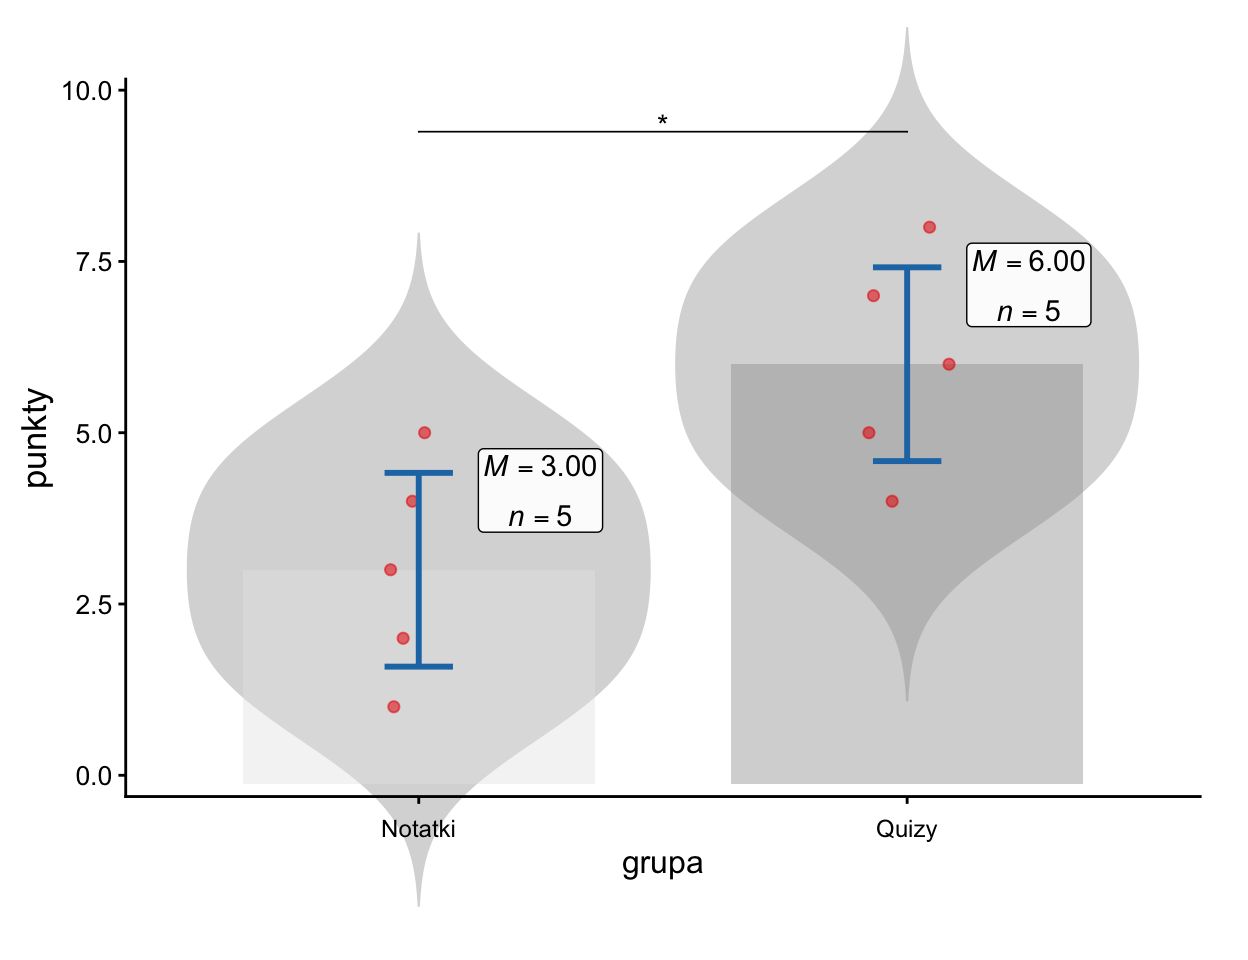
Pięcioro studentów uczyło się z notatek, a pięcioro z quizów. Oto ich punkty z kolokwium (skala 0–10) i odchylenia od średniej grupy:
| Notatki x | x − 3 | (x − 3)² | Quizy x | x − 6 | (x − 6)² |
|---|---|---|---|---|---|
| 1 | −2 | 4 | 4 | −2 | 4 |
| 2 | −1 | 1 | 5 | −1 | 1 |
| 3 | 0 | 0 | 6 | 0 | 0 |
| 4 | 1 | 1 | 7 | 1 | 1 |
| 5 | 2 | 4 | 8 | 2 | 4 |
| Σ = 15 | 0 | 10 | Σ = 30 | 0 | 10 |
- Średnie. Notatki: 15 / 5 = 3. Quizy: 30 / 5 = 6. Różnica: 6 − 3 = 3 punkty.
- Wariancje. W obu grupach suma kwadratów odchyleń wynosi 10, więc wariancja = 10 / (5 − 1) = 2,5 (SD = √2,5 ≈ 1,58).
- Wariancja połączona. \(s_p^2 = (4 \cdot 2{,}5 + 4 \cdot 2{,}5) / 8 = 2{,}5\).
- Mianownik („szum”). \(\sqrt{2{,}5 \cdot (1/5 + 1/5)} = \sqrt{1} = 1\).
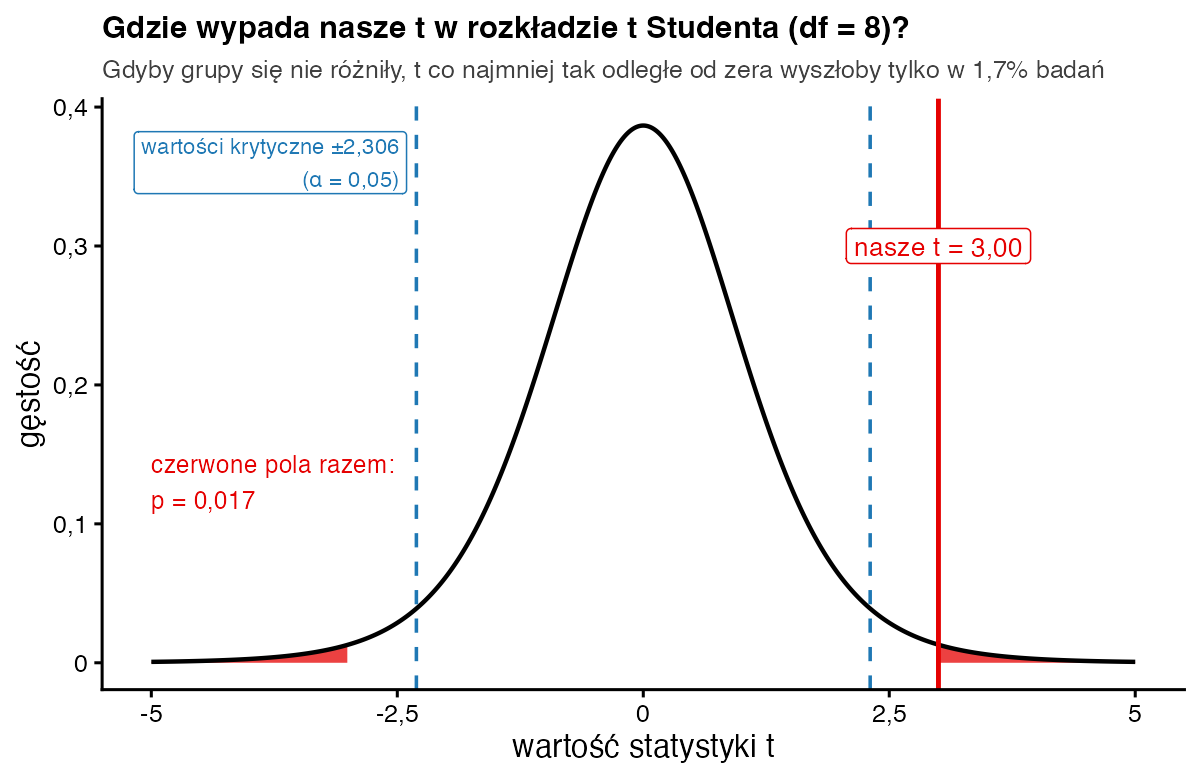
- Statystyka t. t = 3 / 1 = 3,00; stopnie swobody df = 5 + 5 − 2 = 8.
- Wartość p. Dla t = 3,00 i df = 8 program podaje p = 0,017. To mniej niż przyjęty poziom 0,05, więc różnicę uznajemy za istotną statystycznie.
- Wielkość efektu. d Cohena = 3 / √2,5 ≈ 1,90 – efekt bardzo duży.
Jak zinterpretować i opisać wynik?
Studenci uczący się z quizów zdobyli średnio o 3 punkty więcej. Gdyby metoda nauki nie miała żadnego znaczenia, różnicę tak dużą lub większą otrzymalibyśmy tylko w około 1,7% podobnych badań – to właśnie mówi wartość p. Wartość p nie mówi jednak, czy różnica jest duża. Do tego służy d Cohena: umownie 0,2 to efekt mały, 0,5 – średni, a 0,8 – duży (Cohen, 1988). Pięć osób w grupie to tylko ilustracja; w prawdziwym badaniu potrzebujesz większej próby.
Zapis w stylu APA: Studenci uczący się z quizów (M = 6,00; SD = 1,58) uzyskali istotnie więcej punktów niż studenci uczący się z notatek (M = 3,00; SD = 1,58), t(8) = 3,00; p = 0,017; d = 1,90.
Jak policzyć test t w R?
notatki <- c(1, 2, 3, 4, 5)
quizy   <- c(4, 5, 6, 7, 8)

# 1) „ręcznie”, dokładnie według wzoru
n1 <- length(quizy); n2 <- length(notatki)
s2_p <- ((n1 - 1) * var(quizy) + (n2 - 1) * var(notatki)) / (n1 + n2 - 2)
t <- (mean(quizy) - mean(notatki)) / sqrt(s2_p * (1/n1 + 1/n2))
t                                     # 3

# 2) gotową funkcją (var.equal = TRUE to klasyczny test Studenta)
t.test(quizy, notatki, var.equal = TRUE)

# 3) wielkość efektu d Cohena
effectsize::cohens_d(quizy, notatki)
Wynik w konsoli R:
	Two Sample t-test

data:  quizy and notatki
t = 3, df = 8, p-value = 0.01707
alternative hypothesis: true difference in means is not equal to 0
95 percent confidence interval:
 0.6939959 5.3060041
sample estimates:
mean of x mean of y
        6         3

Cohen's d |       95% CI
------------------------
1.90      | [0.32, 3.40]

- Estimated using pooled SD.
Uwaga: t.test() bez argumentu var.equal = TRUE liczy test Welcha. Przy równych grupach i wariancjach – jak tutaj – wynik jest identyczny, ale w pracy zawsze napisz, którą wersję testu podajesz.
Co zrobić, gdy założenia nie są spełnione?
Jeśli wariancje w grupach wyraźnie się różnią (zwłaszcza przy nierównych liczebnościach), raportuj test t Welcha – wielu metodologów zaleca go nawet jako domyślny wybór (Delacre i in., 2017). Jeśli rozkłady są bardzo skośne albo grupy liczą po kilka osób, a wyniki mają wartości odstające, użyj testu U Manna-Whitneya. Normalność oceniaj w każdej grupie osobno: najlepiej na wykresie i testem Shapiro-Wilka, pamiętając, że przy dużych grupach test ten „wyłapuje” nawet nieistotne odchylenia.
Najczęstsze błędy
- Użycie testu dla prób niezależnych, gdy te same osoby zbadano dwa razy.
- Pisanie „przyjęto H0”, gdy p > 0,05. Poprawnie: „brak podstaw do odrzucenia H0” – brak istotności nie dowodzi braku różnicy.
- Sprawdzanie normalności na wszystkich wynikach razem zamiast osobno w każdej grupie.
- Podawanie samego p bez średnich, odchyleń standardowych i wielkości efektu.
Bibliografia
- Student. (1908). The probable error of a mean. Biometrika, 6(1), 1–25. https://doi.org/10.1093/biomet/6.1.1
- Welch, B. L. (1947). The generalization of “Student’s” problem when several different population variances are involved. Biometrika, 34(1–2), 28–35. https://doi.org/10.1093/biomet/34.1-2.28
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Delacre, M., Lakens, D., & Leys, C. (2017). Why psychologists should by default use Welch’s t-test instead of Student’s t-test. International Review of Social Psychology, 30(1), 92–101. https://doi.org/10.5334/irsp.82
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówTest t Welcha
- Słownik wzorówd Cohena – wielkość efektu
- Słownik wzorówTest U Manna-Whitneya
- Słownik wzorówTest Levene’a
- PoradnikTest t Studenta – przykład
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
- Przykładowy raportTest t Studenta
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.