

Częstość względna i tabela częstości – wzór i przykład
Analiza częstości pokazuje, ile osób wybrało każdą odpowiedź (liczebność) i jaką część wszystkich odpowiedzi to stanowi (częstość względna, procent). Typowe pytanie z pracy dyplomowej: jak studenci ocenili zajęcia na skali 1–5 i ilu z nich wystawiło ocenę najwyższą?
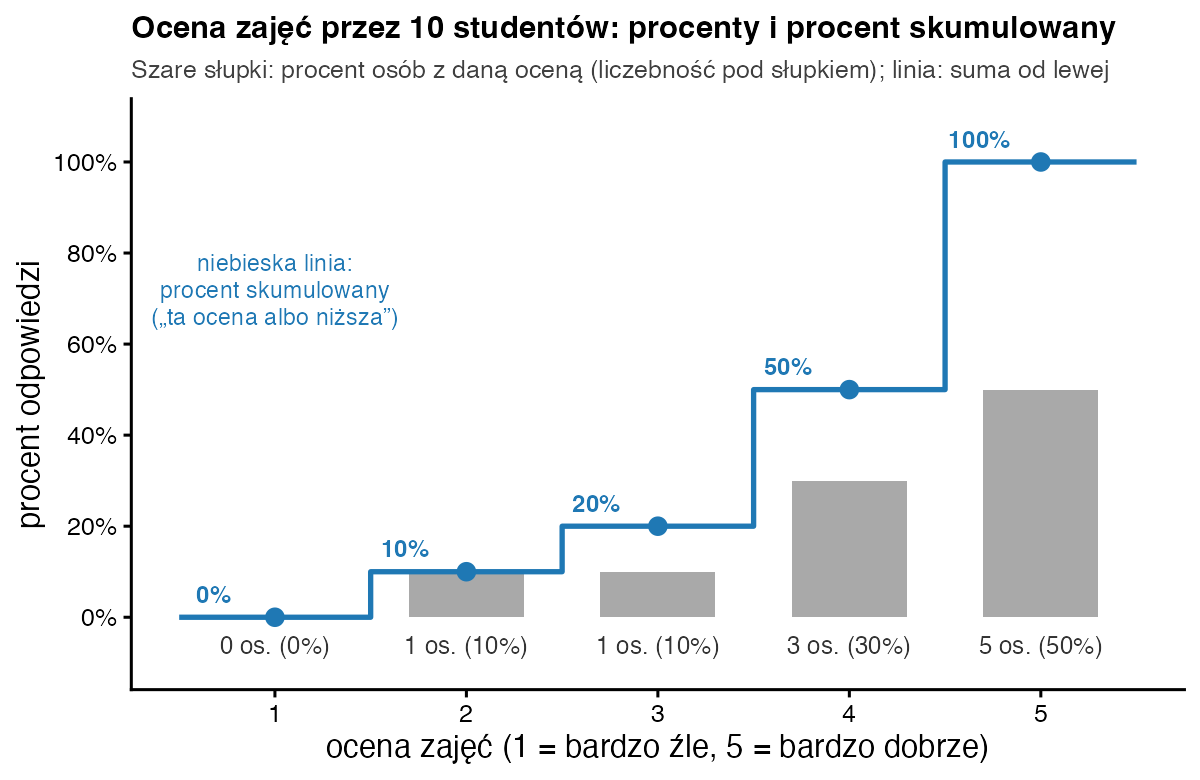
W prostych słowachLiczysz, ile razy pojawia się każda odpowiedź, i dzielisz przez liczbę wszystkich odpowiedzi. Procenty pozwalają porównywać grupy różnej wielkości. Procent skumulowany mówi, jaka część osób dała ocenę „taką albo niższą”.
Kiedy stosować analizę częstości?
- zmienna jest nominalna albo porządkowa: płeć, kierunek studiów, ocena 1–5, wykształcenie;
- opisujesz próbę w rozdziale metodologicznym („kim byli badani?”);
- chcesz pokazać rozkład odpowiedzi na pytanie ankiety, zanim policzysz test.
Najczęstszą odpowiedź nazywamy modą. Gdy chcesz sprawdzić, czy rozkład odpowiedzi różni się między grupami, sięgnij po test chi-kwadrat. Jak zaplanować cały opis ankiety, przeczytasz w artykule o opracowaniu wyników ankiety, a gotowy opis próby – we wpisie statystyka opisowa – przykład.
Wzór na częstość względną
- \(n_i\)
- liczebność: ile osób wybrało odpowiedź i
- \(N\)
- liczba wszystkich ważnych odpowiedzi (bez braków danych)
- \(f_i\)
- częstość względna, czyli ułamek od 0 do 1
- \(p_i\)
- ta sama częstość wyrażona w procentach
- \(F_k\)
- częstość skumulowana: suma częstości od najniższej kategorii do kategorii k; ma sens tylko dla kategorii uporządkowanych
Przykład krok po kroku
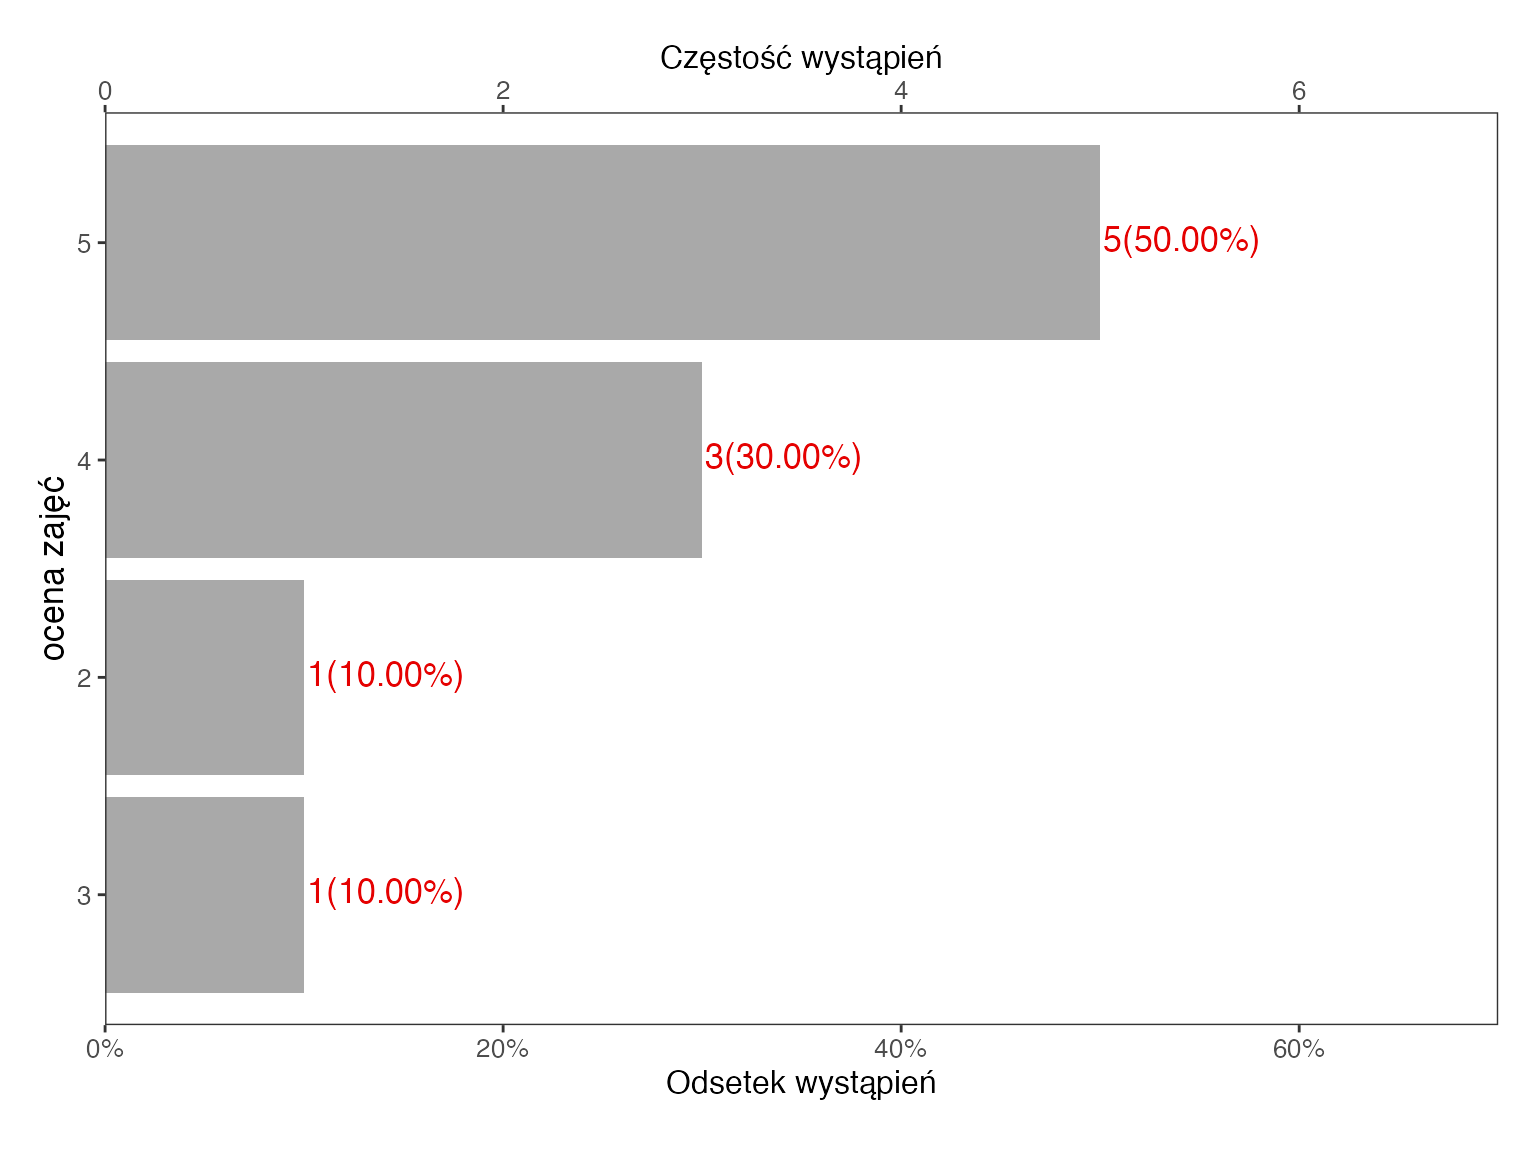
Dziesięcioro studentów oceniło zajęcia na skali od 1 do 5: 5, 4, 4, 5, 3, 5, 4, 5, 2, 5.
| Ocena | ni | fi | % | % skumulowany |
|---|---|---|---|---|
| 1 | 0 | 0,0 | 0 | 0 |
| 2 | 1 | 0,1 | 10 | 10 |
| 3 | 1 | 0,1 | 10 | 20 |
| 4 | 3 | 0,3 | 30 | 50 |
| 5 | 5 | 0,5 | 50 | 100 |
| Razem | 10 | 1,0 | 100 | – |
- Liczebności. Ocena 5 pojawia się 5 razy, ocena 4 – 3 razy, oceny 2 i 3 – po razie. Nikt nie dał oceny 1, ale ten wiersz i tak zostaw w tabeli.
- N. Wszystkich odpowiedzi jest 10.
- Częstości względne. f = n / N, np. dla oceny 4: 3 / 10 = 0,3.
- Procenty. 0,3 · 100% = 30%. Kontrola: procenty sumują się do 100%.
- Procent skumulowany. Dodawaj od góry: 0, 10, 20, 50, 100. Połowa studentów (50%) wystawiła ocenę 4 lub niższą.
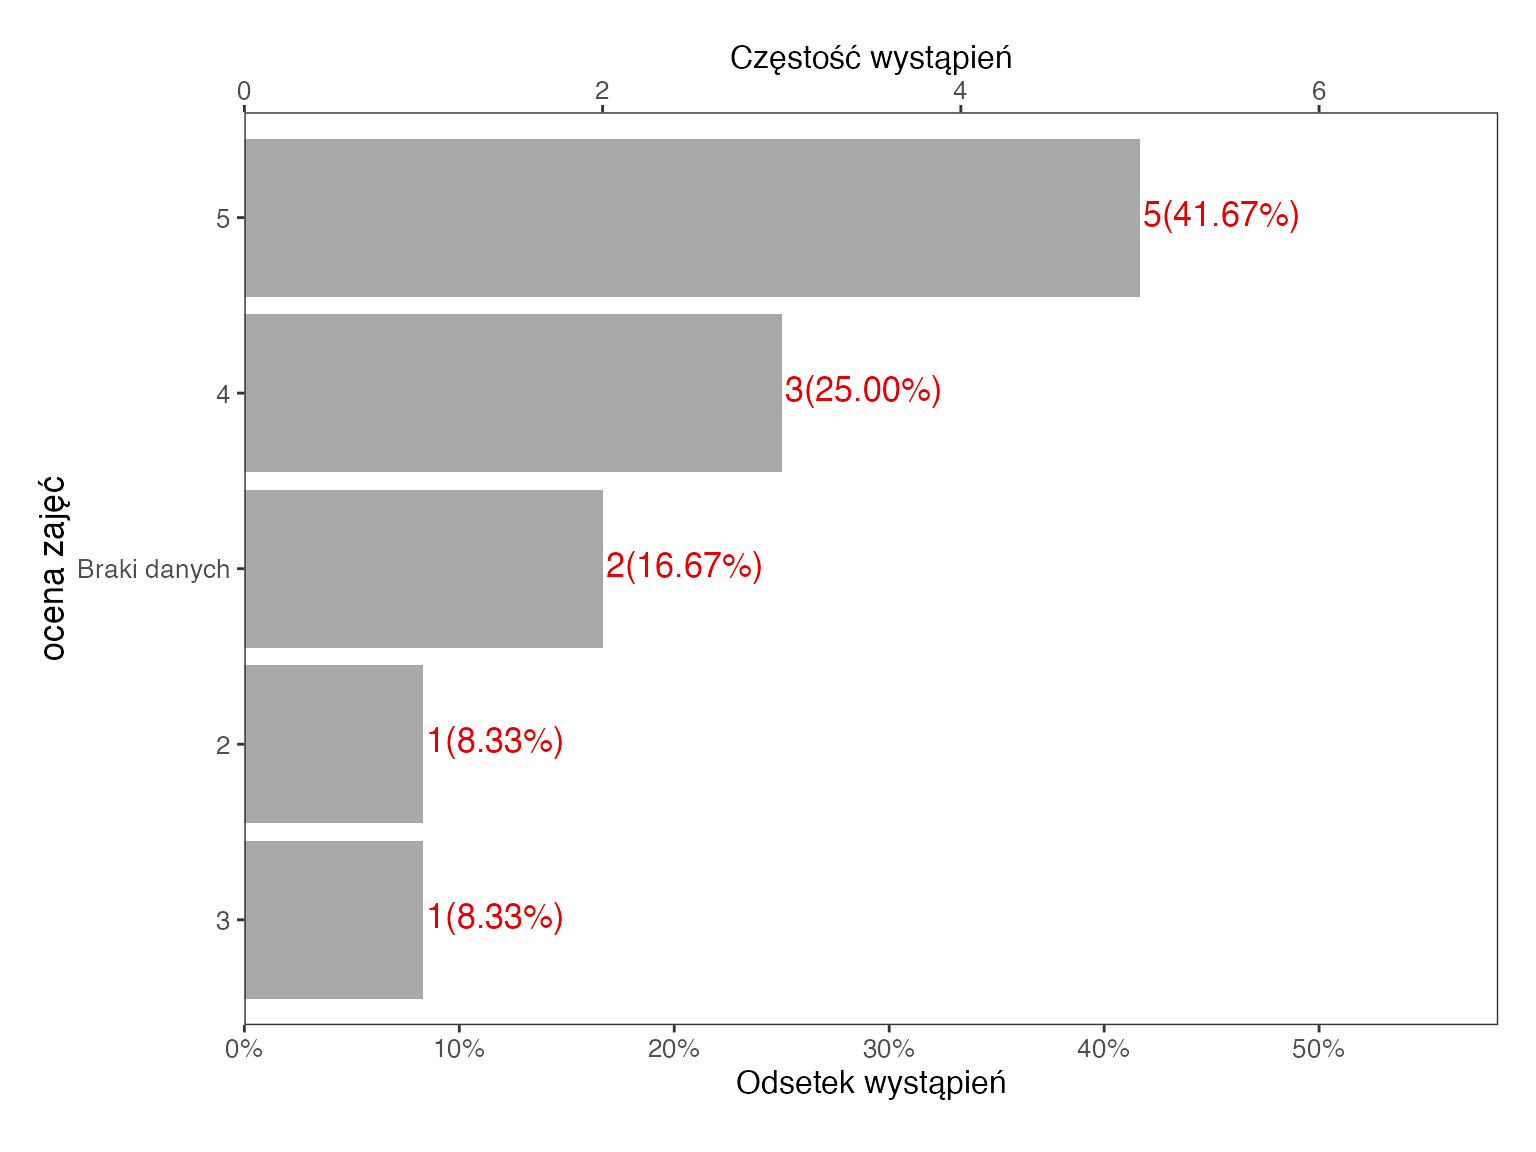
- Braki danych. Dwie kolejne osoby nie odpowiedziały (razem 12 osób). Ocena 5 to wtedy 5 / 12 = 41,67% wszystkich osób, ale nadal 50% ważnych odpowiedzi.
Jak zinterpretować i opisać wynik?
Połowa studentów (5 z 10) oceniła zajęcia na 5, a 30% na 4. Nikt nie wystawił oceny 1. Przy małej próbie zawsze podawaj liczebność obok procentu: „50%” brzmi jak wynik dużego badania, a to tylko 5 osób. Procenty z małej próby podawaj bez miejsc po przecinku albo z jednym. Dwa miejsca przy dziesięciu osobach sugerują precyzję, której nie ma.
Zapis w stylu APA: Połowa badanych studentów (n = 5; 50%) oceniła zajęcia na 5, a 30% (n = 3) – na 4. Żadna osoba nie wystawiła oceny 1.
Jeśli w badaniu są braki danych, dopisz, z jakiej liczby liczysz procenty, np. „Odsetki obliczono z 10 ważnych odpowiedzi; 2 z 12 osób (16,7%) nie odpowiedziały na to pytanie”.
Jak policzyć częstości w R?
ocena <- c(5, 4, 4, 5, 3, 5, 4, 5, 2, 5)
ocena <- factor(ocena, levels = 1:5)          # wszystkie punkty skali, także nieużyte „1”

# 1) „ręcznie”, według wzoru f = n / N
n_i <- table(ocena)
f_i <- n_i / sum(n_i)
data.frame(n = as.vector(n_i), f = as.vector(f_i),
           proc = 100 * as.vector(f_i), proc_skum = 100 * cumsum(as.vector(f_i)),
           row.names = levels(ocena))

# 2) gotową funkcją
prop.table(table(ocena))

# 3) dwie osoby nie odpowiedziały: procent ze wszystkich 12 osób (z brakami)
ocena12 <- factor(c(as.character(ocena), NA, NA), levels = 1:5)
round(100 * prop.table(table(ocena12, useNA = "ifany")), 2)
Wynik w konsoli R:
  n   f proc proc_skum
1 0 0.0    0         0
2 1 0.1   10        10
3 1 0.1   10        20
4 3 0.3   30        50
5 5 0.5   50       100
ocena
  1   2   3   4   5
0.0 0.1 0.1 0.3 0.5
ocena12
    1     2     3     4     5  <NA>
 0.00  8.33  8.33 25.00 41.67 16.67
Zamiana na factor z poziomami 1–5 sprawia, że R pokazuje także nieużytą ocenę 1. Argument useNA = "ifany" dolicza braki danych do tabeli.
Wykres słupkowy czy kołowy?
Przy kilku kategoriach i skali porządkowej wybierz wykres słupkowy. Długości słupków porównujemy na oko dokładniej niż kąty i pola wycinków (Cleveland i McGill, 1984). Słupki zachowują też kolejność skali 1–5, której wykres kołowy nie pokazuje. Wykres kołowy ma sens najwyżej przy dwóch, trzech kategoriach, które razem tworzą całość. Niezależnie od typu wykresu podpisz słupki liczebnością i procentem.
Najczęstsze błędy
- Liczenie procentów ze wszystkich osób bez informacji, że część nie odpowiedziała.
- Podawanie samych procentów bez liczebności – przy małym N „33,33%” może oznaczać jedną osobę na trzy.
- Procent skumulowany dla zmiennej nominalnej, np. kierunku studiów, gdzie kolejność kategorii jest umowna.
- Pomijanie w tabeli kategorii, których nikt nie wybrał.
- Mieszanie w jednej tabeli częstości względnych (0,5) i procentów (50%) bez oznaczenia kolumn.
Bibliografia
- Agresti, A. (2018). Statistical methods for the social sciences (5th ed.). Pearson.
- Cleveland, W. S., & McGill, R. (1984). Graphical perception: Theory, experimentation, and application to the development of graphical methods. Journal of the American Statistical Association, 79(387), 531–554.
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówModa (dominanta)
- Słownik wzorówTest chi-kwadrat
- Słownik wzorówTest dwumianowy
- PoradnikOpracowanie wyników ankiety
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
- Przykładowy raportOpis próby
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.