

Moda (dominanta) – wzór, przykład i zastosowanie
Moda, czyli dominanta, to wartość, która w danych występuje najczęściej. To jedyna miara tendencji centralnej, którą policzysz dla zmiennych nominalnych – na przykład gdy pytasz: jaki kierunek studiów reprezentuje najwięcej osób w mojej próbie?
W prostych słowachModa to „najpopularniejsza odpowiedź”. Nie trzeba niczego dodawać ani dzielić. Wystarczy policzyć, ile razy pojawia się każda wartość, i wskazać zwycięzcę. W danych może być jedna moda, kilka mód albo żadna, gdy wszystkie wartości występują tak samo często.
Kiedy stosować modę?
- zmienna jest nominalna (kierunek studiów, płeć, miejsce zamieszkania) – wtedy moda jest jedyną sensowną miarą „typowej” wartości;
- zmienna jest porządkowa (ocena zajęć 1–5) – podaj modę obok mediany;
- dane są pogrupowane w przedziały (szereg rozdzielczy), a chcesz wskazać najczęstszą wartość wewnątrz przedziału.
Modę odczytasz wprost z tabeli częstości. Dla zmiennych ilościowych ważniejsze są zwykle średnia i mediana, a moda tylko je uzupełnia. Wszystkie trzy miary zestawiliśmy w haśle statystyka opisowa – wzory w pigułce.
Wzór na modę i dominantę
- \(Mo\)
- moda dla danych surowych: wartość \(x_k\), która ma największą liczebność
- \(n_k\)
- liczebność, czyli ile razy występuje dana wartość
- \(D\)
- dominanta dla danych pogrupowanych w przedziały (szereg rozdzielczy)
- \(x_0\)
- dolna granica przedziału z największą liczebnością (przedziału modalnego)
- \(n_m\)
- liczebność przedziału modalnego
- \(n_{m-1},\ n_{m+1}\)
- liczebności przedziału tuż przed nim i tuż po nim
- \(h\)
- szerokość przedziału; wszystkie przedziały muszą mieć tę samą szerokość
Przykład krok po kroku
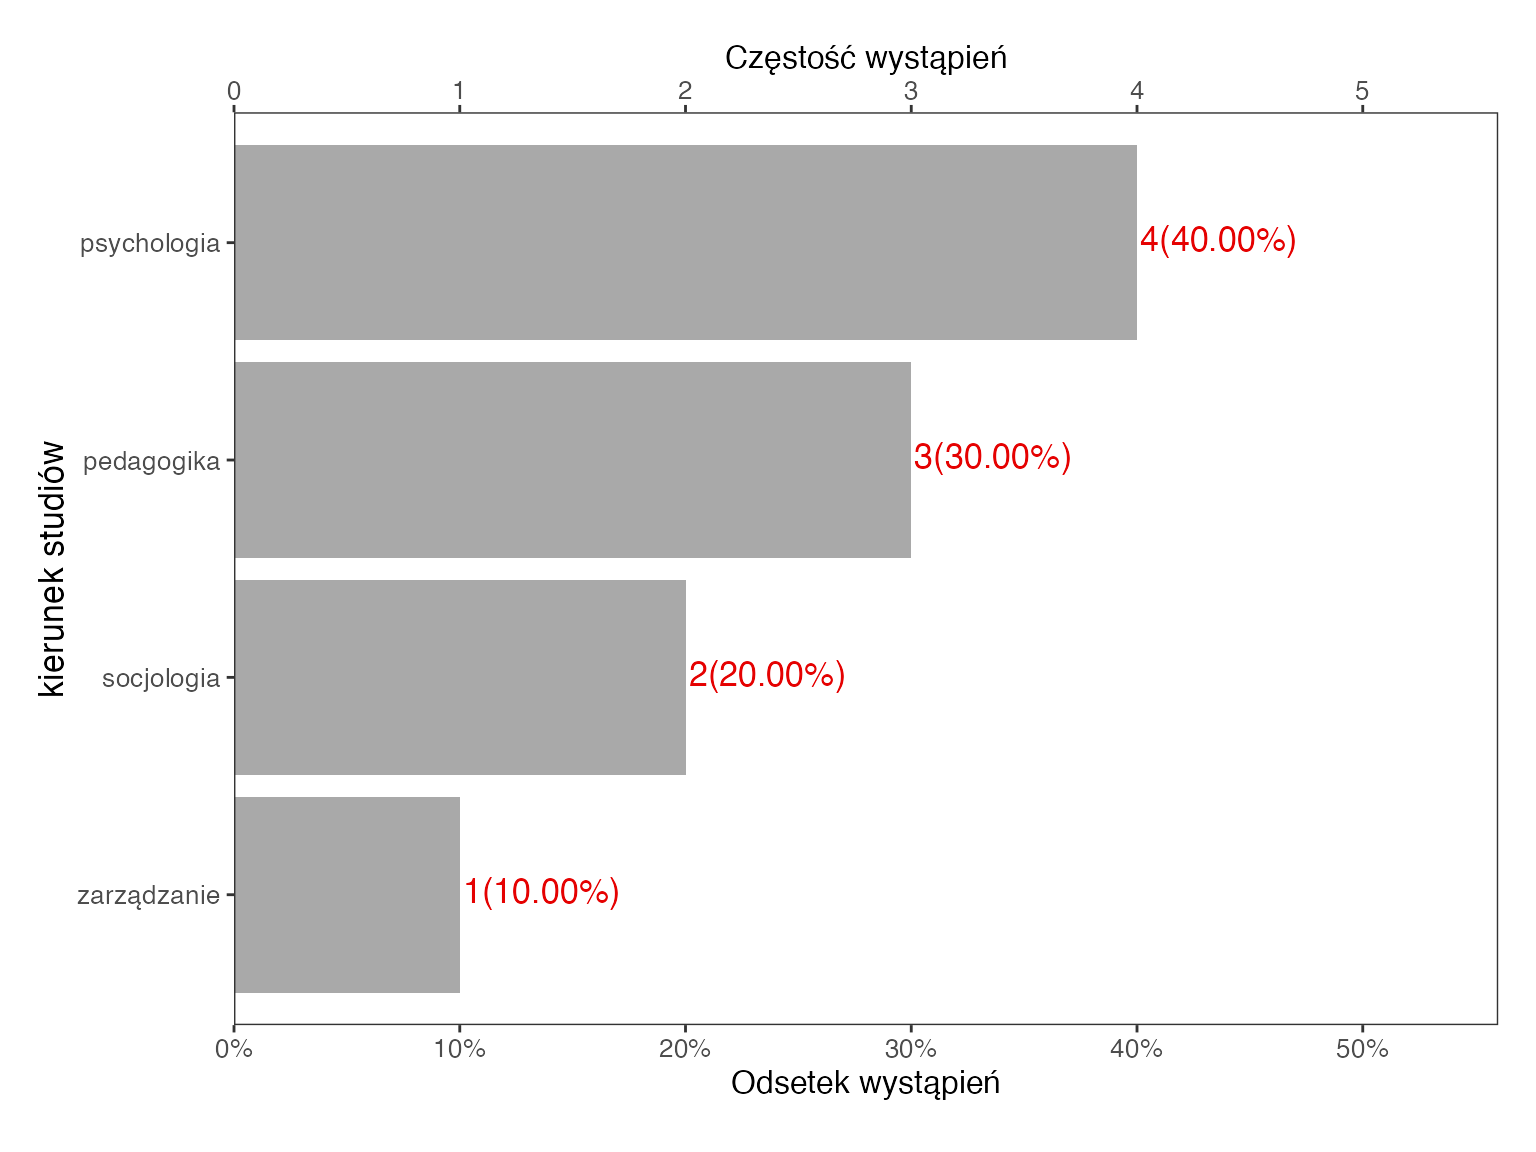
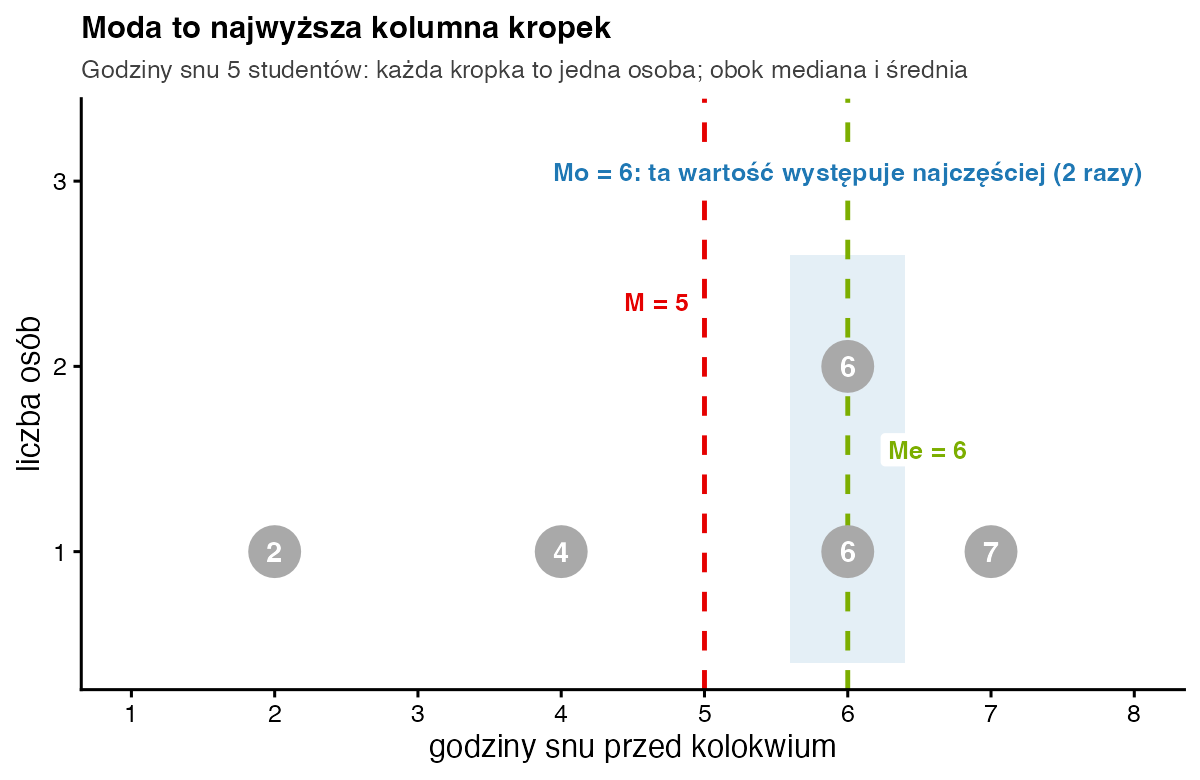
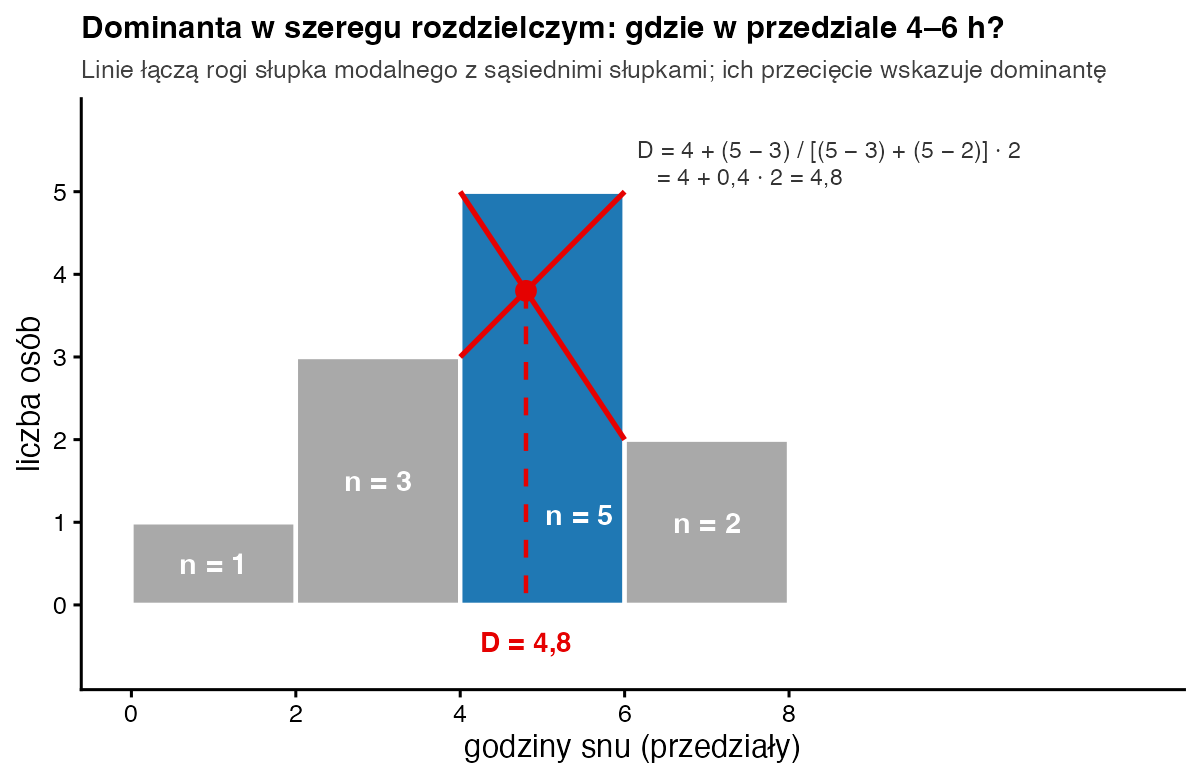
Trzy krótkie przykłady: godziny snu z hasła o średniej (6, 2, 7, 4, 6), kierunek studiów dziesięciu osób oraz godziny snu jedenastu studentów z innej grupy, zapisane w przedziałach (Tabela 1).
| Przedział godzin | Liczebność | Oznaczenie we wzorze |
|---|---|---|
| 0–2 | 1 | – |
| 2–4 | 3 | \(n_{m-1}\) |
| 4–6 | 5 | \(n_m\) (przedział modalny) |
| 6–8 | 2 | \(n_{m+1}\) |
| Razem | 11 | – |
- Dane surowe. W wynikach 6, 2, 7, 4, 6 wartość 6 występuje dwa razy, a pozostałe po razie. Mo = 6 godzin.
- Dane nominalne. Wśród 10 osób jest 4 studentów psychologii, 3 pedagogiki, 2 socjologii i 1 zarządzania. Mo = psychologia (4 osoby, 40%).
- Przedział modalny. W Tabeli 1 najwięcej osób (5) spało od 4 do 6 godzin, więc x0 = 4 i h = 2.
- Różnice liczebności. Względem przedziału poprzedniego: 5 − 3 = 2. Względem następnego: 5 − 2 = 3.
- Dominanta. D = 4 + 2 / (2 + 3) · 2 = 4 + 0,8 = 4,8 godziny. Wypada bliżej przedziału 2–4, bo jest on liczniejszy niż przedział 6–8.
Jak zinterpretować i opisać wynik?
Moda mówi, która odpowiedź była najczęstsza, ale nie mówi, jak bardzo dominowała. Dlatego zawsze podawaj jej liczebność i procent. „Najwięcej osób studiowało psychologię” brzmi mocno, a to tylko 4 z 10 osób – większość próby studiowała coś innego. Moda jest też niestabilna w małych próbach. Gdyby jeden student psychologii przeniósł się na pedagogikę, modą zostałaby pedagogika.
Zapis w stylu APA: Najliczniejszą grupę w próbie stanowili studenci psychologii (n = 4; 40%). Najczęściej deklarowana długość snu przed kolokwium wynosiła 6 godzin (Mo = 6).
Jak policzyć modę w R?
sen <- c(6, 2, 7, 4, 6)
kierunek <- rep(c("psychologia", "pedagogika", "socjologia", "zarządzanie"), c(4, 3, 2, 1))

# 1) „ręcznie”: tabela liczebności i wartość o największej liczebności
tab <- table(sen)
tab
names(tab)[tab == max(tab)]             # wypisze wszystkie mody, jeśli jest ich kilka

# 2) gotową funkcją (atrybut freq to liczebność mody)
DescTools::Mode(sen)
DescTools::Mode(kierunek)

# 3) dominanta szeregu rozdzielczego (przedziały 0–2, 2–4, 4–6, 6–8 godzin)
n_i <- c(1, 3, 5, 2)                    # liczebności przedziałów
m <- which.max(n_i); x0 <- 4; h <- 2    # przedział modalny: 4–6
x0 + (n_i[m] - n_i[m - 1]) / ((n_i[m] - n_i[m - 1]) + (n_i[m] - n_i[m + 1])) * h
Wynik w konsoli R:
sen
2 4 6 7
1 1 2 1
[1] "6"
[1] 6
attr(,"freq")
[1] 2
[1] "psychologia"
attr(,"freq")
[1] 4
[1] 4.8
Uwaga na pułapkę: wbudowana funkcja mode() nie liczy mody, tylko zwraca typ obiektu (np. "numeric"). Dlatego używamy tabeli liczebności albo funkcji Mode() z pakietu DescTools.
Co zrobić, gdy są dwie mody albo nie ma żadnej?
Gdy dwie wartości występują najczęściej i tyle samo razy, rozkład jest dwumodalny – podaj obie mody. Dwa „szczyty” często znaczą, że w danych są dwie różne grupy, np. studenci dzienni i zaoczni. Warto wtedy opisać je osobno. Gdy każda wartość pojawia się tyle samo razy, moda nic nie wnosi. Tak bywa przy zmiennych ciągłych, np. czasie reakcji w milisekundach, gdzie prawie każdy wynik jest inny. Wtedy pogrupuj dane w przedziały i policz dominantę albo pokaż histogram.
Najczęstsze błędy
- Podawanie liczebności zamiast wartości: moda to „psychologia”, a nie „4”.
- Liczenie średniej z kodów zmiennej nominalnej zamiast podania mody.
- Używanie wzoru na dominantę, gdy przedziały mają różną szerokość.
- Szukanie mody w danych ciągłych bez grupowania ich w przedziały.
- Podawanie tylko jednej mody, gdy jest ich kilka – np. funkcja
which.max()zwraca tylko pierwszą.
Bibliografia
- Pearson, K. (1895). Contributions to the mathematical theory of evolution. II. Skew variation in homogeneous material. Philosophical Transactions of the Royal Society of London. A, 186, 343–414.
- Manikandan, S. (2011). Measures of central tendency: Median and mode. Journal of Pharmacology and Pharmacotherapeutics, 2(3), 214–215.
- Signorell, A. (2025). DescTools: Tools for descriptive statistics (R package version 0.99.60) [Oprogramowanie]. https://doi.org/10.32614/CRAN.package.DescTools
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówMediana
- Słownik wzorówŚrednia arytmetyczna
- Słownik wzorówCzęstości i procenty
- PoradnikStatystyka opisowa – przykład
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
- Przykładowy raportOpis próby
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.