

Statystyka opisowa – przykład z interpretacją wyników
Każdy rozdział wyników zaczyna się od opisu próby i zmiennych: kto wziął udział w badaniu i jakie wartości przyjmują zmienne. Pokazujemy, jak przygotować tabelę statystyk opisowych, jak ją zinterpretować i jak opisać w pracy. Typowe pytanie z pracy dyplomowej: które liczby wpisać do tabeli i kiedy zamiast średniej podać medianę?
W skrócieZmienne jakościowe → liczebności i procenty. Zmienne ilościowe → M, SD, Me, min–max, skośność i kurtoza. Potem interpretacja: czy średnia dobrze opisuje typowy wynik i czy rozkład nie jest mocno skośny. Przegląd wszystkich miar znajdziesz we wpisie statystyka opisowa – podstawy, a wzory – w haśle statystyka opisowa – wzory w pigułce.
Krok 1. Dane: kogo i co opisujemy
Opisujemy dziesięciu studentów. Mamy dwie zmienne jakościowe (płeć, tryb studiów) i pięć ilościowych: godziny snu przed kolokwium, godziny nauki w tygodniu, stres (1–10), punkty z kolokwium (0–20) i liczbę nieobecności w semestrze. Taka kolejność w pracy jest typowa: najpierw opis, potem testy hipotez, np. korelacja Pearsona czy regresja.
Krok 2. Opis próby: zmienne jakościowe
| Zmienna | Kategoria | n | % |
|---|---|---|---|
| Płeć | kobieta | 6 | 60 |
| mężczyzna | 4 | 40 | |
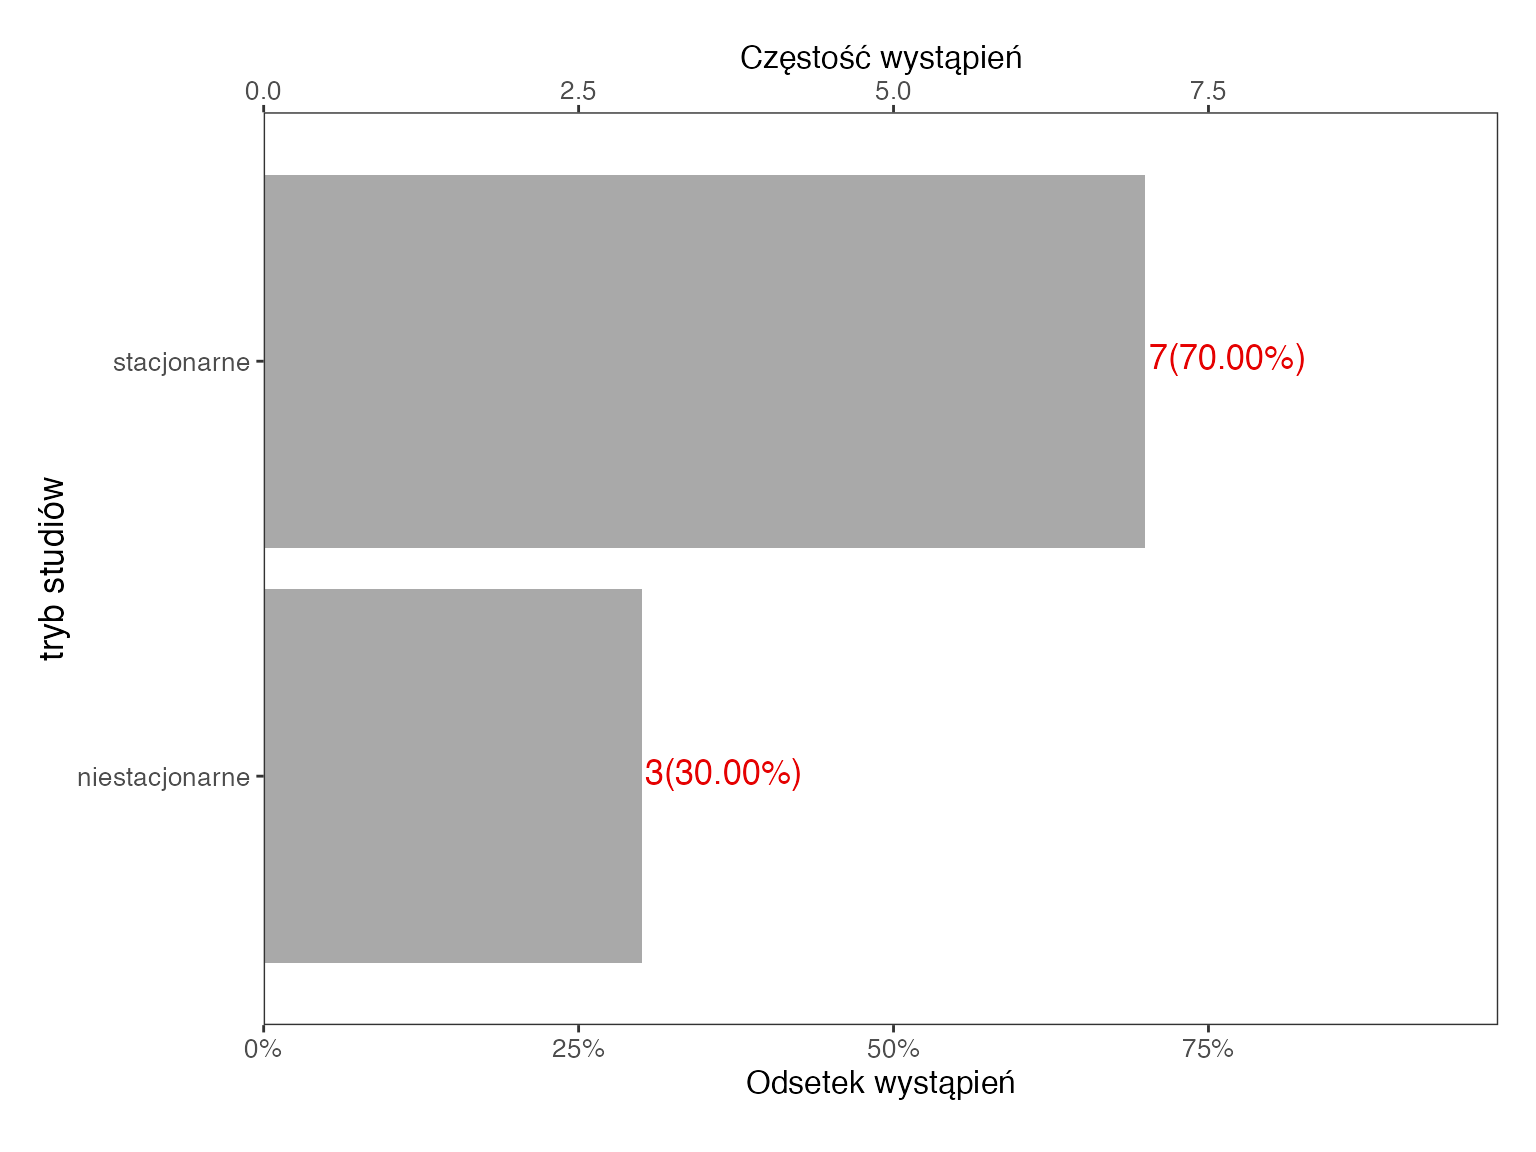
| Tryb studiów | stacjonarne | 7 | 70 |
| niestacjonarne | 3 | 30 |
Dla zmiennych jakościowych podajesz tylko liczebności i procenty. Średnia z kodów 1 i 2 nie ma sensu. Przy małej próbie procenty zaokrąglaj do liczb całkowitych i zawsze podawaj obok n. Więcej o tym w haśle częstości i procenty.
Krok 3. Zmienne ilościowe: tabela statystyk opisowych
| Zmienna | M | SD | Me | Min–max | Skośność | Kurtoza |
|---|---|---|---|---|---|---|
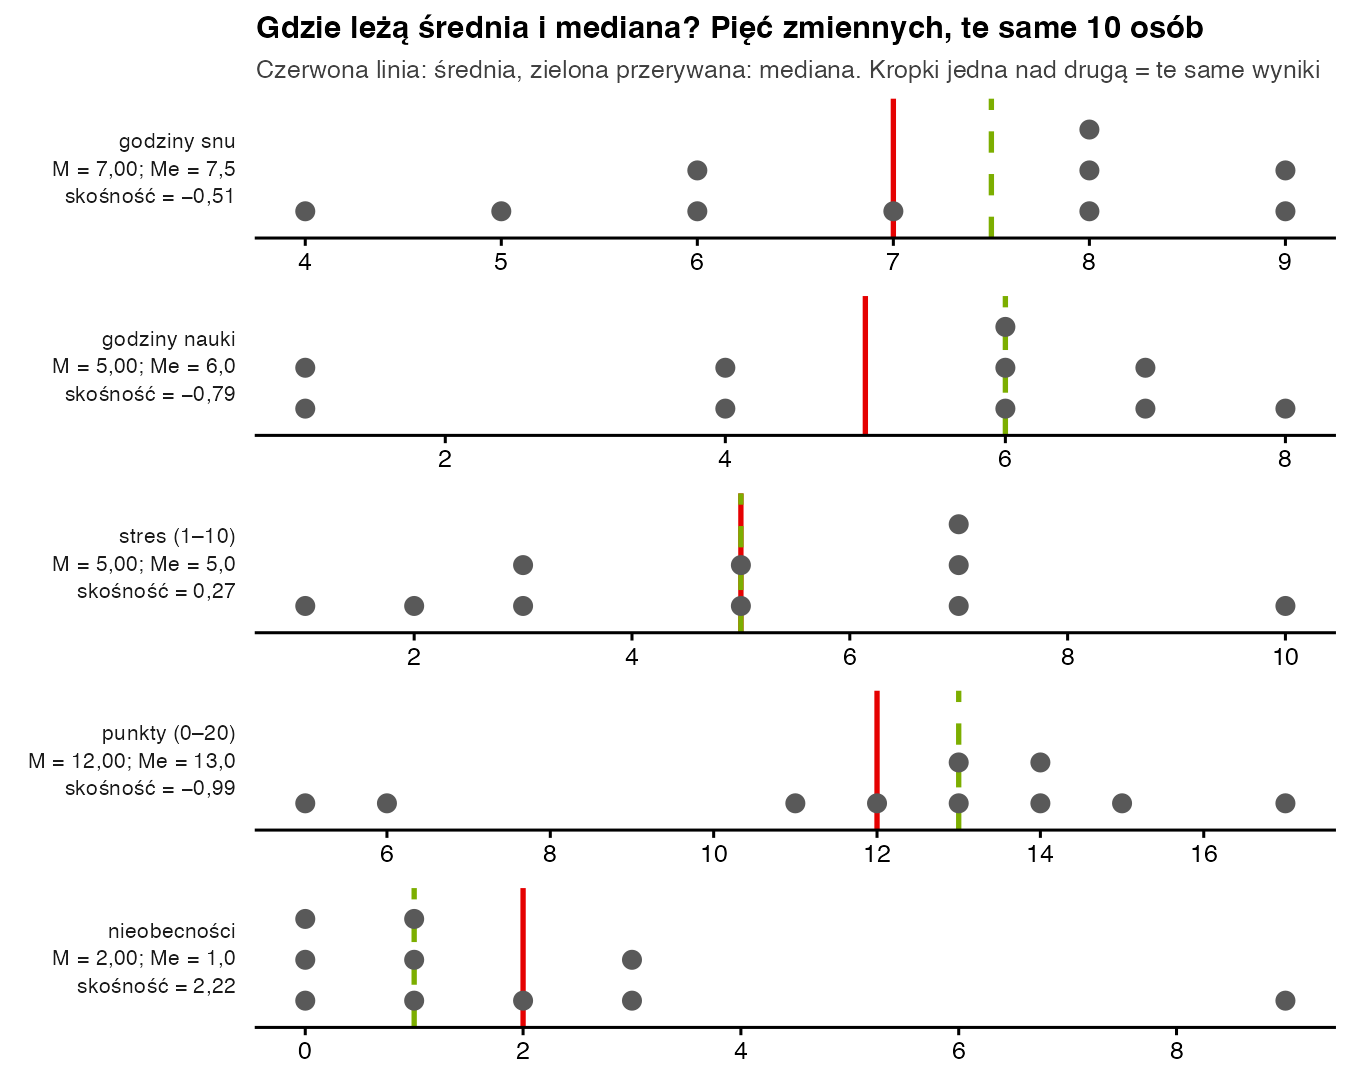
| Godziny snu | 7,00 | 1,70 | 7,5 | 4–9 | −0,51 | −0,83 |
| Godziny nauki | 5,00 | 2,45 | 6,0 | 1–8 | −0,79 | −0,52 |
| Stres (1–10) | 5,00 | 2,79 | 5,0 | 1–10 | 0,27 | −0,58 |
| Punkty (0–20) | 12,00 | 3,80 | 13,0 | 5–17 | −0,99 | 0,30 |
| Nieobecności | 2,00 | 2,71 | 1,0 | 0–9 | 2,22 | 5,62 |
Skośność i kurtozę liczymy w wersjach G1 i G2, tak jak SPSS i SZTOS. Inne programy mogą podać inne wartości, więc w nocie napisz, którą wersję stosujesz.
Krok 4. Interpretacja wyników statystyki opisowej
- Min–max. Najpierw sprawdź, czy wartości mieszczą się w skali: stres w 1–10, punkty w 0–20. To najprostszy sposób na wyłapanie błędów wpisu.
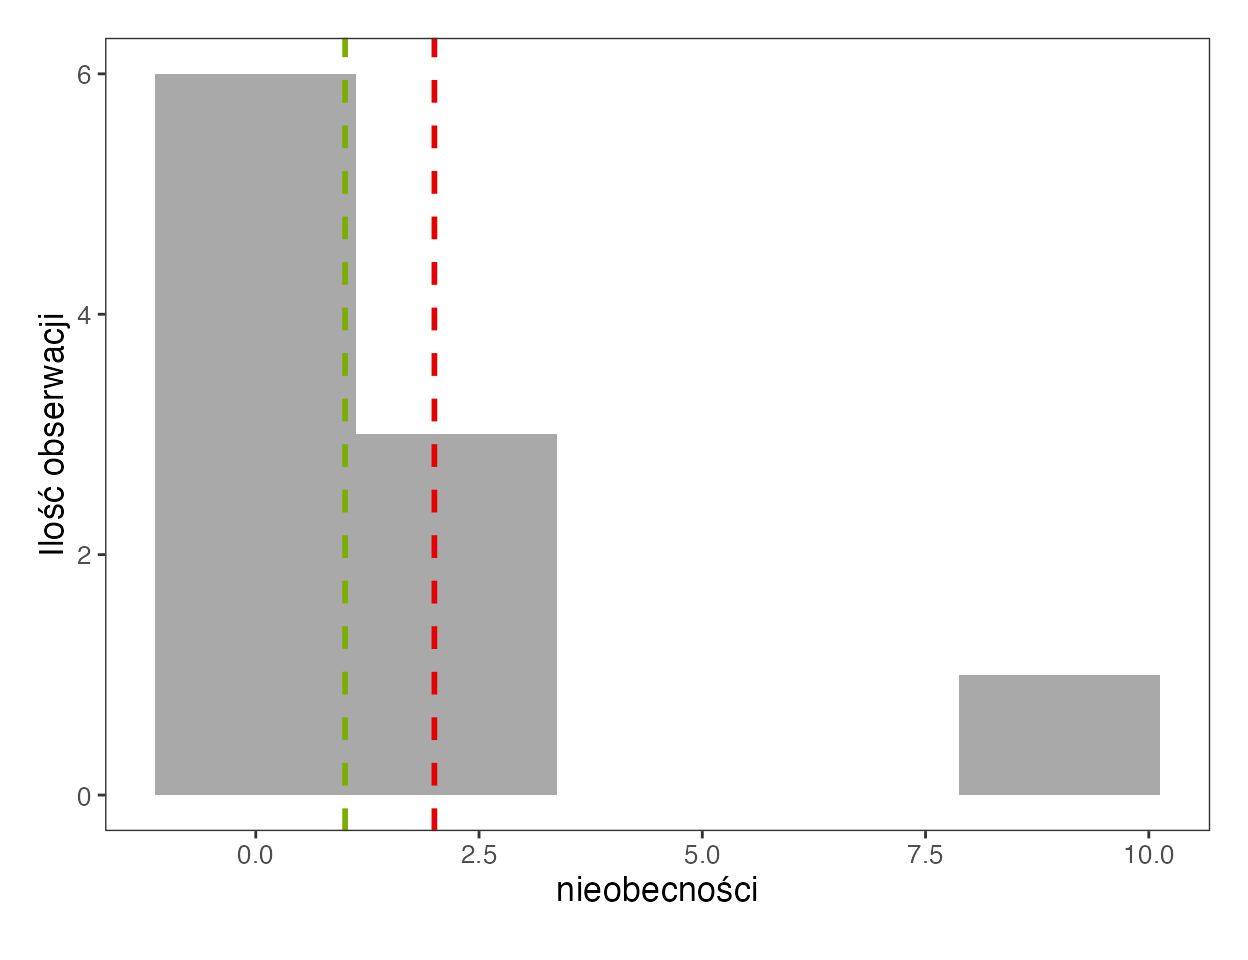
- Średnia a mediana. Dla snu i stresu obie miary są prawie równe. Dla nauki i punktów średnia leży o 1 niżej od mediany, bo po dwie osoby mają wyraźnie niskie wyniki (rys. 2). Czy to już problem, rozstrzyga skośność (punkt 4). Przy nieobecnościach średnia wynosi 2, a mediana 1: jedna osoba opuściła 9 zajęć i „ciągnie” średnią w górę.
- Odchylenie standardowe. Mówi, jak daleko typowo leżą wyniki od średniej. Przy punktach (SD = 3,80) 7 z 10 osób mieści się w przedziale M ± SD, czyli od 8,2 do 15,8 punktu.
- Skośność. Przy n < 50 podziel ją przez jej błąd standardowy (tu 0,69) i porównaj z ±1,96 (Kim, 2013). Dla punktów z = −1,44 – skośność nie odbiega wyraźnie od zera. Dla nieobecności z = 3,24 – rozkład jest wyraźnie prawoskośny. Więcej w hasłach skośność i kurtoza.
- Kurtoza. Wysoka kurtoza nieobecności (5,62) oznacza ciężki ogon, czyli pojedynczy wynik daleko od reszty, a nie „spiczastość”.
- Decyzja. Dla nieobecności w tekście podaj medianę i zakres, a w dalszych analizach rozważ metody oparte na rangach.
Krok 5. Jak opisać statystyki opisowe w pracy?
Zapis w stylu APA: W badaniu wzięło udział 10 studentów, w tym 6 kobiet (60%); 7 osób (70%) studiowało stacjonarnie. Przed kolokwium badani spali średnio 7,00 h (SD = 1,70), a w tygodniu przed nim uczyli się średnio 5,00 h (SD = 2,45). Średni wynik kolokwium wyniósł 12,00 pkt (SD = 3,80; zakres: 5–17). Rozkład liczby nieobecności był prawostronnie skośny (skośność = 2,22), dlatego podano medianę: Me = 1 (zakres: 0–9).
W tekście omów tylko najważniejsze liczby, a resztę zostaw w tabeli. Wyniki zaokrąglaj do dwóch miejsc po przecinku i podawaj jednostki. Tak wygląda pełny opis próby w raporcie: przykładowy raport SZTOS – opis próby.
Cała analiza w R
# Dane: 10 studentów – płeć, tryb studiów, sen, nauka, stres, punkty i nieobecności
dane <- data.frame(
  plec   = c("K", "K", "M", "K", "M", "K", "M", "K", "K", "M"),
  tryb   = c("stacj.", "stacj.", "niestacj.", "stacj.", "stacj.", "niestacj.", "stacj.", "niestacj.", "stacj.", "stacj."),
  sen    = c(9, 8, 7, 6, 9, 6, 8, 4, 5, 8),            # godziny snu przed kolokwium
  nauka  = c(6, 1, 6, 6, 4, 8, 7, 1, 7, 4),            # godziny nauki w tygodniu
  stres  = c(3, 7, 5, 7, 2, 5, 1, 7, 10, 3),           # stres (1–10)
  punkty = c(14, 6, 13, 13, 15, 14, 17, 5, 11, 12),    # punkty z kolokwium (0–20)
  nieobecnosci = c(0, 3, 1, 0, 1, 0, 2, 9, 1, 3))      # liczba nieobecności w semestrze

# 1) zmienne jakościowe: liczebności i procenty
for (z in c("plec", "tryb"))
  print(cbind(n = table(dane[[z]]), proc = round(100 * prop.table(table(dane[[z]])), 1)))

# 2) zmienne ilościowe: M, SD, Me, min, max, skośność i kurtoza (wersje G1 i G2, jak w SPSS)
opis <- function(x) c(M = mean(x), SD = sd(x), Me = median(x), min = min(x), max = max(x),
                      skos = e1071::skewness(x, type = 2), kurt = e1071::kurtosis(x, type = 2))
round(t(sapply(dane[, 3:7], opis)), 2)

# 3) czy skośność jest duża? z = skośność / SE; przy n < 50 porównaj z ±1,96 (Kim, 2013)
n <- 10
SE_skos <- sqrt(6 * n * (n - 1) / ((n - 2) * (n + 1) * (n + 3)))
round(sapply(dane[, 3:7], e1071::skewness, type = 2) / SE_skos, 2)
Wynik w konsoli R:
  n proc
K 6   60
M 4   40
          n proc
niestacj. 3   30
stacj.    7   70
              M   SD   Me min max  skos  kurt
sen           7 1.70  7.5   4   9 -0.51 -0.83
nauka         5 2.45  6.0   1   8 -0.79 -0.52
stres         5 2.79  5.0   1  10  0.27 -0.58
punkty       12 3.80 13.0   5  17 -0.99  0.30
nieobecnosci  2 2.71  1.0   0   9  2.22  5.62
         sen        nauka        stres       punkty nieobecnosci
       -0.74        -1.16         0.39        -1.44         3.24
Pytania promotora i recenzenta
SD czy SE w tabeli?
W opisie zmiennych podawaj odchylenie standardowe – mówi o różnicach między osobami. Błąd standardowy mówi tylko, jak dokładnie znamy średnią (Altman i Bland, 2005).
Czy statystyki opisowe wystarczą, żeby coś stwierdzić o populacji?
Nie. Opisują wyłącznie te 10 osób. Uogólnienie na populację wymaga testu statystycznego i przedziałów ufności.
Czy przy pytaniach Likerta podawać średnią?
Przy pojedynczym pytaniu 1–5 bezpieczniej podać medianę i procent osób w każdej kategorii odpowiedzi. Średnią i SD zostaw dla wyników skal złożonych z kilku pytań. Jak opisać takie dane, pokazujemy we wpisie jak opisać wyniki ankiety w pracy magisterskiej.
Czy usunąć osobę z 9 nieobecnościami?
Nie, jeśli to prawdziwy wynik. Zostaw ją w danych, opisz rozkład medianą i zakresem, a w analizach wybierz metody odporne na wyniki skrajne.
Bibliografia
- Kim, H.-Y. (2013). Statistical notes for clinical researchers: Assessing normal distribution (2) using skewness and kurtosis. Restorative Dentistry & Endodontics, 38(1), 52–54. https://doi.org/10.5395/rde.2013.38.1.52
- Joanes, D. N., & Gill, C. A. (1998). Comparing measures of sample skewness and kurtosis. Journal of the Royal Statistical Society: Series D (The Statistician), 47(1), 183–189. https://doi.org/10.1111/1467-9884.00122
- Altman, D. G., & Bland, J. M. (2005). Standard deviations and standard errors. BMJ, 331(7521), 903. https://doi.org/10.1136/bmj.331.7521.903
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). https://doi.org/10.1037/0000165-000
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- PoradnikStatystyka opisowa – podstawy
- Słownik wzorówStatystyka opisowa – wzory w pigułce
- Słownik wzorówŚrednia arytmetyczna
- Słownik wzorówKwartyle i rozstęp międzykwartylowy
- PoradnikAnaliza statystyczna – co to jest
- Przykładowy raportOpis próby
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.