

Test chi-kwadrat (χ²) – wzór i przykład
Test chi-kwadrat niezależności sprawdza, czy dwie zmienne jakościowe są ze sobą powiązane. Porównuje liczności w tabeli krzyżowej z tym, czego należałoby się spodziewać, gdyby związku nie było. Typowe pytanie z pracy dyplomowej: czy studenci chodzący na ćwiczenia częściej zaliczają przedmiot?
W prostych słowachNajpierw liczysz, ile osób powinno trafić do każdej kratki tabeli, gdyby obie zmienne nie miały ze sobą nic wspólnego. Potem sprawdzasz, jak bardzo prawdziwe liczby odbiegają od tych „oczekiwanych”. Im większe odchylenia w stosunku do oczekiwań, tym większe χ² i tym trudniej uznać je za przypadek.
Kiedy stosować test chi-kwadrat?
- obie zmienne są jakościowe (tak/nie, kierunek studiów, forma zajęć);
- każda osoba trafia do jednej kratki tabeli – obserwacje są niezależne;
- w tabeli są liczności, a nie procenty ani średnie;
- liczności oczekiwane są dość duże – zwykle przyjmuje się, że co najmniej 80% kratek ma E ≥ 5 i żadna nie ma E < 1 (Cochran, 1954).
Gdy liczności oczekiwane są za małe, użyj dokładnego testu Fishera. Siłę związku opiszesz współczynnikiem phi (tabela 2×2) albo V Cramera (większe tabele). Ten sam wzór służy też do testu zgodności jednej zmiennej z założonymi proporcjami (wtedy df = k − 1). Przy dwóch kategoriach i małej próbie lepszy jest test dwumianowy.
Wzór na statystykę chi-kwadrat
- \(O_{ij}\)
- liczność obserwowana – ile osób naprawdę trafiło do kratki w wierszu i i kolumnie j
- \(E_{ij}\)
- liczność oczekiwana – ile osób byłoby w tej kratce, gdyby zmienne nie były powiązane
- \(R_i,\ C_j\)
- suma w wierszu i oraz suma w kolumnie j
- \(N\)
- liczba wszystkich osób w tabeli
- \(r,\ c\)
- liczba wierszy i liczba kolumn tabeli
- \(df\)
- stopnie swobody – potrzebne, żeby odczytać wartość p
Przykład krok po kroku
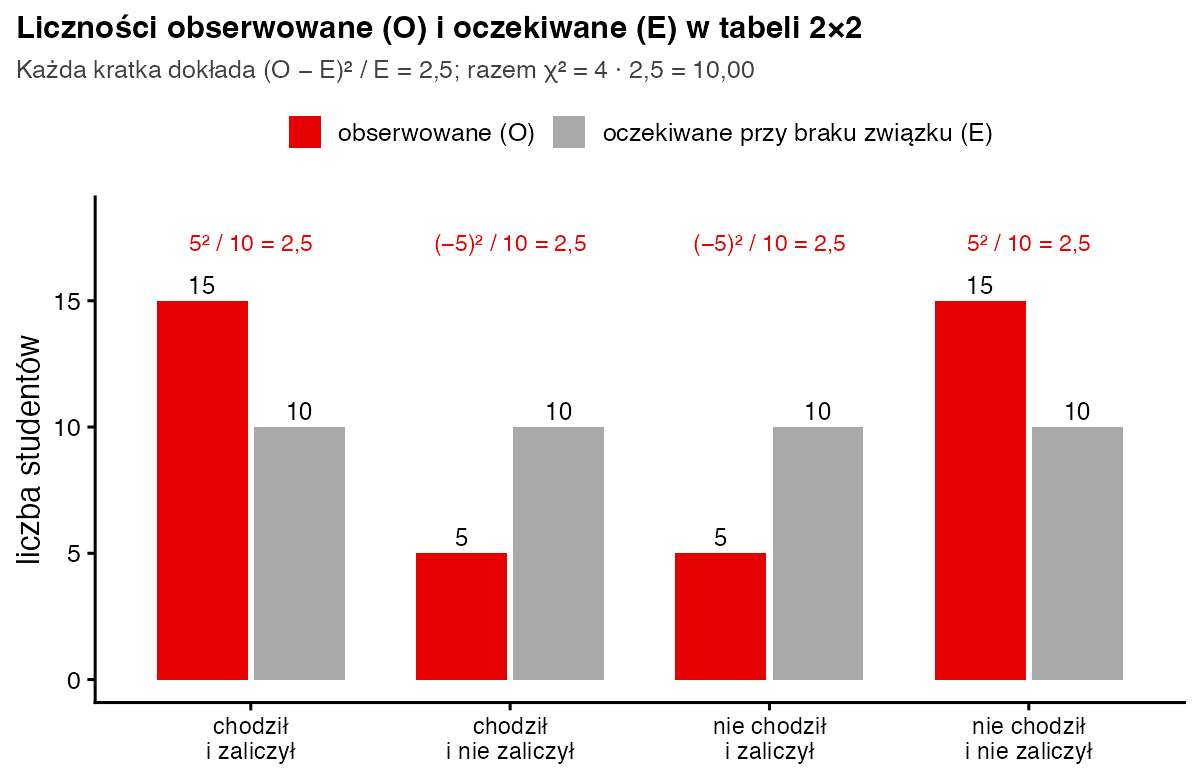
Zapytaliśmy 40 studentów, czy regularnie chodzili na ćwiczenia i czy zaliczyli przedmiot. W nawiasach podajemy liczności oczekiwane.
| Ćwiczenia | Zaliczył | Nie zaliczył | Razem |
|---|---|---|---|
| chodził | 15 (E = 10) | 5 (E = 10) | 20 |
| nie chodził | 5 (E = 10) | 15 (E = 10) | 20 |
| Razem | 20 | 20 | 40 |
- Liczności oczekiwane. W każdej kratce \(E = 20 \cdot 20 / 40 = 10\). Wszystkie są większe niż 5.
- Odchylenia. O − E = 15 − 10 = 5 w kratkach „zgodnych” i 5 − 10 = −5 w pozostałych.
- Składniki. W każdej kratce \((\pm 5)^2 / 10 = 2{,}5\).
- Statystyka. χ² = 4 · 2,5 = 10,00; df = (2 − 1)(2 − 1) = 1.
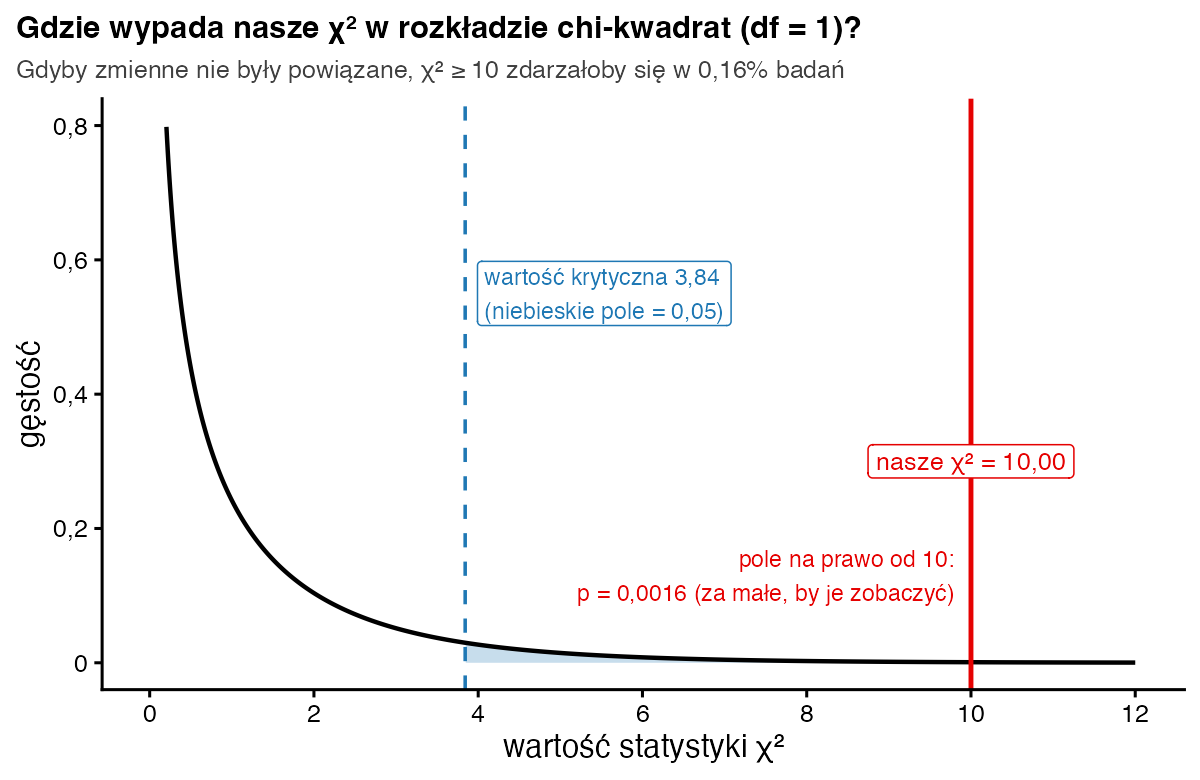
- Wartość p. Dla χ² = 10,00 i df = 1 program podaje p = 0,0016. Wartość krytyczna przy α = 0,05 wynosi 3,84, a nasze χ² jest od niej wyraźnie większe.
- Siła związku. \(\varphi = \sqrt{10 / 40} = 0{,}50\).
W tabeli 2×2 część programów stosuje poprawkę Yatesa: przed podniesieniem do kwadratu odejmuje 0,5 od każdego \(|O - E|\). Wtedy \(\chi^2 = 4 \cdot 4{,}5^2 / 10 = 8{,}10\) i p = 0,004. Dokładny test Fishera daje p = 0,004.
Jak zinterpretować i opisać wynik?
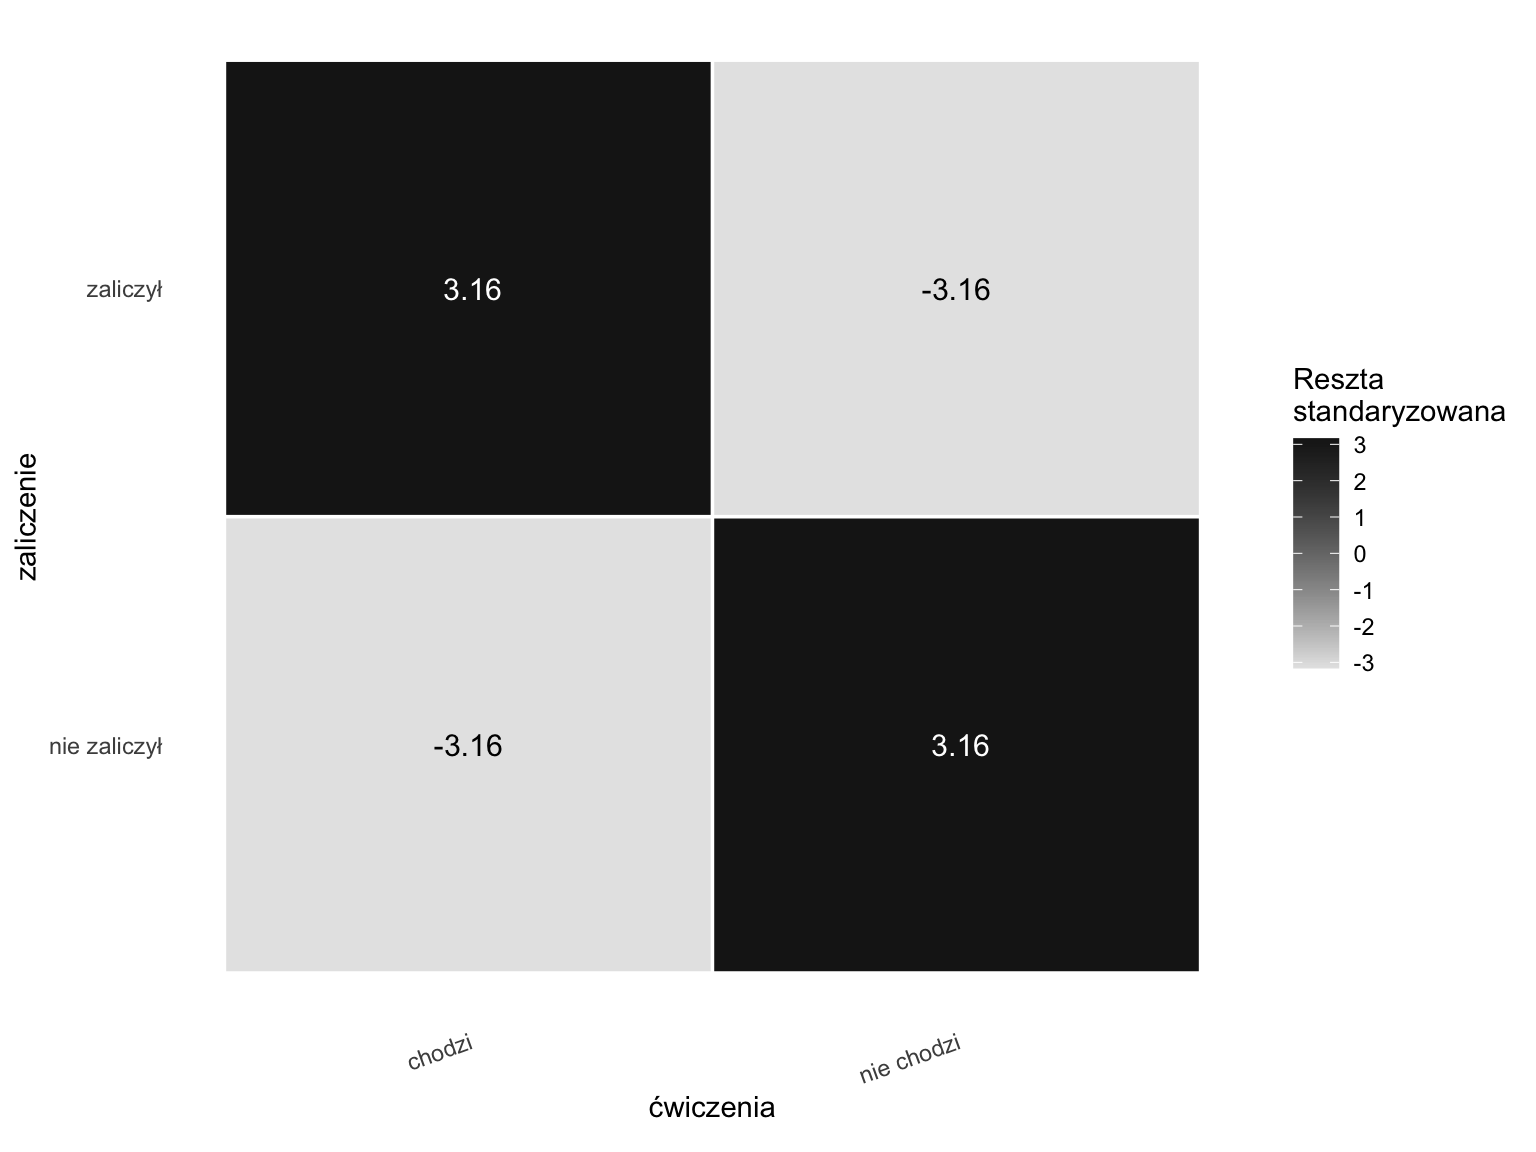
Zaliczyło 75% osób chodzących na ćwiczenia i tylko 25% osób, które na nie nie chodziły. Gdyby obie zmienne nie były powiązane, tak duże odchylenie od liczności oczekiwanych zdarzałoby się rzadziej niż w 2 na 1000 badań. Samo χ² nie mówi jednak, jak silny jest związek, bo rośnie razem z liczbą osób. Do tego służy φ = 0,50 – według konwencji Cohena (1988) to efekt duży. Nie jest to też dowód przyczynowości: być może bardziej zmotywowani studenci i chodzą na ćwiczenia, i lepiej się uczą.
Zapis w stylu APA: Zaliczenie przedmiotu było istotnie związane z chodzeniem na ćwiczenia, χ²(1, N = 40) = 10,00; p = 0,002; φ = 0,50. Przedmiot zaliczyło 75% osób chodzących na ćwiczenia i 25% osób niechodzących.
Jak policzyć test chi-kwadrat w R?
tabela <- matrix(c(15,  5,
                    5, 15), nrow = 2, byrow = TRUE,
                 dimnames = list(cwiczenia  = c("chodził", "nie chodził"),
                                 zaliczenie = c("tak", "nie")))

# 1) „ręcznie”, dokładnie według wzoru
E <- outer(rowSums(tabela), colSums(tabela)) / sum(tabela)   # wszystkie E = 10
sum((tabela - E)^2 / E)                                       # 10

# 2) gotową funkcją; correct = FALSE wyłącza poprawkę Yatesa
chisq.test(tabela, correct = FALSE)

# 3) dla porównania: domyślnie (z poprawką Yatesa) i test Fishera
chisq.test(tabela)$statistic                                  # 8.1
fisher.test(tabela)$p.value                                   # 0.0038
Wynik w konsoli R:
[1] 10

	Pearson's Chi-squared test

data:  tabela
X-squared = 10, df = 1, p-value = 0.001565

X-squared
      8.1
[1] 0.003847527
Uwaga: dla tabeli 2×2 funkcja chisq.test() domyślnie stosuje poprawkę Yatesa (tu χ² = 8,1). Żeby odtworzyć χ² = 10,00 ze wzoru, dopisz correct = FALSE – i w pracy zawsze napisz, którą wersję podajesz.
Poprawka Yatesa czy test Fishera – co wybrać?
Poprawka Yatesa dotyczy tylko tabel 2×2 i sprawia, że test jest ostrożniejszy, czyli daje większe p. Wielu autorów uważa ją dziś za zbyt zachowawczą i przy małych licznościach oczekiwanych poleca od razu dokładny test Fishera, który nie korzysta z przybliżenia (Agresti, 2013). Praktyczna reguła dla tabeli 2×2: gdy wszystkie E są duże, podaj zwykłe χ²; gdy któraś E jest mniejsza niż 5 – test Fishera. Więcej o raportowaniu znajdziesz we wpisie test chi-kwadrat – przykład.
Najczęstsze błędy
- Wpisywanie do tabeli procentów zamiast liczności.
- Liczenie tej samej osoby w kilku kratkach (np. przy pytaniach wielokrotnego wyboru).
- Sprawdzanie założenia na licznościach obserwowanych zamiast oczekiwanych.
- Wniosek przyczynowy („ćwiczenia powodują zaliczenie”) na podstawie samego testu.
- Podawanie χ² bez df, N i miary siły związku.
Bibliografia
- Pearson, K. (1900). On the criterion that a given system of deviations from the probable in the case of a correlated system of variables is such that it can be reasonably supposed to have arisen from random sampling. The London, Edinburgh, and Dublin Philosophical Magazine and Journal of Science, 50(302), 157–175. https://doi.org/10.1080/14786440009463897
- Yates, F. (1934). Contingency tables involving small numbers and the χ² test. Supplement to the Journal of the Royal Statistical Society, 1(2), 217–235.
- Cochran, W. G. (1954). Some methods for strengthening the common χ² tests. Biometrics, 10(4), 417–451.
- Agresti, A. (2013). Categorical data analysis (3rd ed.). Wiley.
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówV Cramera
- Słownik wzorówWspółczynnik phi (φ)
- Słownik wzorówCzęstości i procenty
- PoradnikTest chi-kwadrat – przykład
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
- Przykładowy raportTabele krzyżowe i chi-kwadrat
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.