

Regresja logistyczna – wzór, iloraz szans i przykład
Regresja logistyczna przewiduje prawdopodobieństwo zdarzenia, które ma dwa wyniki: zdał albo nie zdał, tak albo nie. Typowe pytanie z pracy dyplomowej: jak liczba godzin nauki wiąże się z szansą zaliczenia kolokwium?
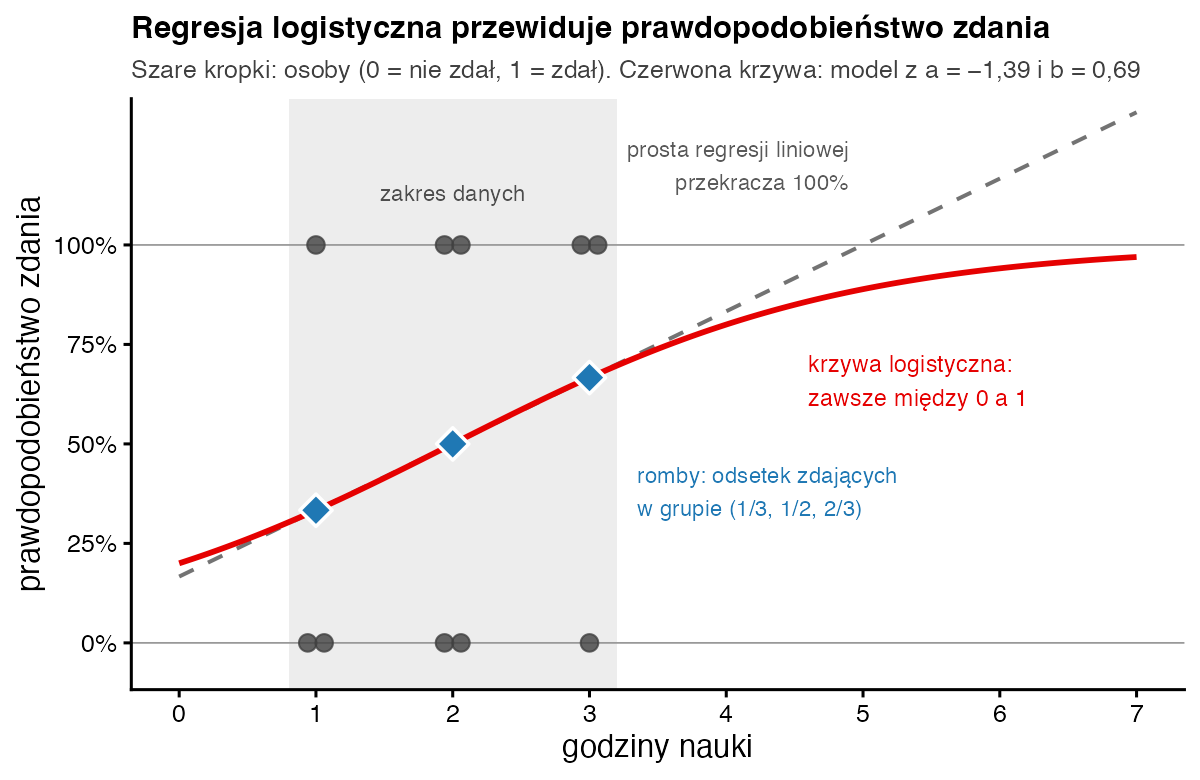
W prostych słowachZwykła prosta mogłaby przewidzieć „120% szans na zdanie”. Regresja logistyczna wygina ją w łagodną literę S, która zawsze zostaje między 0 a 100%. Najważniejszy wynik to iloraz szans: ile razy rośnie szansa (stosunek „zdał do nie zdał”), gdy predyktor rośnie o jeden.
Kiedy stosować regresję logistyczną?
- zmienna zależna ma dwie kategorie (0 i 1), a predyktory mogą być ilościowe albo jakościowe;
- obserwacje są niezależne, a logit (patrz niżej) zmienia się w przybliżeniu liniowo wraz z predyktorem ilościowym;
- masz dość danych: orientacyjnie co najmniej 10 osób w rzadszej kategorii wyniku na każdy predyktor (Peduzzi i in., 1996);
- predyktor nie rozdziela idealnie zer i jedynek (tzw. pełna separacja) – wtedy współczynniki nie dają się oszacować.
Gdy zmienna zależna jest ilościowa, wybierz regresję liniową. Gdy chcesz tylko sprawdzić związek dwóch zmiennych jakościowych, wystarczy test chi-kwadrat. Przy kilku predyktorach sprawdź ich wzajemne powiązanie współczynnikiem VIF.
Wzór na regresję logistyczną
- \(p\)
- prawdopodobieństwo zdarzenia (np. zdania) dla osoby z wynikiem x
- \(p/(1-p)\)
- szansa (ang. odds): ile razy zdarzenie jest częstsze od jego braku; p = 0,5 to szansa 1, czyli „pół na pół”
- \(\ln\frac{p}{1-p}\)
- logit – logarytm naturalny szansy; to on zależy od x liniowo
- \(a,\ b\)
- wyraz wolny i współczynnik regresji; b mówi, o ile rośnie logit, gdy x rośnie o 1
- \(e\)
- podstawa logarytmu naturalnego, około 2,718
- \(OR\)
- iloraz szans: ile razy rośnie szansa, gdy x rośnie o 1 (OR > 1 – szansa rośnie, OR < 1 – maleje)
Przykład krok po kroku
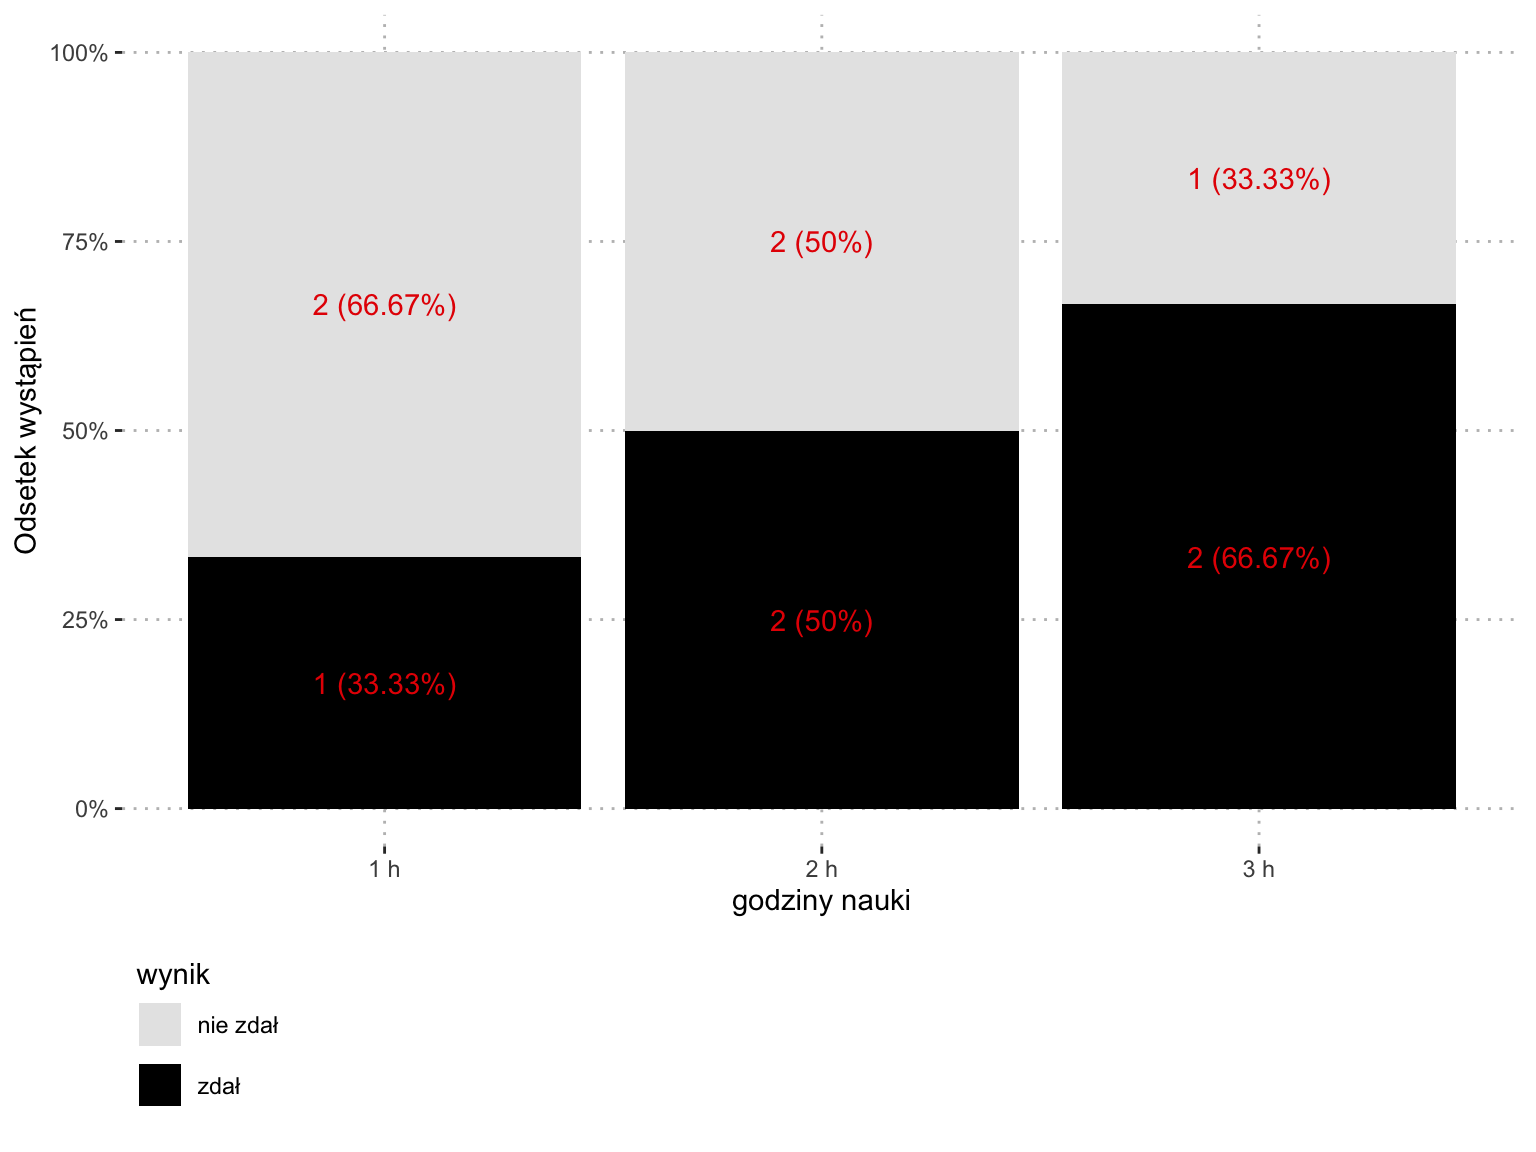
Dziesięcioro studentów: troje uczyło się 1 godzinę, czworo 2 godziny i troje 3 godziny. Zapisujemy, kto zdał kolokwium.
| Godziny | Osoby | Zdało | Nie zdało | Prawdopodobieństwo p | Szansa = zdało / nie zdało | Logit = ln(szansy) |
|---|---|---|---|---|---|---|
| 1 | 3 | 1 | 2 | 1/3 = 0,33 | 0,5 | −0,69 |
| 2 | 4 | 2 | 2 | 2/4 = 0,50 | 1 | 0 |
| 3 | 3 | 2 | 1 | 2/3 = 0,67 | 2 | 0,69 |
| Σ | 10 | 5 | 5 |
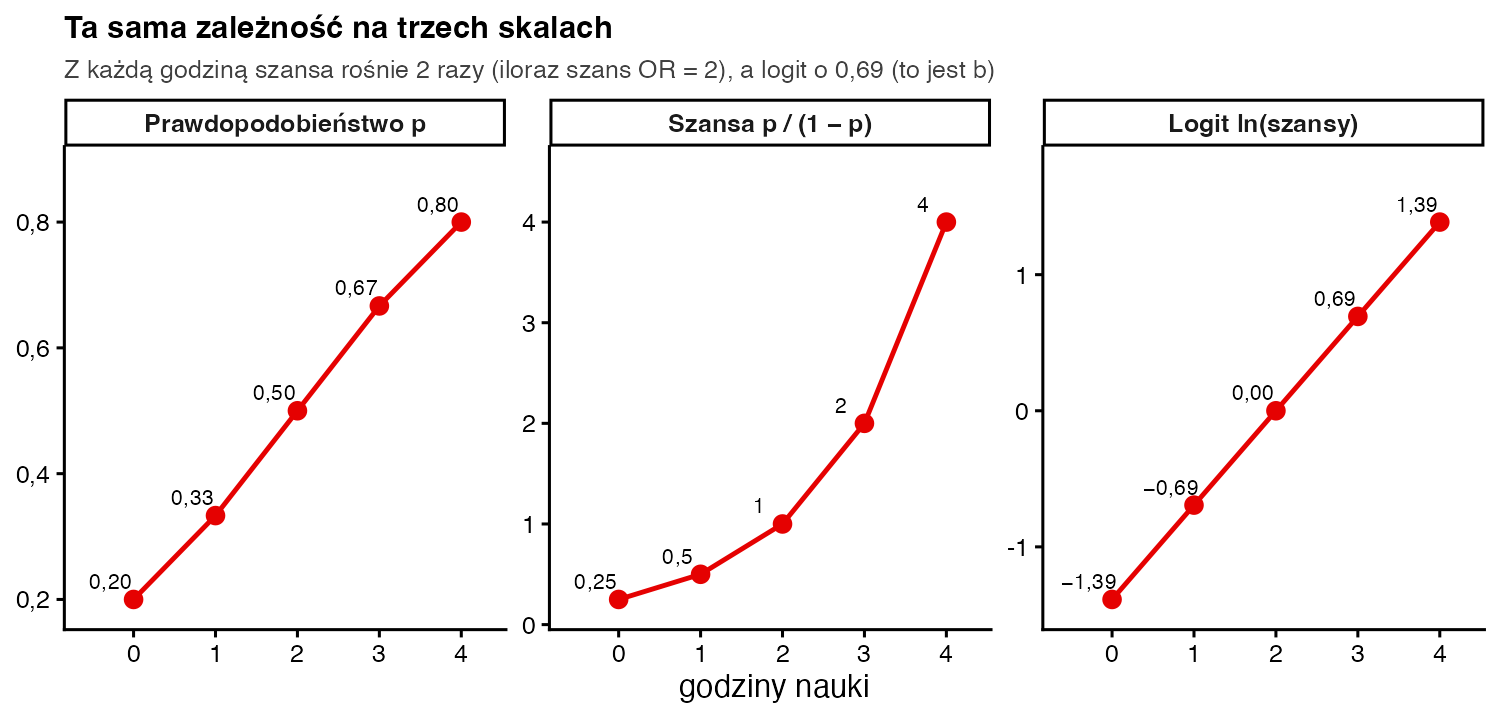
- Szanse. Po 1 godzinie zdała 1 osoba na 2, które nie zdały: szansa 1 : 2 = 0,5. Prawdopodobieństwo to 1/3 – to dwie różne liczby.
- Logity. ln 0,5 = −0,69; ln 1 = 0; ln 2 = 0,69. Każda godzina dodaje 0,69, więc logity leżą na prostej.
- Współczynniki. b = 0,693 (= ln 2), a wyraz wolny a = −0,693 − 0,693 = −1,386 (logit dla 0 godzin). Program liczy je metodą największej wiarygodności – dla tych danych wychodzą dokładnie te liczby.
- Iloraz szans. OR = e0,693 = 2. Każda dodatkowa godzina podwaja szansę zdania: 0,5 → 1 → 2.
- Prawdopodobieństwo dla 3 godzin. Logit = −1,386 + 0,693 · 3 = 0,693, więc p = 1 / (1 + e−0,693) = 1 / (1 + 0,5) = 0,67.
- Istotność. Test Walda: z = 0,80; p = 0,423. Test ilorazu wiarygodności: χ²(1) = 0,68; p = 0,410. Przy 10 osobach efekt jest nieistotny.
Jak zinterpretować i opisać wynik?
OR = 2 znaczy, że każda dodatkowa godzina nauki wiąże się z dwukrotnie większą szansą zdania. Nie znaczy to, że prawdopodobieństwo rośnie dwa razy. Po 1 godzinie wynosi 0,33, a po 2 godzinach 0,50. Przedział ufności dla OR (od 0,37 do 10,92) obejmuje 1, czyli brak związku. Brak istotności nie dowodzi jednak, że nauka nie ma znaczenia – dziesięć osób to po prostu za mało.
Zapis w stylu APA: Liczba godzin nauki nie była istotnym predyktorem zaliczenia kolokwium, b = 0,69; SE = 0,87; z = 0,80; p = 0,423; OR = 2,00; 95% CI [0,37; 10,92]. Model nie poprawiał istotnie dopasowania w porównaniu z modelem bez predyktora, χ²(1) = 0,68; p = 0,410.
Jak policzyć regresję logistyczną w R?
godziny <- c(1, 1, 1, 2, 2, 2, 2, 3, 3, 3)
zdal    <- c(1, 0, 0, 1, 1, 0, 0, 1, 1, 0)      # 1 = zdał, 0 = nie zdał

model <- glm(zdal ~ godziny, family = binomial)
summary(model)$coefficients                    # a, b, test Walda

# iloraz szans: ile razy rośnie szansa zdania z każdą godziną
exp(coef(model))
exp(confint.default(model))                    # 95% CI dla OR (Walda)

# prawdopodobieństwo zdania „ręcznie” (3 godziny) i funkcją predict()
logit <- coef(model)[1] + coef(model)[2] * 3
unname(1 / (1 + exp(-logit)))                  # 0.667
predict(model, data.frame(godziny = 0:4), type = "response")

# test ilorazu wiarygodności: model z godzinami vs model bez predyktora
anova(model, test = "Chisq")
Wynik w konsoli R:
              Estimate Std. Error    z value  Pr(>|z|)
(Intercept) -1.3862944  1.8516399 -0.7486847 0.4540473
godziny      0.6931472  0.8660252  0.8003776 0.4234921
(Intercept)     godziny
       0.25        2.00
                2.5 %   97.5 %
(Intercept) 0.0066347  9.42017
godziny     0.3663262 10.91923
[1] 0.6666667
        1         2         3         4         5
0.2000000 0.3333333 0.5000000 0.6666667 0.8000000
Analysis of Deviance Table

Model: binomial, link: logit

Response: zdal

Terms added sequentially (first to last)


        Df Deviance Resid. Df Resid. Dev Pr(>Chi)
NULL                        9     13.863
godziny  1   0.6796         8     13.183   0.4097
Kolumna Estimate to współczynniki na skali logitu – dopiero exp() zamienia je na ilorazy szans. Argument family = binomial jest obowiązkowy. Bez niego glm() policzy zwykłą regresję liniową.
Szansa a prawdopodobieństwo – czym się różnią?
Prawdopodobieństwo to część wszystkich przypadków: 2 osoby na 3 zdały, więc p = 2/3. Szansa porównuje zdarzenie z jego brakiem: 2 osoby zdały, a 1 nie, więc szansa wynosi 2 : 1, czyli 2. Przy częstych zdarzeniach różnica jest duża: p = 0,8 to już szansa 4. Dlatego zdanie „szansa wzrosła dwukrotnie” nie jest równoznaczne ze zdaniem „prawdopodobieństwo wzrosło dwukrotnie”.
Najczęstsze błędy
- Interpretowanie b albo OR jako zmiany prawdopodobieństwa zamiast zmiany logitu lub szansy.
- Zbyt mała próba: kilka zdarzeń na predyktor daje niestabilne i zawyżone OR.
- Pełna separacja (np. wszyscy, którzy uczyli się ponad 2 godziny, zdali) – R ostrzega wtedy o dopasowanych prawdopodobieństwach 0 lub 1, a współczynniki są ogromne.
- Podawanie samego p bez ilorazu szans i jego przedziału ufności.
Bibliografia
- Hosmer, D. W., Lemeshow, S., & Sturdivant, R. X. (2013). Applied logistic regression (3rd ed.). Wiley.
- Peduzzi, P., Concato, J., Kemper, E., Holford, T. R., & Feinstein, A. R. (1996). A simulation study of the number of events per variable in logistic regression analysis. Journal of Clinical Epidemiology, 49(12), 1373–1379.
- Agresti, A. (2013). Categorical data analysis (3rd ed.). Wiley.
- Field, A., Miles, J., & Field, Z. (2012). Discovering statistics using R. SAGE.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówRegresja liniowa
- Słownik wzorówVIF – współliniowość predyktorów
- Słownik wzorówTest chi-kwadrat
- PoradnikRegresja liniowa – przykład
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
- Przykładowy raportAnaliza regresji
Przygotowujesz artykuł, doktorat lub grant?
Zaplanujemy i wykonamy analizy, przygotujemy raport z tabelami, wykresami i kodem R oraz pomożemy odpowiedzieć na uwagi recenzentów dotyczące statystyki.