

Reszty standaryzowane w regresji – wzór i przykład
Reszty standaryzowane to reszty regresji przeliczone na wspólną skalę, na której łatwo zauważyć nietypowo duże odchylenia od prostej. Typowe pytanie z pracy dyplomowej: czy któryś student nie ma wyniku zupełnie niepasującego do modelu, który przewiduje punkty z godzin nauki?
W prostych słowachReszta to różnica między prawdziwym wynikiem a przewidywaniem z prostej. Jej surowa wartość zależy od jednostek: czy 2 punkty to dużo, czy mało? Standaryzacja dzieli resztę przez typowy rozrzut reszt. Wynik czytasz podobnie jak wynik standaryzowany z: około 0 to przeciętne dopasowanie, poza ±2 – rzadkość, poza ±3 – duża rzadkość.
Kiedy stosować reszty standaryzowane?
- po dopasowaniu regresji liniowej, żeby znaleźć obserwacje źle dopasowane do modelu;
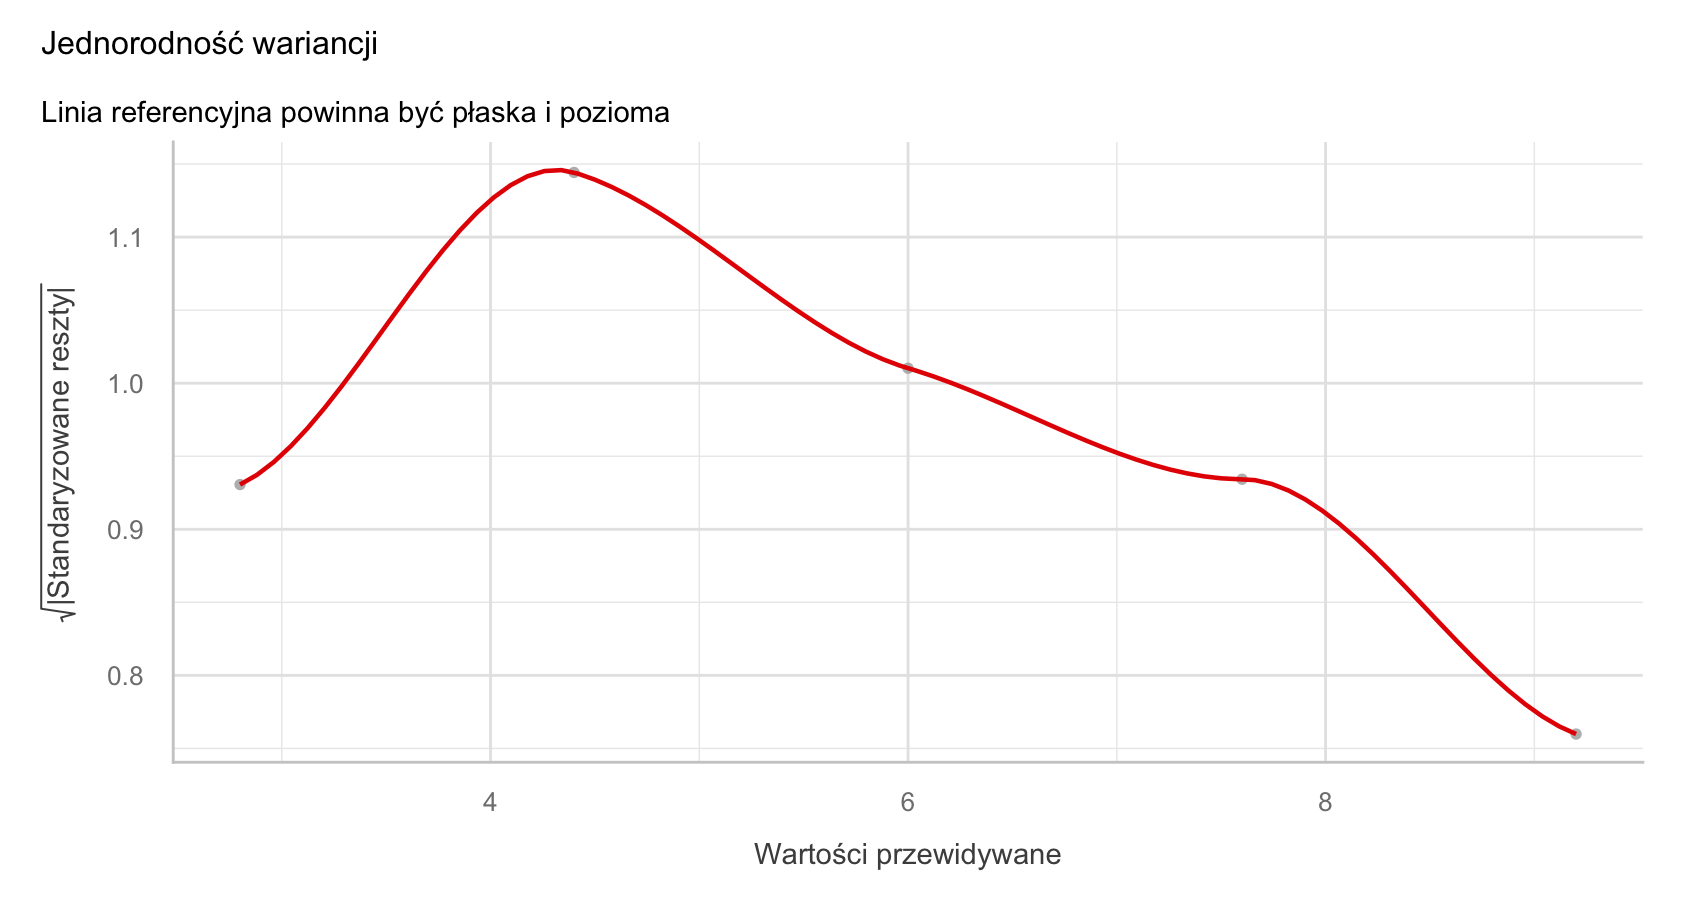
- do wykresów diagnostycznych: reszty względem wartości przewidywanych (stała wariancja) i wykres kwantylowy (normalność reszt);
- gdy chcesz porównać reszty z modeli o różnych jednostkach zmiennej zależnej.
Uwaga na nazwy: w różnych programach „reszta standaryzowana” oznacza dwie różne rzeczy (opisujemy obie). Wersja zewnętrzna, przydatna do testowania obserwacji odstających, ma osobne hasło: reszty studentyzowane. Wpływ obserwacji na wyniki mierzy odległość Cooka.
Wzór na reszty standaryzowane
- \(e_i\)
- reszta i-tej osoby: wynik minus przewidywanie (\(y_i - \hat{y}_i\))
- \(s\)
- błąd standardowy estymacji – pierwiastek ze średniego kwadratu reszt (MSE)
- \(h_i\)
- dźwignia i-tej osoby
- \(z_i\)
- reszta standaryzowana „prosta” (SPSS: ZRE_)
- \(r_i\)
- reszta standaryzowana z poprawką na dźwignię, inaczej wewnętrznie studentyzowana (SPSS: SRE_, R:
rstandard()) - \(n,\ p\)
- liczba obserwacji i liczba parametrów modelu (w regresji prostej p = 2)
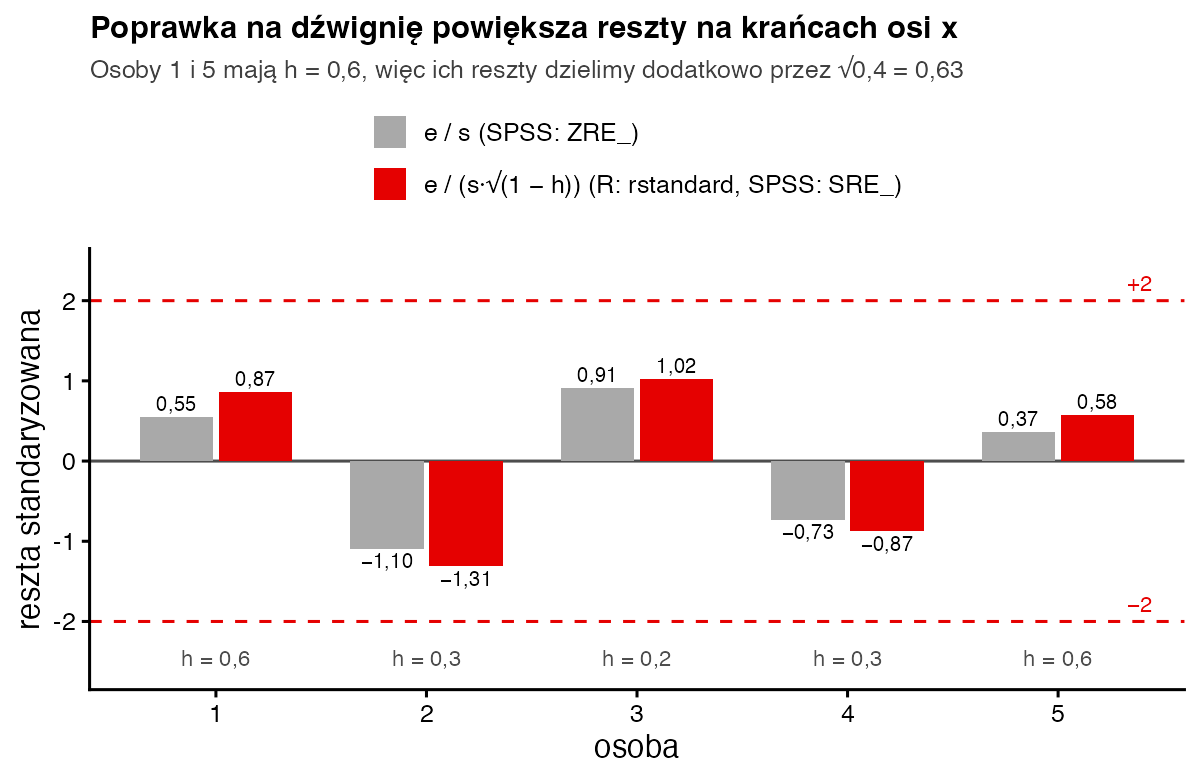
Skąd poprawka \(\sqrt{1 - h_i}\)? Nawet gdy błędy mają stałą wariancję, reszty punktów o dużej dźwigni są przeciętnie mniejsze, bo prosta „przyciąga się” do tych punktów: wariancja reszty to \(\sigma^2(1 - h_i)\). Dzielenie przez \(s\sqrt{1 - h_i}\) wyrównuje tę różnicę.
Przykład krok po kroku
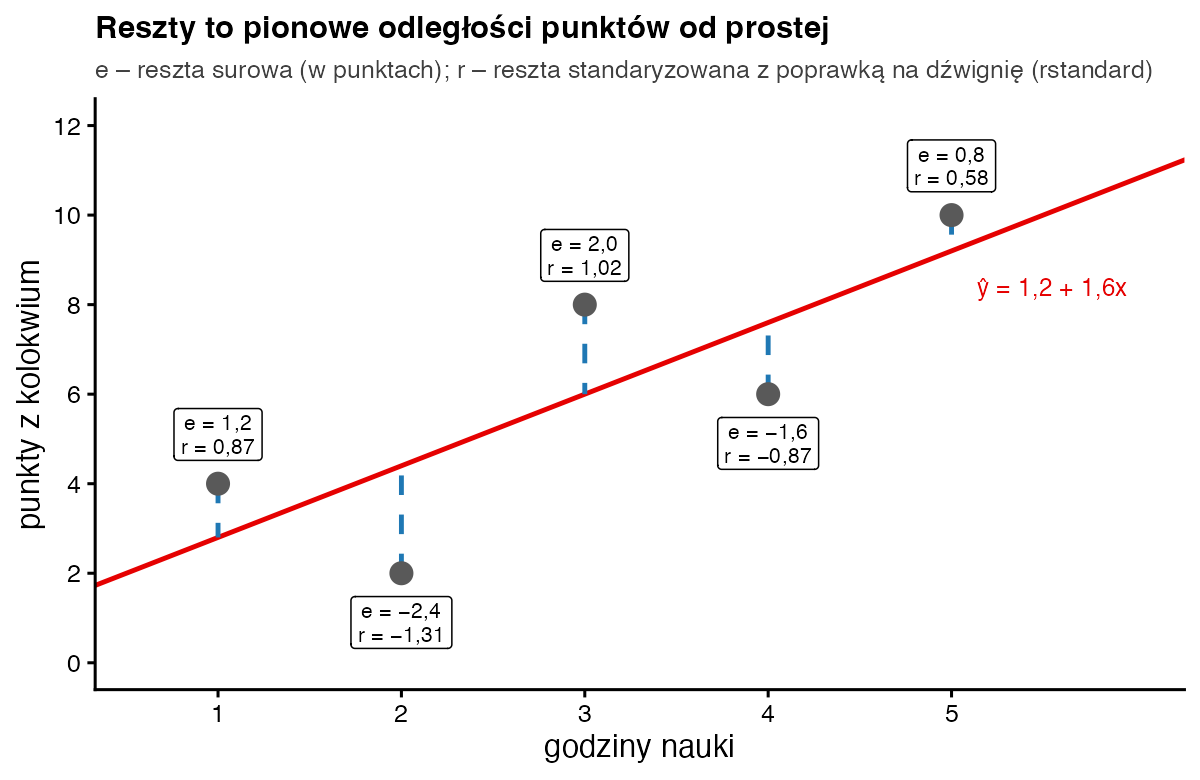
Te same dane co w haśle o odległości Cooka: godziny nauki x = 1–5, punkty y = 4, 2, 8, 6, 10, prosta ŷ = 1,2 + 1,6x.
| x | y | e | h | z = e / s | r = e / (s√(1 − h)) |
|---|---|---|---|---|---|
| 1 | 4 | 1,2 | 0,6 | 0,548 | 0,866 |
| 2 | 2 | −2,4 | 0,3 | −1,095 | −1,309 |
| 3 | 8 | 2,0 | 0,2 | 0,913 | 1,021 |
| 4 | 6 | −1,6 | 0,3 | −0,730 | −0,873 |
| 5 | 10 | 0,8 | 0,6 | 0,365 | 0,577 |
| Σ = 15 | Σ = 30 | 0 | 2,0 | – | – |
- Reszty i MSE. Suma kwadratów reszt to 14,4, więc MSE = 14,4 / (5 − 2) = 4,8, a s = √4,8 = 2,191.
- Prosta standaryzacja. z = e / s, np. dla osoby 2: −2,4 / 2,191 = −1,095.
- Poprawka na dźwignię. r = e / (s√(1 − h)), np. dla osoby 2: −2,4 / (2,191 · √0,7) = −2,4 / 1,833 = −1,309.
- Krańce osi x. Osoby 1 i 5 mają h = 0,6, więc ich reszty dzielimy dodatkowo przez √0,4 = 0,632: dla osoby 1 wartość rośnie z 0,548 do 0,866.
- Ocena. Największa wartość bezwzględna r to 1,31 (osoba 2). Żadna reszta nie wychodzi poza ±2.
Jak zinterpretować i opisać wynik?
Jeśli reszty mają rozkład normalny, około 95% reszt standaryzowanych mieści się w przedziale ±1,96 (w przybliżeniu ±2), a poza ±3 wypada tylko ok. 0,3%. Stąd umowne reguły: wartość bezwzględna powyżej 2 – obserwacja do sprawdzenia (w dużej próbie spodziewaj się ok. 5% takich), powyżej 3 – możliwa obserwacja odstająca (Field i in., 2012). Duża reszta mówi, że osoba źle pasuje do modelu, ale nie mówi, czy zmienia jego wyniki.
Zapis w stylu APA: Analiza reszt standaryzowanych nie wykazała obserwacji źle dopasowanych do modelu – wszystkie mieściły się w przedziale ±2 (największa wartość bezwzględna 1,31).
Jak policzyć reszty standaryzowane w R?
godziny <- c(1, 2, 3, 4, 5)
punkty  <- c(4, 2, 8, 6, 10)
m <- lm(punkty ~ godziny)
e <- resid(m)                     # reszty surowe
s <- sigma(m)                     # pierwiastek z MSE = 2.191
h <- hatvalues(m)                 # dźwignie

# 1) „ręcznie”: dwie wersje reszt standaryzowanych
round(e / s, 3)                   # e / s (SPSS: ZRE_)
round(e / (s * sqrt(1 - h)), 3)   # z poprawką na dźwignię (SPSS: SRE_)

# 2) gotową funkcją R
round(rstandard(m), 3)            # = wersja z (1 - h)
which(abs(rstandard(m)) > 2)      # reszty większe niż |2|
Wynik w konsoli R:
     1      2      3      4      5
 0.548 -1.095  0.913 -0.730  0.365
     1      2      3      4      5
 0.866 -1.309  1.021 -0.873  0.577
     1      2      3      4      5
 0.866 -1.309  1.021 -0.873  0.577
named integer(0)
W R funkcja rstandard() zwraca wersję z poprawką na dźwignię. Prostej wersji e / s nie ma jako osobnej funkcji – policz ją jak w kodzie. W SPSS obie zapiszesz w oknie „Zapisz” regresji liniowej: ZRE_ to z, a SRE_ to r.
Reszty standaryzowane czy studentyzowane – co wybrać?
Do wykresów diagnostycznych i ogólnej oceny dopasowania wystarczą reszty standaryzowane, najlepiej w wersji z poprawką na dźwignię. Do formalnego sprawdzania, czy dana osoba jest obserwacją odstającą, używa się reszt studentyzowanych zewnętrznie: liczą one rozrzut bez tej osoby i mają znany rozkład t. Różnica bywa duża, gdy osoba jest naprawdę nietypowa – wtedy sama zawyża s i „ukrywa się” w resztach standaryzowanych.
Najczęstsze błędy
- Pisanie „reszty standaryzowane” bez informacji, która to wersja (e / s czy z poprawką na dźwignię).
- Uznawanie każdej reszty powyżej 2 za błąd – w dużej próbie ok. 5% takich reszt to norma.
- Wnioskowanie o wpływie obserwacji na model z samej reszty.
- Sprawdzanie normalności zmiennej zależnej zamiast reszt modelu.
Bibliografia
- Cook, R. D., & Weisberg, S. (1982). Residuals and influence in regression. Chapman and Hall.
- Belsley, D. A., Kuh, E., & Welsch, R. E. (1980). Regression diagnostics: Identifying influential data and sources of collinearity. Wiley.
- Fox, J. (2016). Applied regression analysis and generalized linear models (3rd ed.). SAGE.
- Field, A., Miles, J., & Field, Z. (2012). Discovering statistics using R. SAGE.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówReszty studentyzowane
- Słownik wzorówWartość dźwigni (leverage)
- Słownik wzorówOdległość Cooka
- PoradnikRegresja liniowa – przykład
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
- Przykładowy raportAnaliza regresji
Przygotowujesz artykuł, doktorat lub grant?
Zaplanujemy i wykonamy analizy, przygotujemy raport z tabelami, wykresami i kodem R oraz pomożemy odpowiedzieć na uwagi recenzentów dotyczące statystyki.