

Reszty studentyzowane w regresji – wzór i przykład
Reszta studentyzowana (zewnętrznie) to reszta regresji podzielona przez rozrzut reszt policzony bez danej obserwacji. Typowe pytanie z pracy dyplomowej: czy wynik jednego studenta jest na tyle nietypowy, że można go uznać za obserwację odstającą?
W prostych słowachBardzo nietypowa osoba sama powiększa ogólny rozrzut reszt. Przez to jej reszta, podzielona przez ten rozrzut, wygląda skromniej, niż powinna. Reszta studentyzowana rozwiązuje ten problem: dla każdej osoby liczy rozrzut tak, jakby jej w danych nie było, i dopiero wtedy sprawdza, jak bardzo ta osoba odstaje.
Kiedy stosować reszty studentyzowane?
- chcesz formalnie sprawdzić, czy w regresji są obserwacje odstające (test z poprawką Bonferroniego);
- podejrzewasz, że jedna nietypowa osoba zawyża rozrzut i w ten sposób „maskuje” samą siebie;
- potrzebujesz reszt o znanym rozkładzie – reszta studentyzowana ma rozkład t z n − p − 1 stopniami swobody.
Nie myl jej z resztą standaryzowaną, która dzieli przez rozrzut policzony ze wszystkich osób (w R: rstandard()). Wpływ obserwacji na wyniki mierzy odległość Cooka, a jednoczesne testowanie wszystkich reszt wymaga poprawki Bonferroniego.
Wzór na resztę studentyzowaną
- \(t_i\)
- reszta studentyzowana zewnętrznie i-tej osoby (R:
rstudent(), SPSS: SDR_) - \(e_i\)
- reszta: wynik minus przewidywanie z prostej
- \(h_i\)
- dźwignia i-tej osoby
- \(s_{(i)}\)
- błąd standardowy estymacji w modelu bez i-tej osoby; wzór pozwala go policzyć bez ponownego dopasowywania modelu
- \(\sum e^2\)
- suma kwadratów reszt pełnego modelu
- \(n - p - 1\)
- stopnie swobody rozkładu t (n obserwacji, p parametrów modelu)
Przykład krok po kroku
Dane jak w hasłach o odległości Cooka i resztach standaryzowanych: godziny nauki x = 1–5, punkty y = 4, 2, 8, 6, 10, prosta ŷ = 1,2 + 1,6x. Suma kwadratów reszt to 14,4, a n − p − 1 = 5 − 2 − 1 = 2.
| x | e | h | e² / (1 − h) | s₍ᵢ₎ | t = e / (s₍ᵢ₎√(1 − h)) |
|---|---|---|---|---|---|
| 1 | 1,2 | 0,6 | 3,600 | 2,324 | 0,816 |
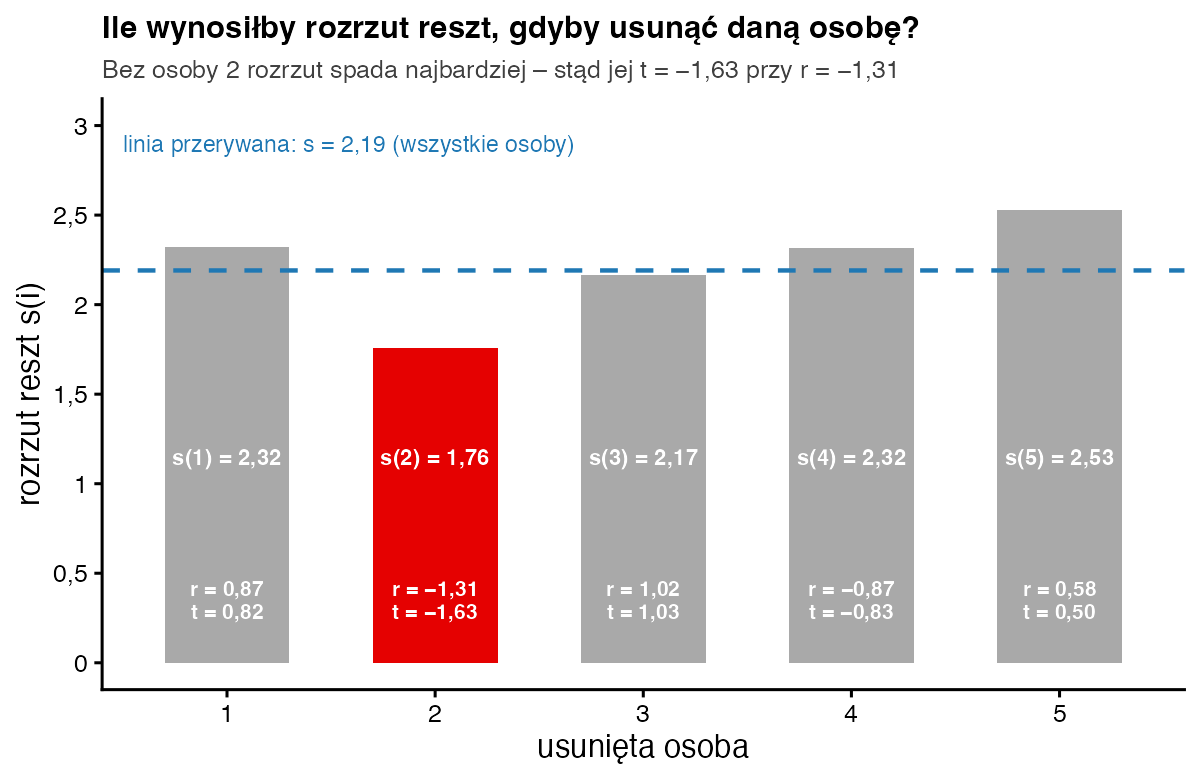
| 2 | −2,4 | 0,3 | 8,229 | 1,757 | −1,633 |
| 3 | 2,0 | 0,2 | 5,000 | 2,168 | 1,031 |
| 4 | −1,6 | 0,3 | 3,657 | 2,318 | −0,825 |
| 5 | 0,8 | 0,6 | 1,600 | 2,530 | 0,500 |
| Σ = 15 | 0 | 2,0 | – | – | – |
- Reszty i dźwignie. Bierzemy je z tabeli w haśle o odległości Cooka; rozrzut całego modelu wynosi s = 2,191.
- Rozrzut bez osoby 2. (14,4 − 8,229) / 2 = 3,086, więc \(s_{(2)} = \sqrt{3{,}086} = 1{,}757\). Bez osoby 2 prosta pasuje lepiej, dlatego rozrzut spada.
- Reszta studentyzowana osoby 2. t = −2,4 / (1,757 · √0,7) = −2,4 / 1,470 = −1,633. Reszta standaryzowana tej osoby wynosi −1,309 – jest mniejsza co do wartości.
- Ocena. Największa wartość bezwzględna t to 1,63 – mniej niż 2, więc w tych danych nie ma obserwacji odstających.
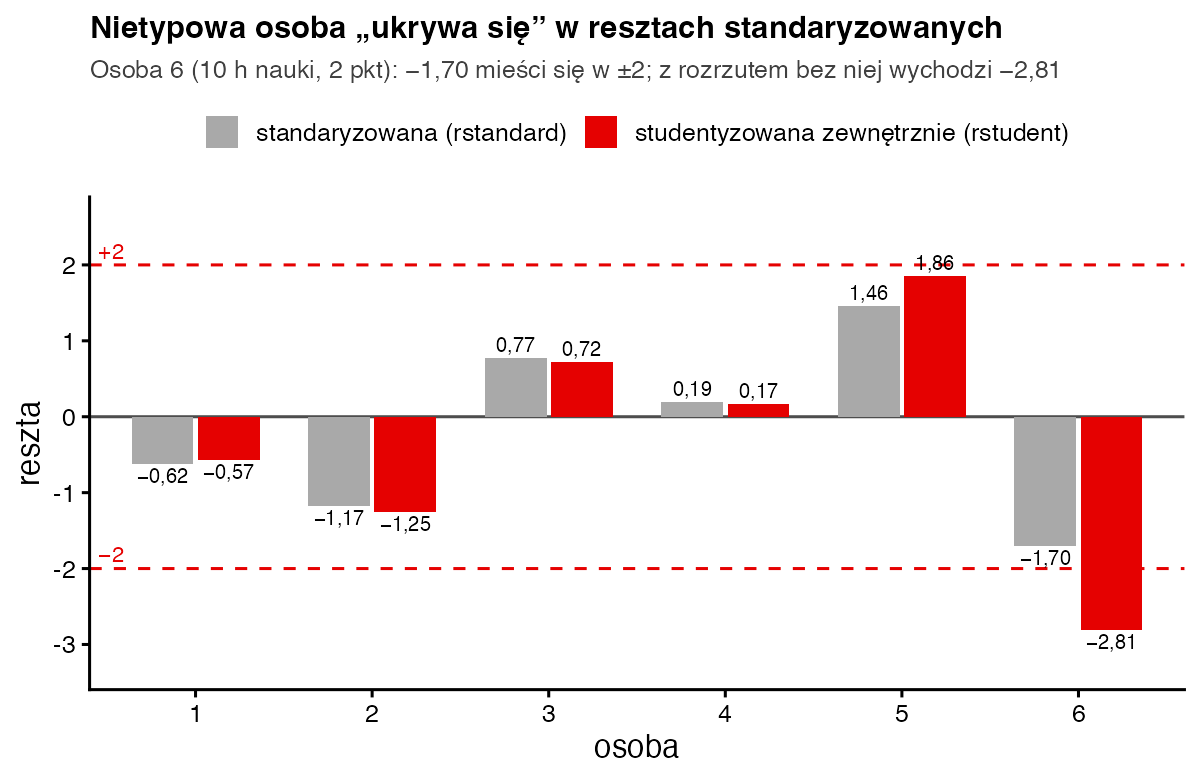
- Szósta osoba. Dopiszmy osobę, która uczyła się 10 godzin i zdobyła 2 punkty. Jej reszta standaryzowana to −1,70 (wygląda niewinnie), a studentyzowana −2,81. Test t dla tej reszty daje p = 0,067 bez poprawki i 0,40 po poprawce Bonferroniego na 6 testów.
Jak zinterpretować i opisać wynik?
Ponieważ \(t_i\) ma rozkład t, wartość bezwzględna powyżej 2 to sygnał do sprawdzenia, a powyżej 3 – mocna przesłanka, że obserwacja odstaje (to umowne reguły, por. Field i in., 2012). Testując wszystkie reszty naraz, wykonujesz n testów, dlatego stosuje się poprawkę Bonferroniego: p mnożysz przez n (Cook i Weisberg, 1982; Fox i Weisberg, 2019). Brak istotności nie dowodzi, że obserwacja jest „zwyczajna” – przy sześciu osobach test ma bardzo małą moc.
Zapis w stylu APA: Największa reszta studentyzowana wyniosła t(3) = −2,81 (osoba 6). Test z poprawką Bonferroniego nie wskazał obserwacji odstających (pBonf = 0,40). Ta sama osoba miała jednak bardzo dużą odległość Cooka (D = 7,39), dlatego wyniki podano z nią i bez niej.
Jak policzyć reszty studentyzowane w R?
godziny <- c(1, 2, 3, 4, 5)
punkty  <- c(4, 2, 8, 6, 10)
m <- lm(punkty ~ godziny)
e <- resid(m); h <- hatvalues(m); n <- 5; p <- 2

# 1) „ręcznie”: s bez i-tej osoby, potem reszta studentyzowana
s_i <- sqrt((sum(e^2) - e^2 / (1 - h)) / (n - p - 1))
round(s_i, 3)
round(e / (s_i * sqrt(1 - h)), 3)

# 2) gotową funkcją R
round(rstudent(m), 3)

# 3) szósta osoba (10 h nauki, 2 punkty): rstandard a rstudent
m6 <- lm(c(punkty, 2) ~ c(godziny, 10))
round(c(rstandard = rstandard(m6)[6], rstudent = rstudent(m6)[6]), 2)
car::outlierTest(m6)              # test z poprawką Bonferroniego
Wynik w konsoli R:
    1     2     3     4     5
2.324 1.757 2.168 2.318 2.530
     1      2      3      4      5
 0.816 -1.633  1.031 -0.825  0.500
     1      2      3      4      5
 0.816 -1.633  1.031 -0.825  0.500
rstandard.6  rstudent.6
      -1.70       -2.81
No Studentized residuals with Bonferroni p < 0.05
Largest |rstudent|:
   rstudent unadjusted p-value Bonferroni p
6 -2.809041           0.067346      0.40408
Funkcja rstudent() daje dokładnie to samo co wzór. car::outlierTest() wskazuje największą resztę i podaje p bez poprawki oraz z poprawką Bonferroniego.
Reszty studentyzowane wewnętrznie i zewnętrznie – czym się różnią?
Wewnętrznie studentyzowana (rstandard() w R, SRE_ w SPSS) dzieli resztę przez s z całego modelu – opisuje ją hasło o resztach standaryzowanych. Zewnętrznie studentyzowana (rstudent(), SDR_, ang. deleted studentized residual) dzieli przez \(s_{(i)}\) z modelu bez danej osoby. Obie da się przeliczyć jedna na drugą, ale tylko wersja zewnętrzna ma dokładny rozkład t, więc tylko ona nadaje się do testu. Gdy piszesz w pracy „reszty studentyzowane”, dodaj, o którą wersję chodzi.
Najczęstsze błędy
- Podawanie wzoru z s całego modelu i nazywanie go resztą studentyzowaną zewnętrznie.
- Testowanie każdej reszty na poziomie 0,05 bez poprawki – przy 100 osobach średnio 5 „odstających” wyjdzie przypadkiem.
- Usuwanie osoby tylko dlatego, że jej reszta przekracza 2.
- Utożsamianie obserwacji odstającej z wpływową – szósta osoba z przykładu formalnie nie odstaje, a mocno zmienia prostą.
Bibliografia
- Cook, R. D., & Weisberg, S. (1982). Residuals and influence in regression. Chapman and Hall.
- Belsley, D. A., Kuh, E., & Welsch, R. E. (1980). Regression diagnostics: Identifying influential data and sources of collinearity. Wiley.
- Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). SAGE.
- Field, A., Miles, J., & Field, Z. (2012). Discovering statistics using R. SAGE.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówReszty standaryzowane
- Słownik wzorówOdległość Cooka
- Słownik wzorówWartość dźwigni (leverage)
- PoradnikRegresja liniowa – przykład
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
- Przykładowy raportAnaliza regresji
Przygotowujesz artykuł, doktorat lub grant?
Zaplanujemy i wykonamy analizy, przygotujemy raport z tabelami, wykresami i kodem R oraz pomożemy odpowiedzieć na uwagi recenzentów dotyczące statystyki.