

Rozkład normalny (Gaussa) – wzór i przykład
Rozkład normalny to symetryczna krzywa w kształcie dzwonu, którą opisują dwie liczby: średnia μ i odchylenie standardowe σ. Typowe pytanie z pracy dyplomowej: jaka część studentów śpi przed kolokwium najwyżej 7 godzin?
W prostych słowachWiększość wyników leży blisko średniej, a im dalej od niej, tym ich mniej – po obu stronach tak samo. Znając średnią i odchylenie standardowe, policzysz, jaka część osób mieści się w dowolnym przedziale. Prawdopodobieństwo to pole pod krzywą, a nie jej wysokość.
Kiedy korzystać z rozkładu normalnego?
- wyniki zmiennej ilościowej skupiają się symetrycznie wokół średniej (np. wynik testu wiedzy, wzrost);
- chcesz zamienić wynik na wynik standaryzowany z i porównać go z normą;
- liczysz przedział ufności dla średniej albo test t, które zakładają rozkład zbliżony do normalnego;
- sprawdzasz założenia testów (histogram, wykres Q-Q, test Shapiro-Wilka).
Rozkład normalny ma skośność i kurtozę nadwyżkową równe 0 – te miary mówią, jak bardzo Twoje dane od niego odbiegają. Dlaczego średnie z prób mają zwykle rozkład normalny, wyjaśnia centralne twierdzenie graniczne.
Wzór na rozkład normalny
- \(f(x)\)
- gęstość – wysokość krzywej w punkcie x; to nie jest prawdopodobieństwo
- \(\mu\)
- średnia – środek dzwonu (tu także mediana i moda)
- \(\sigma\)
- odchylenie standardowe – szerokość dzwonu
- \(\pi,\ e\)
- stałe matematyczne: π ≈ 3,14159 i liczba Eulera e ≈ 2,71828
- \(z\)
- wynik standaryzowany: o ile odchyleń standardowych x leży od średniej
- \(\Phi(z)\)
- pole pod krzywą rozkładu standardowego (μ = 0, σ = 1) na lewo od z – z tablic albo z funkcji
pnorm()
Każdy rozkład normalny sprowadzisz do rozkładu standardowego: wystarczy od wyniku odjąć średnią i podzielić różnicę przez σ. Dlatego jedna tablica wartości Φ(z) wystarcza do wszystkich zadań, niezależnie od tego, czy liczysz godziny snu, punkty z testu, czy wzrost.
Przykład krok po kroku
Przyjmijmy, że czas snu studentów przed kolokwium ma rozkład normalny z μ = 5 h i σ = 2 h (tyle wynoszą średnia i SD w naszym mini-zbiorze: 6, 2, 7, 4, 6 h).
| Czas snu | Wynik z | Prawdopodobieństwo (pole) |
|---|---|---|
| mniej niż 3 h | poniżej −1 | 0,1587 |
| od 3 do 5 h | od −1 do 0 | 0,3413 |
| od 5 do 7 h | od 0 do 1 | 0,3413 |
| więcej niż 7 h | powyżej 1 | 0,1587 |
| razem | 1,0000 |
- Standaryzacja. Dla 7 h: z = (7 − 5) / 2 = 1. Dla 3 h: z = (3 − 5) / 2 = −1.
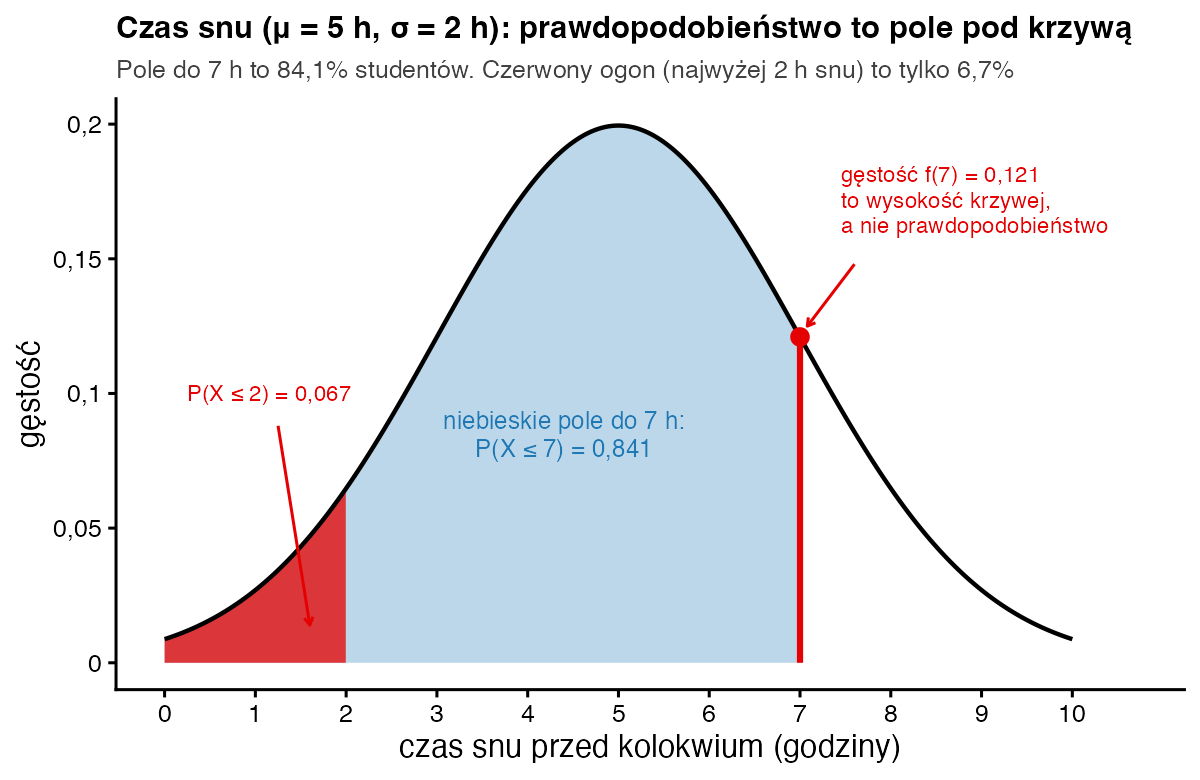
- Odczyt z tablic. Φ(1) = 0,8413, więc P(X ≤ 7) = 0,8413. Około 84% studentów śpi najwyżej 7 h, a 16% (1 − 0,8413) – dłużej.
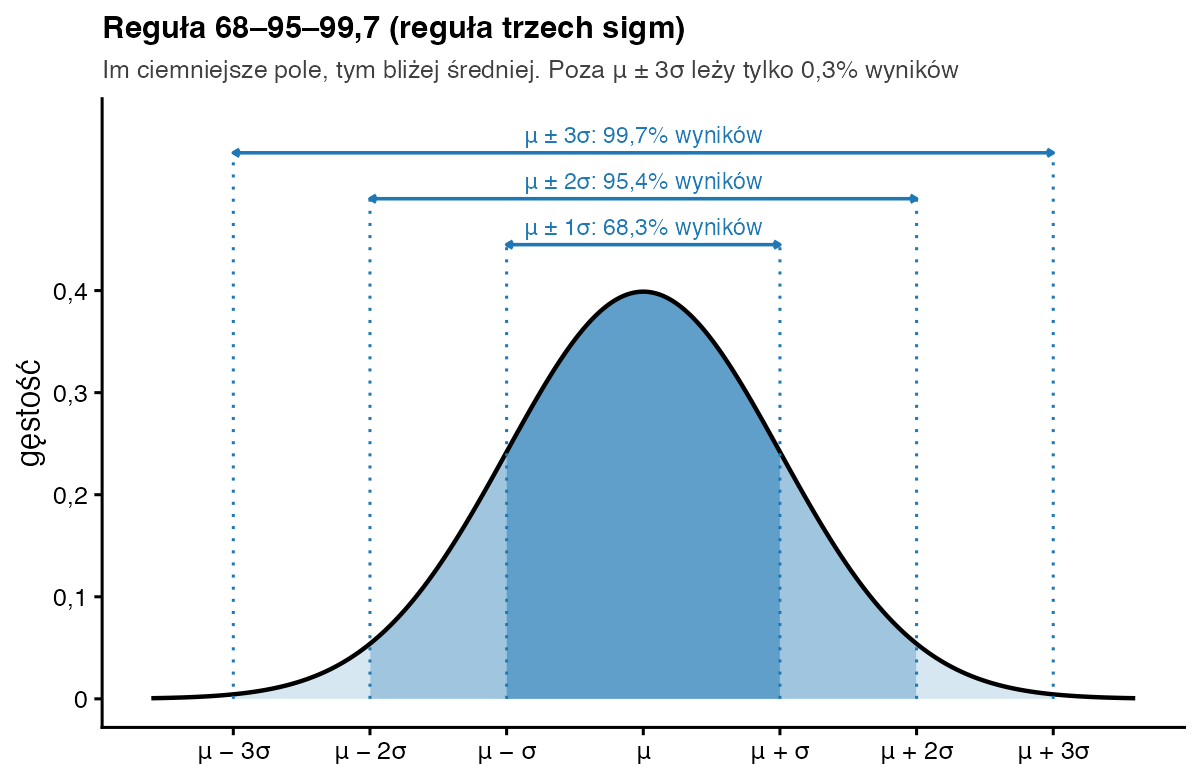
- Symetria. Na lewo od średniej leży połowa pola, więc P(5 < X < 7) = 0,8413 − 0,5 = 0,3413, a P(3 < X < 7) = 2 · 0,3413 ≈ 0,68. To pierwsza część reguły 68–95–99,7.
- Skrajny wynik. Dla 2 h: z = (2 − 5) / 2 = −1,5; Φ(−1,5) = 1 − 0,9332 = 0,0668. Tak krótko śpi około 7% studentów.
- Gęstość. f(7) = 1 / (2 · √(2π)) · e−0,5 = 0,1995 · 0,6065 = 0,121. To wysokość krzywej, a nie szansa – ta dla „dokładnie 7,000… h” wynosi 0.
Jak zinterpretować i opisać wynik?
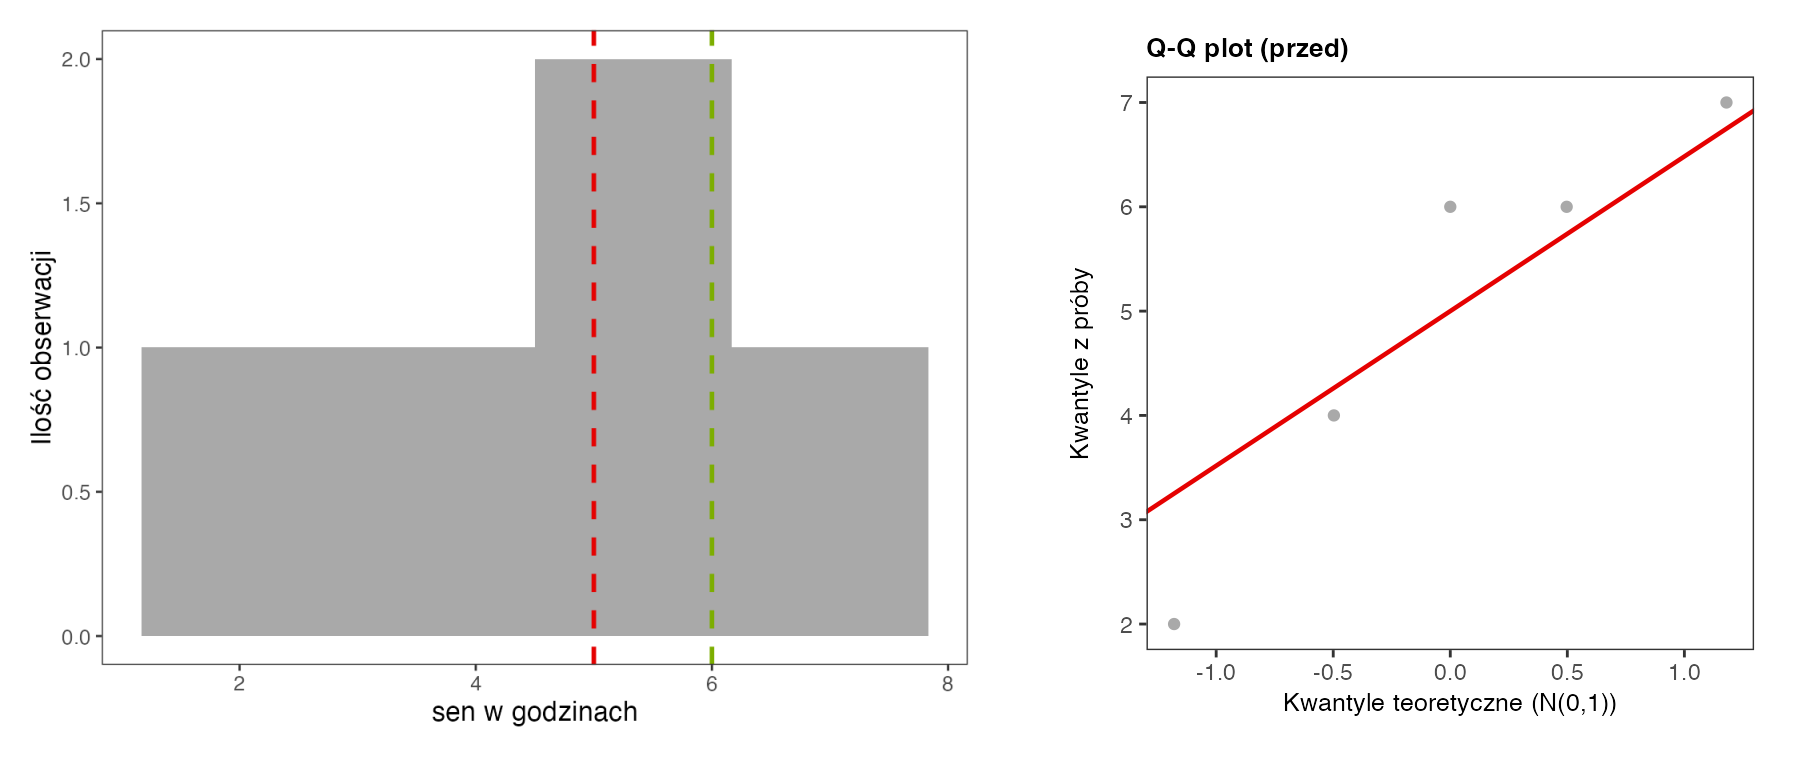
W pracy dyplomowej częściej niż pola pod krzywą sprawdzasz, czy Twoje wyniki mają rozkład zbliżony do normalnego, bo od tego zależy wybór testu. Patrz na histogram, wykres Q-Q, skośność, kurtozę i test Shapiro-Wilka. Wynik p > 0,05 oznacza tylko brak podstaw do odrzucenia hipotezy o normalności, a nie dowód normalności. Przy pięciu osobach test niemal niczego nie wykryje, a przy kilkuset wychwyci nawet drobne, praktycznie nieważne odchylenia.
Zapis w stylu APA: Rozkład czasu snu oceniono na podstawie histogramu, wykresu Q-Q i testu Shapiro-Wilka. Rozkład nie odbiegał istotnie od normalnego, W = 0,91; p = 0,440 (skośność = −0,94; kurtoza = −0,19), jednak przy n = 5 test ma bardzo małą moc.
Jak policzyć prawdopodobieństwa rozkładu normalnego w R?
mu <- 5; sigma <- 2                          # czas snu: średnia 5 h, SD 2 h

# 1) „ręcznie”: wynik z i gęstość według wzoru
z <- (7 - mu) / sigma; z                     # 1
1 / (sigma * sqrt(2 * pi)) * exp(-z^2 / 2)   # gęstość w punkcie 7 h

# 2) gotowymi funkcjami
dnorm(7, mean = mu, sd = sigma)              # gęstość (NIE prawdopodobieństwo)
pnorm(7, mean = mu, sd = sigma)              # P(X <= 7)
pnorm(7, mu, sigma) - pnorm(3, mu, sigma)    # P(3 < X < 7)
pnorm(2, mu, sigma)                          # P(X <= 2)
qnorm(0.975)                                 # granica środkowych 95% dla z

# 3) czy nasze 5 wyników może pochodzić z rozkładu normalnego?
shapiro.test(c(6, 2, 7, 4, 6))
Wynik w konsoli R:
[1] 1
[1] 0.1209854
[1] 0.1209854
[1] 0.8413447
[1] 0.6826895
[1] 0.0668072
[1] 1.959964

	Shapiro-Wilk normality test

data:  c(6, 2, 7, 4, 6)
W = 0.90531, p-value = 0.4399
W Excelu =ROZKŁ.NORMALNY(7;5;2;PRAWDA) daje 0,8413, a z argumentem FAŁSZ – gęstość 0,121.
Czy moje dane muszą mieć rozkład normalny?
Nie zawsze. Test t i ANOVA zakładają normalność w każdej grupie osobno, a regresja – normalność reszt, a nie całej zmiennej. Przy kilkudziesięciu osobach w grupie te testy są dość odporne, bo rozkład średnich zbliża się do normalnego nawet wtedy, gdy same wyniki są lekko skośne. Przy silnej skośności, wartościach odstających albo bardzo małych grupach wybierz test nieparametryczny. Pojedyncze pytanie na skali 1–5 to zmienna porządkowa, więc trudno mówić o jej normalności. Suma kilkunastu takich pytań (wynik całej skali) często ma już rozkład zbliżony do normalnego.
Najczęstsze błędy
- Liczenie „prawdopodobieństwa, że ktoś śpi dokładnie 7 h” z gęstości. Dla zmiennej ciągłej P(X = x) = 0.
- Nazywanie e „stałą Eulera”. To liczba Eulera (Nepera) ≈ 2,718; stała Eulera to inna liczba (≈ 0,577).
- Sprawdzanie normalności wszystkich wyników razem zamiast w grupach albo w resztach.
- Traktowanie p > 0,05 w teście normalności jako dowodu normalności.
- Używanie 1,96 przy małej próbie i SD policzonym z próby – wtedy potrzebny jest rozkład t.
Bibliografia
- Gauss, C. F. (1809). Theoria motus corporum coelestium in sectionibus conicis solem ambientium. Perthes & Besser.
- Altman, D. G., & Bland, J. M. (1995). Statistics notes: The normal distribution. BMJ, 310(6975), 298.
- Ghasemi, A., & Zahediasl, S. (2012). Normality tests for statistical analysis: A guide for non-statisticians. International Journal of Endocrinology and Metabolism, 10(2), 486–489. https://doi.org/10.5812/ijem.3505
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówTest Shapiro-Wilka
- Słownik wzorówCentralne twierdzenie graniczne
- Słownik wzorówSkośność
- Słownik wzorówOdchylenie standardowe
- PoradnikTest statystyczny – na czym polega
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.