

Wartość dźwigni (leverage) w regresji – wzór i przykład
Wartość dźwigni (h, ang. leverage) mówi, jak nietypowa jest obserwacja na osi predyktora, a więc jak mocno mogłaby pociągnąć za sobą linię regresji. Typowe pytanie z pracy dyplomowej: czy student, który uczył się dużo dłużej niż inni, nie decyduje sam o nachyleniu prostej?
W prostych słowachPomyśl o prostej regresji jak o desce podpartej w środku. Punkt blisko środka prawie jej nie przechyli. Punkt na samym końcu działa jak długie ramię dźwigni: wystarczy niewielka siła, by deska się przechyliła. Dźwignia zależy tylko od wartości x, a nie od wyniku y. Mówi więc o wpływie możliwym, a nie o tym, czy osoba naprawdę coś zmienia.
Kiedy sprawdzać wartość dźwigni?
- w diagnostyce regresji liniowej, razem z resztami i odległością Cooka;
- gdy w danych są skrajne wartości predyktora (bardzo długi czas nauki, bardzo wysoki wiek);
- w regresji wielorakiej, gdzie nietypowa bywa dopiero kombinacja wartości (np. dużo nauki przy bardzo krótkim śnie);
- przy małych próbach, w których każda skrajna obserwacja waży dużo.
Dźwignia jest składnikiem odległości Cooka i poprawki w resztach standaryzowanych. Szerszy kontekst znajdziesz w haśle o regresji liniowej.
Wzór na wartość dźwigni
- \(h_i\)
- dźwignia i-tej osoby
- \(n\)
- liczba obserwacji
- \(x_i,\ \bar{x}\)
- wartość predyktora u i-tej osoby i średnia predyktora
- \(\sum (x_j - \bar{x})^2\)
- suma kwadratów odchyleń predyktora od średniej
- \(p\)
- liczba parametrów modelu razem ze stałą (w regresji prostej p = 2); średnia dźwignia zawsze wynosi p/n
- \(H\)
- w regresji wielorakiej \(h_i\) to i-ty element na przekątnej macierzy daszkowej \(H = X(X^{T}X)^{-1}X^{T}\) – program liczy go za Ciebie
Przykład krok po kroku
Pięcioro studentów uczyło się do kolokwium 1, 2, 3, 4 i 5 godzin (to te same dane co w haśle o korelacji Pearsona). Dźwignię liczymy tylko z godzin – punkty nie są potrzebne.
| x | x − 3 | (x − 3)² | (x − 3)² / 10 | h = 0,2 + (x − 3)² / 10 |
|---|---|---|---|---|
| 1 | −2 | 4 | 0,4 | 0,6 |
| 2 | −1 | 1 | 0,1 | 0,3 |
| 3 | 0 | 0 | 0 | 0,2 |
| 4 | 1 | 1 | 0,1 | 0,3 |
| 5 | 2 | 4 | 0,4 | 0,6 |
| Σ = 15 | 0 | 10 | 1 | 2,0 |
- Średnia i suma kwadratów. \(\bar{x} = 15/5 = 3\); \(\sum (x - 3)^2 = 10\).
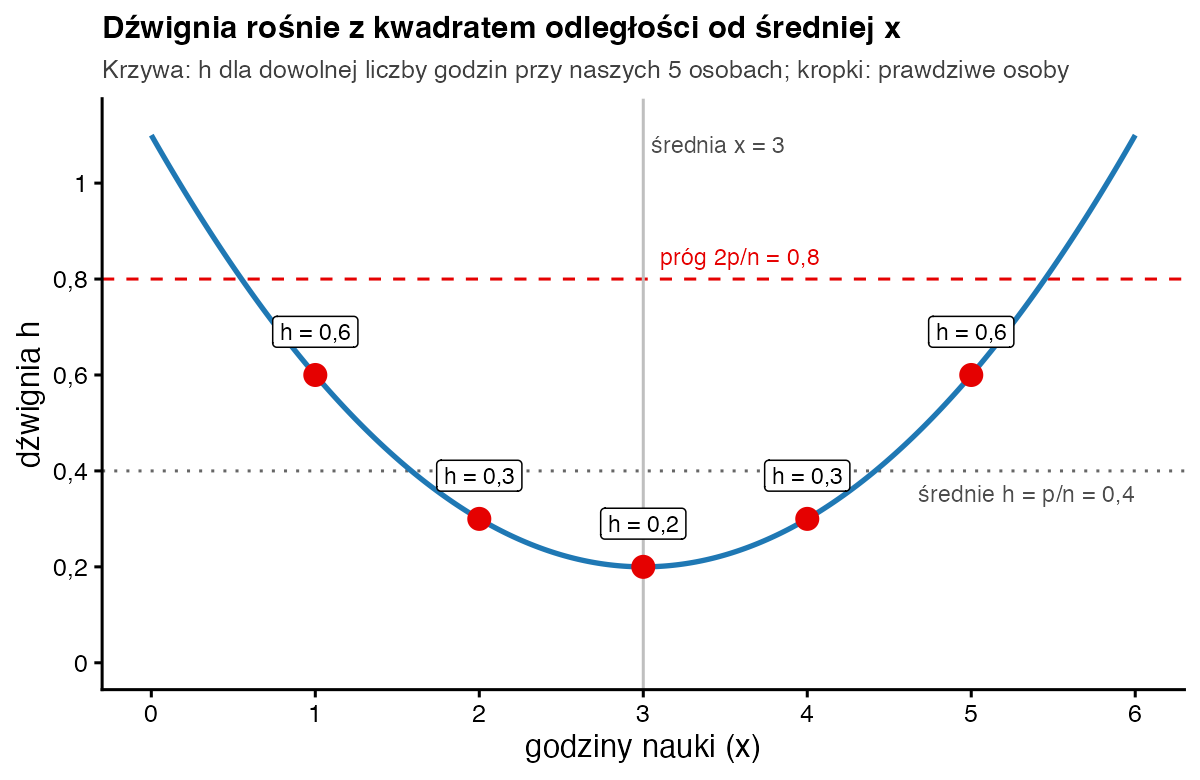
- Dźwignie. h = 1/5 + (x − 3)²/10, czyli 0,6; 0,3; 0,2; 0,3; 0,6. Najmniejszą dźwignię ma osoba ze średnią liczbą godzin.
- Kontrola. Suma dźwigni = 2 = p, a średnia 2/5 = 0,4 = p/n.
- Próg. 2p/n = 4/5 = 0,8 (Hoaglin i Welsch, 1978). Nikt go nie przekracza.
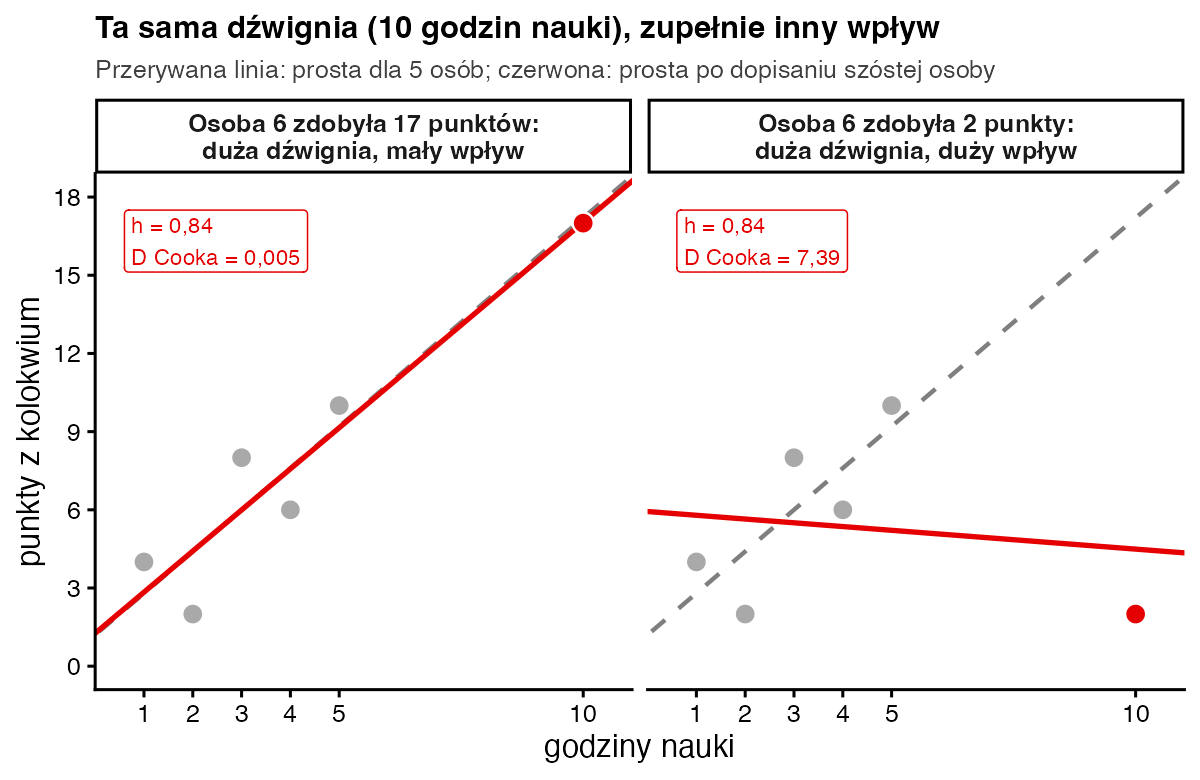
- Szósta osoba (10 godzin). Teraz \(\bar{x} = 25/6 \approx 4{,}17\) i \(\sum (x - \bar{x})^2 \approx 50{,}83\), więc \(h_6 = 1/6 + 5{,}83^2/50{,}83 \approx 0{,}17 + 0{,}67 = 0{,}84\) – więcej niż próg 2p/n = 4/6 = 0,67.
Jak zinterpretować i opisać wynik?
Wysoka dźwignia oznacza tylko, że obserwacja może mocno wpływać na model. Czy rzeczywiście wpływa, mówi dopiero odległość Cooka, która łączy dźwignię z resztą. Najczęściej używa się progu 2p/n (Hoaglin i Welsch, 1978). Przy bardzo małych próbach bywa on mało użyteczny: u nas wynosi 0,8, a skrajne osoby i tak mają 0,6. Traktuj próg jako wskazówkę, które obserwacje obejrzeć na wykresie, a nie jako regułę usuwania danych.
Zapis w stylu APA: Żadna obserwacja nie przekroczyła progu dźwigni 2p/n = 0,80 (Hoaglin i Welsch, 1978); największa wartość wyniosła h = 0,60.
Jak policzyć wartość dźwigni w R?
godziny <- c(1, 2, 3, 4, 5)
punkty  <- c(4, 2, 8, 6, 10)
n <- length(godziny); p <- 2            # p = stała + nachylenie

# 1) „ręcznie”: wzór dla regresji z jednym predyktorem
odch <- godziny - mean(godziny)
h <- 1 / n + odch^2 / sum(odch^2)
h                                       # 0.6 0.3 0.2 0.3 0.6
sum(h)                                  # zawsze równa p

# 2) gotową funkcją
m <- lm(punkty ~ godziny)
hatvalues(m)
2 * p / n                               # próg 2p/n

# 3) szósta osoba, która uczyła się 10 godzin
m6 <- lm(c(punkty, 2) ~ c(godziny, 10))
round(hatvalues(m6), 2)
Wynik w konsoli R:
[1] 0.6 0.3 0.2 0.3 0.6
[1] 2
  1   2   3   4   5
0.6 0.3 0.2 0.3 0.6
[1] 0.8
   1    2    3    4    5    6
0.36 0.26 0.19 0.17 0.18 0.84
Funkcja hatvalues() działa tak samo w regresji wielorakiej. Wtedy wzór z jednym predyktorem już nie wystarcza i R korzysta z macierzy daszkowej.
Co zrobić z obserwacją o dużej dźwigni?
Najpierw sprawdź, czy wartość nie jest pomyłką (10 godzin zamiast 1,0). Potem zastanów się, czy osoba należy do badanej populacji. Następnie policz odległość Cooka: jeśli jest mała, obserwacja po prostu wydłuża zakres danych i zwykle pomaga oszacować nachylenie. Jeśli jest duża, podaj wyniki z tą osobą i bez niej. Pamiętaj też, że model opisuje tylko zakres x z Twoich danych – nie przewiduj wyników dla 20 godzin nauki, skoro nikt tyle się nie uczył.
Najczęstsze błędy
- Uznawanie każdej obserwacji o dużej dźwigni za „złą” lub wpływową.
- Szukanie dźwigni na osi y – dźwignia w ogóle nie zależy od wyniku y.
- Mylenie dźwigni z resztą: punkt o dużej dźwigni może mieć resztę bliską zera, bo przyciąga do siebie prostą.
- Sprawdzanie w regresji wielorakiej każdego predyktora osobno – nietypowa bywa dopiero kombinacja wartości.
- Mechaniczne stosowanie progu 2p/n w bardzo małych próbach.
Bibliografia
- Hoaglin, D. C., & Welsch, R. E. (1978). The hat matrix in regression and ANOVA. The American Statistician, 32(1), 17–22. https://doi.org/10.1080/00031305.1978.10479237
- Belsley, D. A., Kuh, E., & Welsch, R. E. (1980). Regression diagnostics: Identifying influential data and sources of collinearity. Wiley.
- Fox, J. (2016). Applied regression analysis and generalized linear models (3rd ed.). SAGE.
- Field, A., Miles, J., & Field, Z. (2012). Discovering statistics using R. SAGE.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówOdległość Cooka
- Słownik wzorówReszty studentyzowane
- Słownik wzorówRegresja liniowa
- PoradnikRegresja liniowa – przykład
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
- Przykładowy raportAnaliza regresji
Przygotowujesz artykuł, doktorat lub grant?
Zaplanujemy i wykonamy analizy, przygotujemy raport z tabelami, wykresami i kodem R oraz pomożemy odpowiedzieć na uwagi recenzentów dotyczące statystyki.