

V Cramera – wzór, interpretacja i przykład
V Cramera mierzy siłę związku między dwiema zmiennymi jakościowymi w tabeli krzyżowej dowolnej wielkości. Typowe pytanie z pracy dyplomowej: jak silnie kierunek studiów wiąże się z preferowaną formą zajęć?
W prostych słowachTest chi-kwadrat mówi, czy związek w tabeli może być przypadkiem. V Cramera mówi, jak silny jest ten związek: od 0 (brak związku) do 1 (z jednej zmiennej da się bezbłędnie odgadnąć drugą). V nie ma znaku, bo przy kategoriach takich jak „online” czy „hybrydowo” nie ma kierunku „więcej–mniej”.
Kiedy stosować V Cramera?
- masz tabelę krzyżową dwóch zmiennych jakościowych, co najmniej 2×2 (np. 2×3, 3×4);
- wykonałeś test chi-kwadrat niezależności i chcesz podać wielkość efektu;
- chcesz porównać siłę związku w tabelach o różnej liczbie osób.
Dla tabeli 2×2 V jest równe wartości bezwzględnej współczynnika phi. Dla jednej zmiennej (test zgodności, np. 60 vs 40 osób) V nie ma sensu, bo tabela ma tylko jeden wiersz. Jak opisać całą ankietę krok po kroku, przeczytasz w artykule o opracowaniu wyników ankiety.
Wzór na V Cramera
- \(\chi^2\)
- statystyka testu chi-kwadrat dla tej tabeli
- \(N\)
- liczba wszystkich osób w tabeli
- \(r,\ k\)
- liczba wierszy i liczba kolumn
- \(df^{*}\)
- mniejsza z liczb r − 1 i k − 1; dla tabeli 2×3 df* = 1, dla 3×4 df* = 2
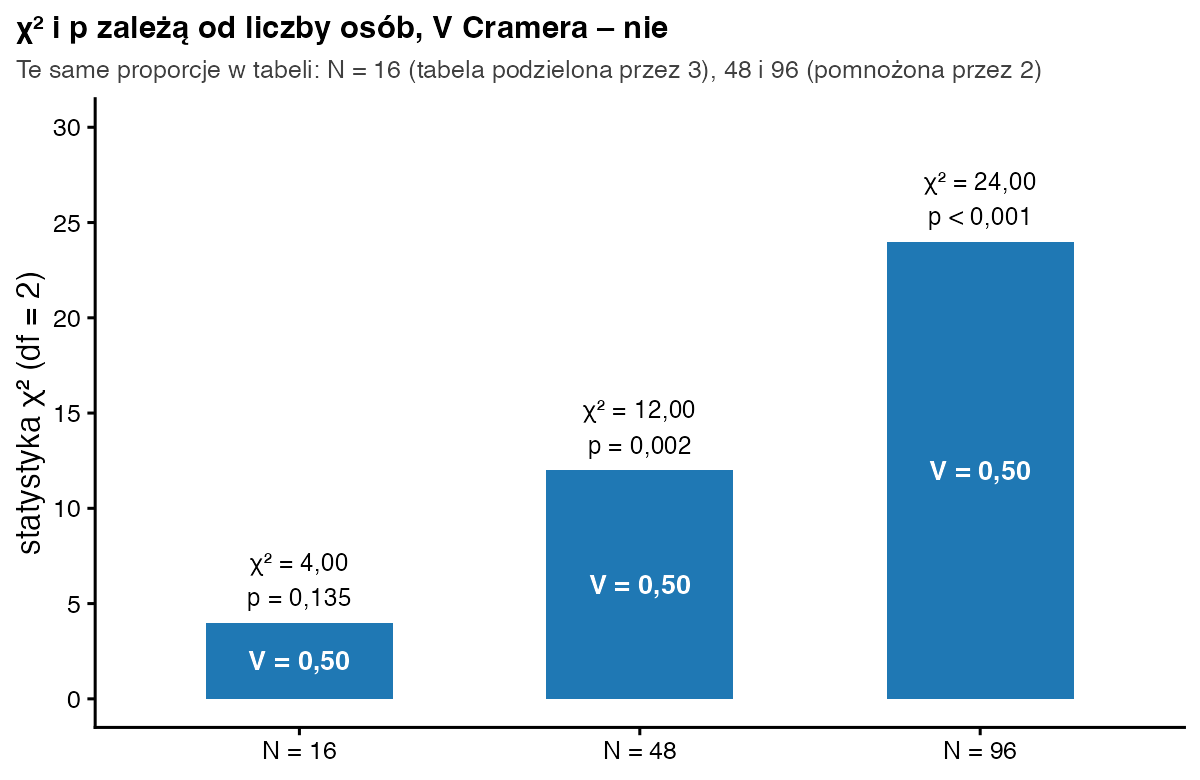
Dzielenie przez \(N \cdot df^{*}\) „usuwa” z χ² wpływ liczby osób i wielkości tabeli – dzięki temu V zawsze mieści się między 0 a 1.
Przykład krok po kroku
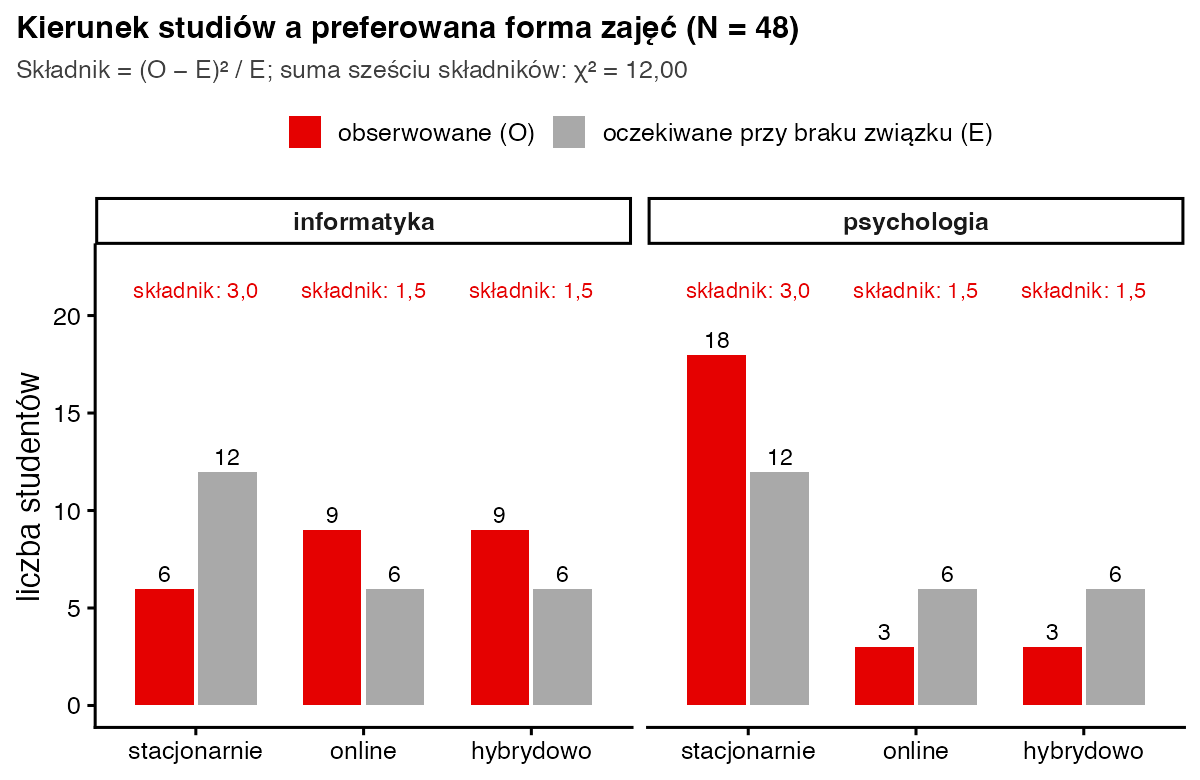
Zapytaliśmy 48 studentów (po 24 z informatyki i psychologii), jaką formę zajęć wolą. W nawiasach podajemy liczności oczekiwane E = suma wiersza · suma kolumny / N.
| Kierunek | Stacjonarnie | Online | Hybrydowo | Razem |
|---|---|---|---|---|
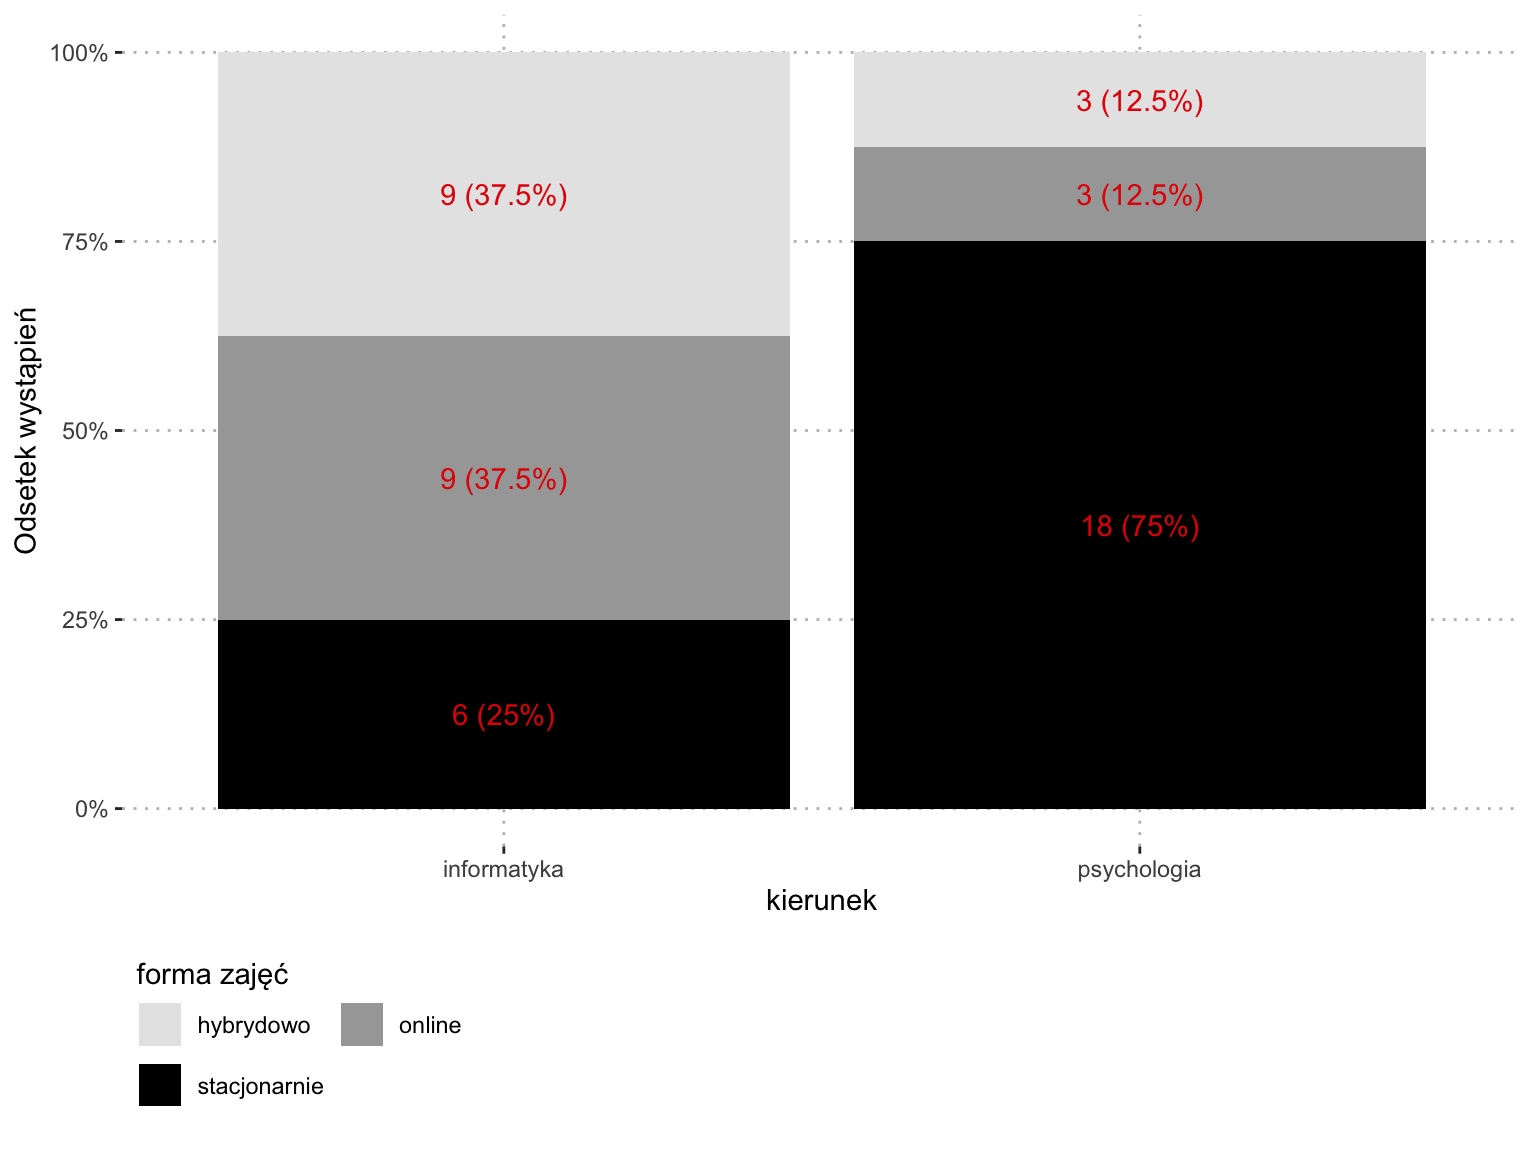
| informatyka | 6 (E = 12) | 9 (E = 6) | 9 (E = 6) | 24 |
| psychologia | 18 (E = 12) | 3 (E = 6) | 3 (E = 6) | 24 |
| Razem | 24 | 12 | 12 | 48 |
- Liczności oczekiwane. \(24 \cdot 24 / 48 = 12\) oraz \(24 \cdot 12 / 48 = 6\). Wszystkie są większe niż 5.
- Składniki. \((6 - 12)^2/12 = 3\), \((9 - 6)^2/6 = 1{,}5\), \((9 - 6)^2/6 = 1{,}5\); w drugim wierszu tak samo.
- Chi-kwadrat. χ² = 2 · (3 + 1,5 + 1,5) = 12,00; df = (2 − 1)(3 − 1) = 2; p = 0,0025.
- df*. min(2 − 1, 3 − 1) = 1.
- V Cramera. \(V = \sqrt{12 / (48 \cdot 1)} = \sqrt{0{,}25} = 0{,}50\).
Progi Cohena (1988) zależą od df*. Powstają z progów dla miary w (0,1; 0,3; 0,5) podzielonych przez \(\sqrt{df^{*}}\):
| df* | Mały | Średni | Duży |
|---|---|---|---|
| 1 | 0,10 | 0,30 | 0,50 |
| 2 | 0,07 | 0,21 | 0,35 |
| 3 | 0,06 | 0,17 | 0,29 |
| 4 | 0,05 | 0,15 | 0,25 |
Jak zinterpretować i opisać wynik?
Przy df* = 1 V = 0,50 osiąga umowny próg efektu dużego (Cohen, 1988). Gdyby ta sama wartość wyszła w tabeli 3×4 (df* = 2), byłaby jeszcze wyraźniej duża, bo próg wynosi tam 0,35. V nie mówi, „w którą stronę” idzie związek – to odczytasz z odsetków w tabeli: psychologowie częściej wybierali zajęcia stacjonarne. W małych próbach V bywa zawyżone; wersja z korektą Bergsmy (2013) daje tu 0,46. Związek nie dowodzi też przyczynowości.
Zapis w stylu APA: Kierunek studiów był istotnie związany z preferowaną formą zajęć, χ²(2, N = 48) = 12,00; p = 0,002; V = 0,50. Zajęcia stacjonarne wybrało 75% studentów psychologii i 25% studentów informatyki.
Jeśli w pracy masz kilka tabel krzyżowych, przy każdym V podaj także wymiary tabeli albo df*, np. „V = 0,50 (tabela 2×3, df* = 1)”. Czytelnik od razu sprawdzi wtedy w Tabeli 2, czy to efekt mały, średni czy duży. Bez tej informacji to samo V = 0,30 może oznaczać efekt średni (df* = 1) albo już duży (df* = 4).
Jak policzyć V Cramera w R?
tabela <- matrix(c( 6, 9, 9,
                   18, 3, 3), nrow = 2, byrow = TRUE,
                 dimnames = list(kierunek = c("informatyka", "psychologia"),
                                 forma = c("stacjonarnie", "online", "hybrydowo")))

# 1) „ręcznie”, dokładnie według wzoru
chi2 <- unname(chisq.test(tabela)$statistic)  # 12
df_gw <- min(dim(tabela)) - 1                 # df* = min(r, k) - 1 = 1
sqrt(chi2 / (sum(tabela) * df_gw))            # V = 0.5

# 2) gotowe funkcje: test chi-kwadrat i V z 95% przedziałem ufności
chisq.test(tabela)
effectsize::cramers_v(tabela, adjust = FALSE, alternative = "two.sided")
Wynik w konsoli R:
[1] 0.5

	Pearson's Chi-squared test

data:  tabela
X-squared = 12, df = 2, p-value = 0.002479

Cramer's V |       95% CI
-------------------------
0.50       | [0.18, 0.77]
Argument adjust = FALSE daje klasyczne V ze wzoru. Bez niego pakiet effectsize poda wersję skorygowaną (tu 0,46) – w pracy napisz, którą wersję raportujesz.
V Cramera czy phi – co wybrać?
Dla tabeli 2×2 obie miary dają tę samą liczbę (V = |φ|), ale phi ma znak, który mówi o kierunku związku, gdy obie kategorie da się sensownie zakodować jako 0 i 1. Dla większych tabel phi może przekroczyć 1, więc wybierz V Cramera. Jeśli w pracy masz kilka tabel różnej wielkości, raportuj V i przy interpretacji zawsze sprawdzaj df*.
Najczęstsze błędy
- Ocena siły związku według progów 0,1/0,3/0,5 bez sprawdzenia df*.
- Liczenie V dla jednej zmiennej (test zgodności) – wtedy df* = 0 i wzór nie działa.
- Szukanie w V kierunku związku – V jest zawsze dodatnie.
- Ocenianie siły związku po wielkości χ² albo p, które rosną razem z N.
- Pomijanie małych liczności oczekiwanych – wtedy p trzeba policzyć testem dokładnym Fishera.
Bibliografia
- Cramér, H. (1946). Mathematical methods of statistics. Princeton University Press.
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Bergsma, W. (2013). A bias-correction for Cramér's V and Tschuprow's T. Journal of the Korean Statistical Society, 42(3), 323–328.
- Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówTest chi-kwadrat
- Słownik wzorówWspółczynnik phi (φ)
- Słownik wzorówCzęstości i procenty
- PoradnikTest chi-kwadrat – przykład
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
- Przykładowy raportTabele krzyżowe i chi-kwadrat
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.