

Test chi-kwadrat – przykład krok po kroku na danych z ankiety
Test chi-kwadrat niezależności sprawdza, czy dwie zmienne jakościowe, np. dwie odpowiedzi z ankiety, są ze sobą powiązane. Pokazujemy cały przebieg: od tabeli krzyżowej, przez liczności oczekiwane i V Cramera, po reszty standaryzowane, akapit APA i tabelę do pracy. Pytanie z pracy dyplomowej: czy korzystanie z korepetycji zależy od kierunku studiów?
W skrócieTabela krzyżowa → liczności oczekiwane (założenie) → χ² i p → V Cramera → reszty standaryzowane, czyli gdzie leży związek → opis w stylu APA, tabela i wykres. Wzór i obliczenia ręczne na tabeli 2×2 znajdziesz w haśle test chi-kwadrat – wzór i przykład.
Pytanie badawcze i hipotezy
W ankiecie 90 studentów (po 30 z ekonomii, informatyki i psychologii) odpowiedziało na pytanie: „Czy w tym roku akademickim korzystasz z korepetycji?” (tak/nie). Obie zmienne są jakościowe, więc stosujemy test chi-kwadrat niezależności. Nie myl go z testem zgodności, który porównuje rozkład jednej zmiennej z założonymi proporcjami.
- H0: korzystanie z korepetycji nie zależy od kierunku – odsetek odpowiedzi „tak” jest w populacji taki sam na każdym kierunku;
- H1: korzystanie z korepetycji zależy od kierunku; poziom istotności α = 0,05.
Dane: tabela krzyżowa z ankiety
| Kierunek | Korepetycje: tak | Korepetycje: nie | Razem |
|---|---|---|---|
| ekonomia | 12 (E = 12) | 18 (E = 18) | 30 |
| informatyka | 18 (E = 12) | 12 (E = 18) | 30 |
| psychologia | 6 (E = 12) | 24 (E = 18) | 30 |
| Razem | 36 | 54 | 90 |
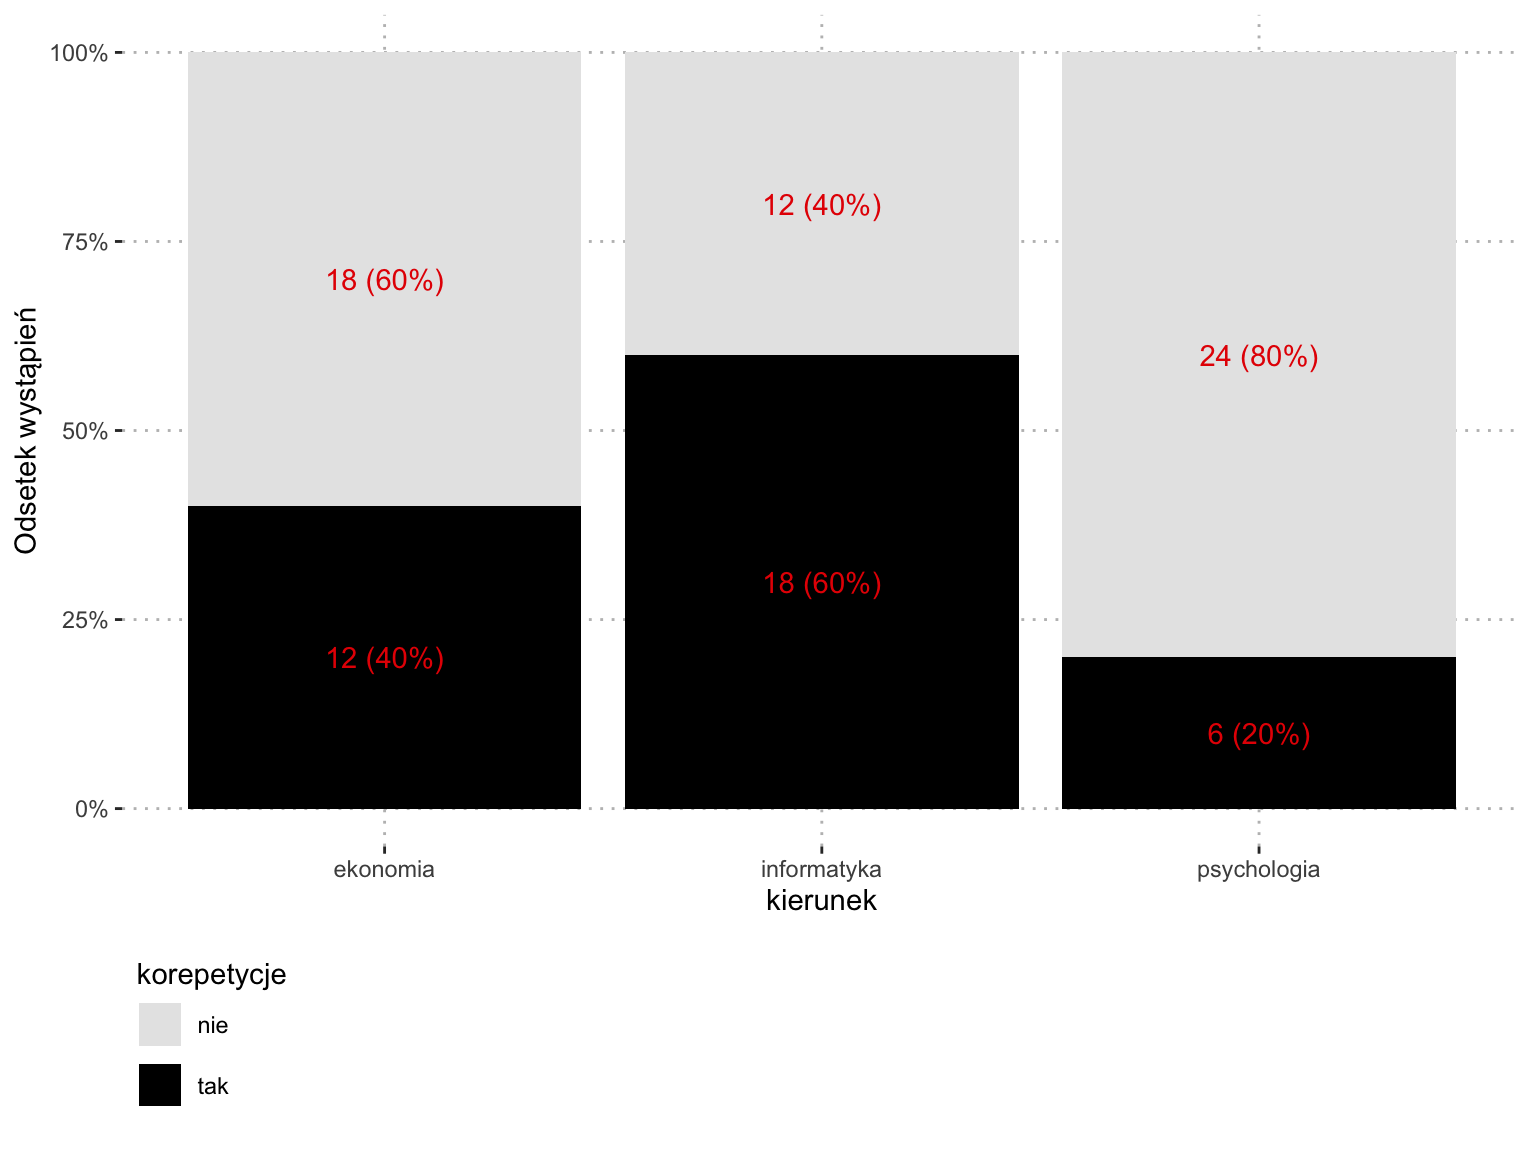
Z korepetycji korzysta 40% badanych: 60% studentów informatyki, 40% ekonomii i 20% psychologii. Odsetki liczymy w obrębie kierunku, bo to kierunki porównujemy.
Sprawdzenie założeń
- Każda osoba jest w jednej kratce. Test nie nadaje się do pytań wielokrotnego wyboru, w których ta sama osoba trafia do kilku kratek.
- W tabeli są liczności, a nie procenty.
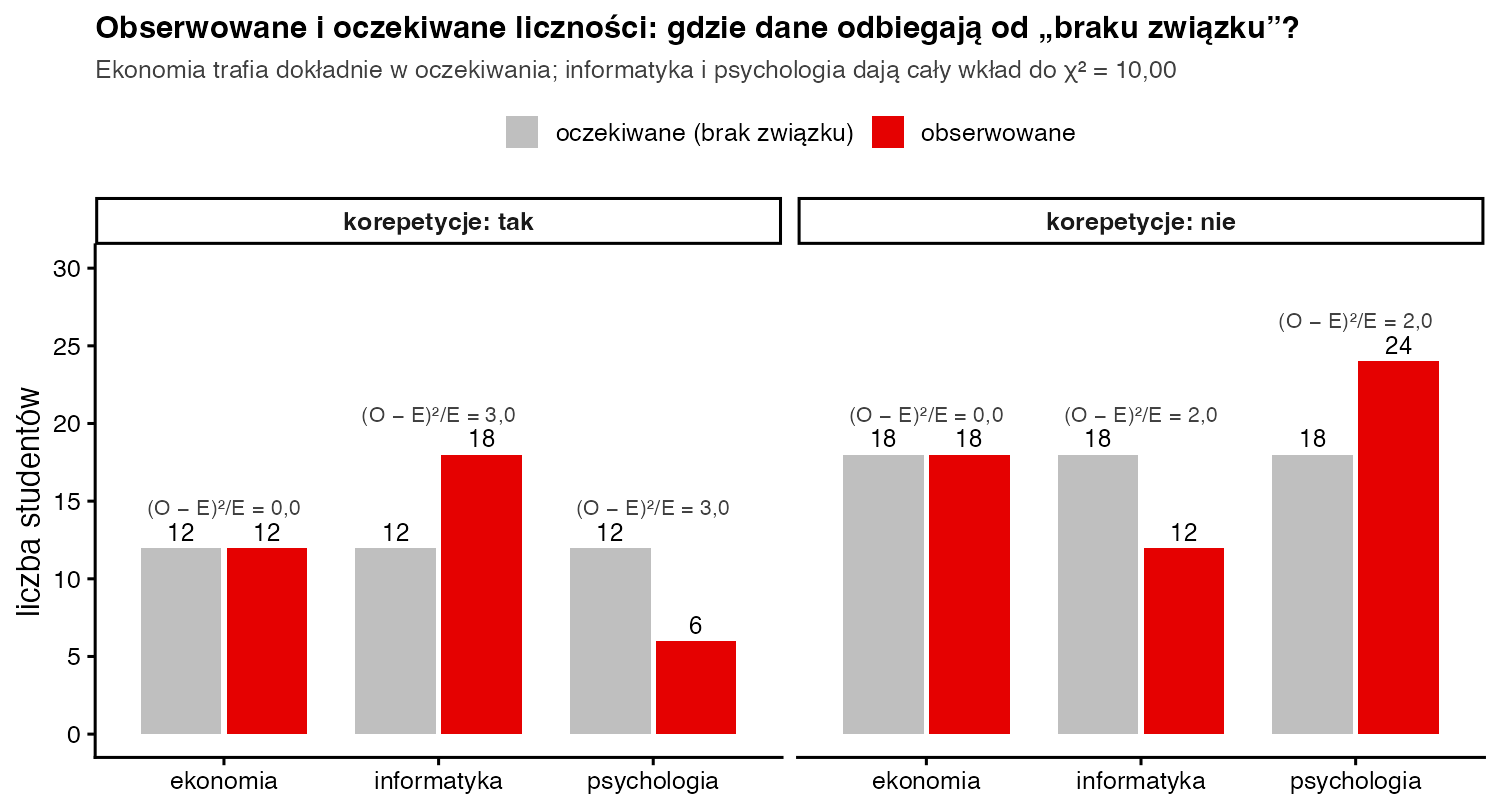
- Liczności oczekiwane są dość duże. E = suma wiersza · suma kolumny / N, czyli 30 · 36 / 90 = 12 oraz 30 · 54 / 90 = 18. Wszystkie E są większe niż 5, więc przybliżenie rozkładem χ² jest uprawnione (Cochran, 1954).
Wynik testu i V Cramera
- Test chi-kwadrat: χ²(2, N = 90) = 10,00; p = 0,007. Stopnie swobody: (3 − 1)(2 − 1) = 2. Odrzucamy H0.
- Siła związku: V Cramera = \(\sqrt{10 / (90 \cdot 1)}\) = 0,33; 95% CI [0,10; 0,53]. Jedynka w mianowniku to mniejsza z dwóch liczb: liczba wierszy − 1 i liczba kolumn − 1. Tabela ma dwie kolumny, więc obowiązują progi Cohena (1988) 0,10 / 0,30 / 0,50 – to związek średni.
- Co dalej: samo χ² mówi tylko, że odsetki „tak” nie są wszędzie takie same. Gdzie leży różnica, pokażą reszty standaryzowane.
Reszty standaryzowane – gdzie leży związek?
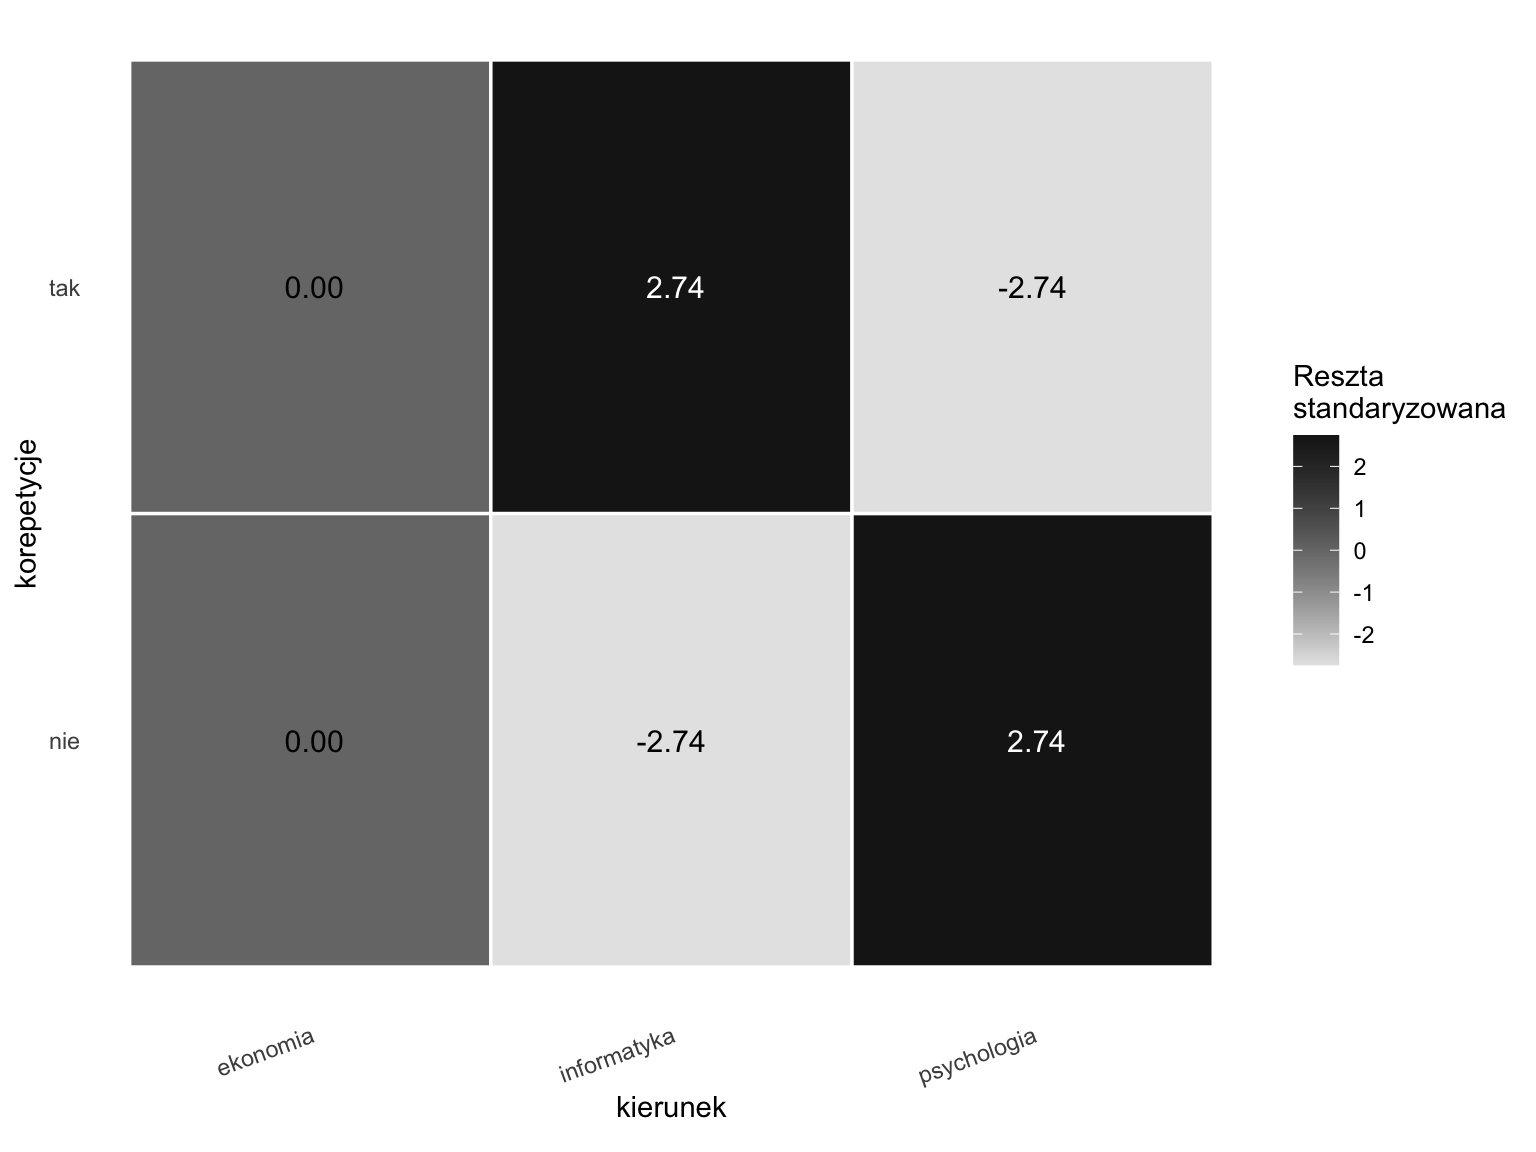
Skorygowana reszta standaryzowana (Agresti, 2013) mówi, o ile odchyleń standardowych liczność w kratce odbiega od oczekiwanej. Wartości poza ±1,96 wskazują kratki częstsze lub rzadsze, niż wynikałoby z przypadku. Na informatyce reszta dla odpowiedzi „tak” wynosi +2,74, na psychologii −2,74, a na ekonomii 0,00. Przy sześciu kratkach warto zaostrzyć próg poprawką Bonferroniego do ±2,64 (Sharpe, 2015). Obie reszty nadal go przekraczają.
Jak opisać wynik w pracy?
Zapis w stylu APA: Korzystanie z korepetycji było istotnie związane z kierunkiem studiów, χ²(2, N = 90) = 10,00; p = 0,007; V = 0,33. Z korepetycji korzystało 60% studentów informatyki, 40% studentów ekonomii i 20% studentów psychologii. Analiza reszt standaryzowanych wykazała, że studenci informatyki korzystali z korepetycji częściej, a studenci psychologii rzadziej, niż wynikałoby z przypadku (z = ±2,74).
| Kierunek | Korzysta n (%) | Nie korzysta n (%) | Reszta std. („tak”) |
|---|---|---|---|
| ekonomia | 12 (40,0) | 18 (60,0) | 0,00 |
| informatyka | 18 (60,0) | 12 (40,0) | 2,74 |
| psychologia | 6 (20,0) | 24 (80,0) | −2,74 |
| Razem | 36 (40,0) | 54 (60,0) | – |
W nocie pod tabelą podaj wynik testu i zaznacz, że odsetki liczono w obrębie kierunku. Pod wykresem wyjaśnij, że każdy słupek to 100% studentów danego kierunku. Pełny raport z takiej analizy pokazuje przykładowy raport SZTOS z tabel krzyżowych, a opis całej ankiety – wpis opracowanie wyników ankiety.
Cała analiza w R
# Dane z ankiety (N = 90). Z surowych danych: tabela <- table(ankieta$kierunek, ankieta$korepetycje)
tabela <- matrix(c(12, 18,
                   18, 12,
                    6, 24), nrow = 3, byrow = TRUE,
                 dimnames = list(kierunek = c("ekonomia", "informatyka", "psychologia"),
                                 korepetycje = c("tak", "nie")))

# 1) opis: liczności z sumami i odsetki w wierszach (w obrębie kierunku)
addmargins(tabela)
round(100 * prop.table(tabela, margin = 1), 1)

# 2) test chi-kwadrat niezależności i liczności oczekiwane (założenie: E >= 5)
test <- chisq.test(tabela)
test
test$expected

# 3) reszty standaryzowane: |z| > 1,96, a z poprawką na 6 kratek |z| > 2,64
round(test$stdres, 2)

# 4) siła związku: V Cramera z 95% przedziałem ufności
effectsize::cramers_v(tabela, adjust = FALSE, alternative = "two.sided")
Wynik w konsoli R:
             korepetycje
kierunek      tak nie Sum
  ekonomia     12  18  30
  informatyka  18  12  30
  psychologia   6  24  30
  Sum          36  54  90
             korepetycje
kierunek      tak nie
  ekonomia     40  60
  informatyka  60  40
  psychologia  20  80

	Pearson's Chi-squared test

data:  tabela
X-squared = 10, df = 2, p-value = 0.006738

             korepetycje
kierunek      tak nie
  ekonomia     12  18
  informatyka  12  18
  psychologia  12  18
             korepetycje
kierunek        tak   nie
  ekonomia     0.00  0.00
  informatyka  2.74 -2.74
  psychologia -2.74  2.74
Cramer's V |       95% CI
-------------------------
0.33       | [0.10, 0.53]
Co zrobić, gdy liczności oczekiwane są za małe?
Gdy więcej niż 20% kratek ma E < 5 albo któraś ma E < 1, przybliżenie χ² przestaje być wiarygodne. Masz dwa wyjścia: dokładny test Fishera (w R fisher.test() działa także dla tabel większych niż 2×2) albo sensowne połączenie rzadkich kategorii, np. małych kierunków w „inne”. Na naszych danych test Fishera daje p = 0,007, czyli ten sam wniosek. W tabeli 2×2 siłę związku opisz współczynnikiem phi i napisz, czy stosujesz poprawkę Yatesa.
Pytania promotora i recenzenta
Czy mogę napisać, że kierunek wpływa na korzystanie z korepetycji?
Nie. Test chi-kwadrat wykrywa związek, a kierunku nikt nie przydzielał losowo. Różnicę mogą tłumaczyć inne czynniki, np. liczba przedmiotów ścisłych w programie studiów. Pisz: „korzystanie z korepetycji było związane z kierunkiem”.
Czy V = 0,33 to dużo?
Przy tabeli z dwiema kolumnami to umowny efekt średni. Dla większych tabel progi są niższe, dlatego zawsze podawaj wymiary tabeli – tabelę progów znajdziesz w haśle o V Cramera.
Bibliografia
- Pearson, K. (1900). On the criterion that a given system of deviations from the probable in the case of a correlated system of variables is such that it can be reasonably supposed to have arisen from random sampling. The London, Edinburgh, and Dublin Philosophical Magazine and Journal of Science, 50(302), 157–175. https://doi.org/10.1080/14786440009463897
- Cochran, W. G. (1954). Some methods for strengthening the common χ² tests. Biometrics, 10(4), 417–451.
- Cramér, H. (1946). Mathematical methods of statistics. Princeton University Press.
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Agresti, A. (2013). Categorical data analysis (3rd ed.). Wiley.
- Sharpe, D. (2015). Your chi-square test is statistically significant: Now what? Practical Assessment, Research & Evaluation, 20(8).
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówTest chi-kwadrat
- Słownik wzorówV Cramera
- Słownik wzorówWspółczynnik phi (φ)
- PoradnikOpracowanie wyników ankiety
- PoradnikTesty parametryczne
- Przykładowy raportTabele krzyżowe i chi-kwadrat
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.