

Analiza mediacji – przykład i interpretacja efektu pośredniego
Analiza mediacji sprawdza, czy związek zmiennej X ze zmienną Y przechodzi przez trzecią zmienną – mediator M. Typowe pytanie z pracy dyplomowej: czy studenci, którzy dłużej się uczą, piszą lepiej kolokwium dlatego, że rozwiązują więcej zadań próbnych?
W skrócieLiczysz ścieżki a (X → M), b (M → Y przy stałym X) i c′ (X → Y przy stałym M). Efekt pośredni to iloczyn a × b, a o jego istotności decyduje bootstrapowy przedział ufności. Metoda Barona i Kenny’ego oraz test Sobela to dziś historia. Mediacja policzona na danych z jednego pomiaru nie dowodzi przyczynowości.
Krok 1. Hipoteza i dane
Hipoteza: liczba godzin nauki (X) wiąże się z punktami z kolokwium (Y) między innymi przez liczbę rozwiązanych zestawów zadań próbnych (M). Hipoteza zerowa dotyczy efektu pośredniego: ab = 0. Kierunek X → M → Y to założenie badacza, a nie wynik obliczeń.
| Zmienna | Wyniki kolejnych osób | M | SD |
|---|---|---|---|
| X: godziny nauki | 1, 2, 2, 3, 3, 4, 4, 5, 5, 6, 6, 7 | 4,00 | 1,86 |
| M: zestawy zadań próbnych | 4, 1, 2, 3, 6, 6, 3, 8, 5, 6, 8, 8 | 5,00 | 2,41 |
| Y: punkty z kolokwium (0–20) | 6, 6, 8, 7, 13, 10, 8, 14, 11, 13, 17, 19 | 11,00 | 4,29 |
Krok 2. Ścieżki z trzech regresji
Każda ścieżka to współczynnik z regresji liniowej. Jak je czytać, pokazujemy we wpisie regresja liniowa – przykład.
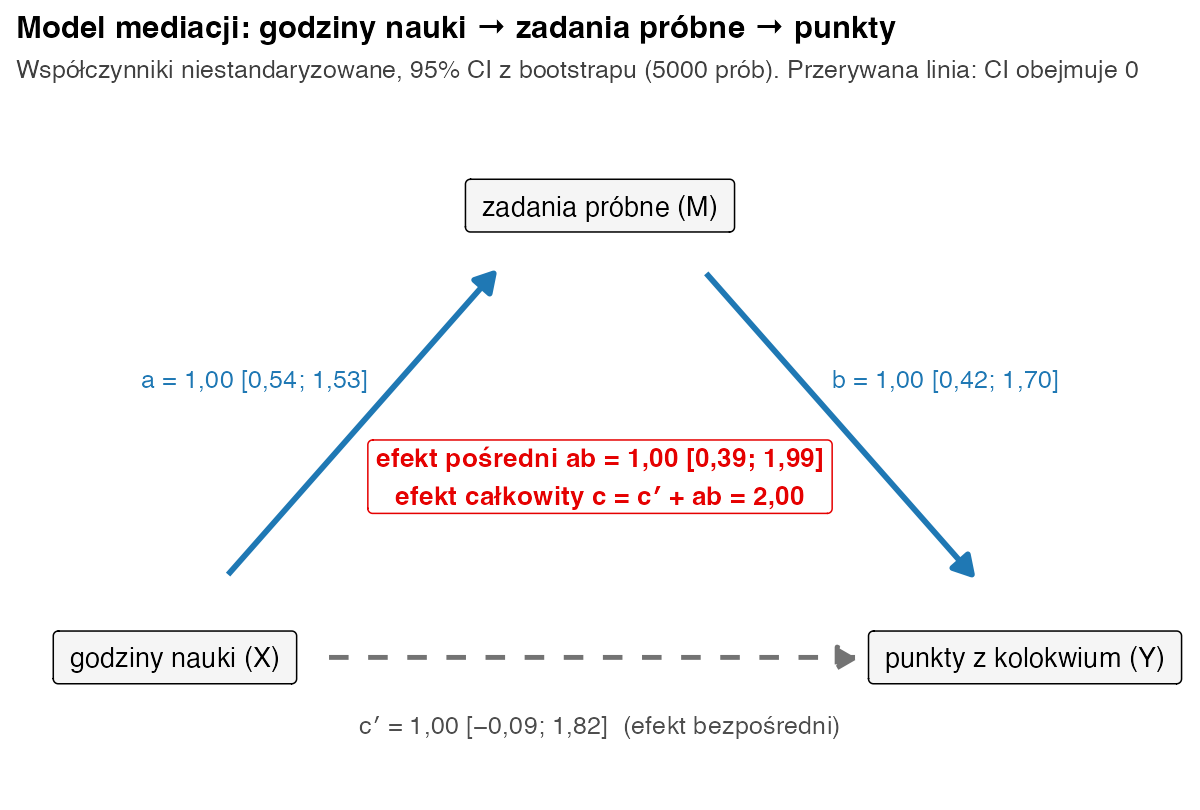
- Ścieżka a – regresja M na X: a = 1. Każda godzina nauki więcej to średnio jeden zestaw zadań więcej.
- Ścieżki b i c′ – regresja Y na X i M jednocześnie: b = 1 (zestaw więcej to punkt więcej przy tej samej liczbie godzin) oraz c′ = 1 (efekt bezpośredni godzin przy tej samej liczbie zestawów).
- Efekt pośredni: ab = 1 × 1 = 1 punkt na godzinę nauki.
- Efekt całkowity – regresja Y na X: c = 2. Sprawdzenie: c = c′ + ab = 1 + 1 = 2. Połowa związku godzin z punktami „przechodzi” przez zadania.
Krok 3. Bootstrapowy przedział ufności dla ab
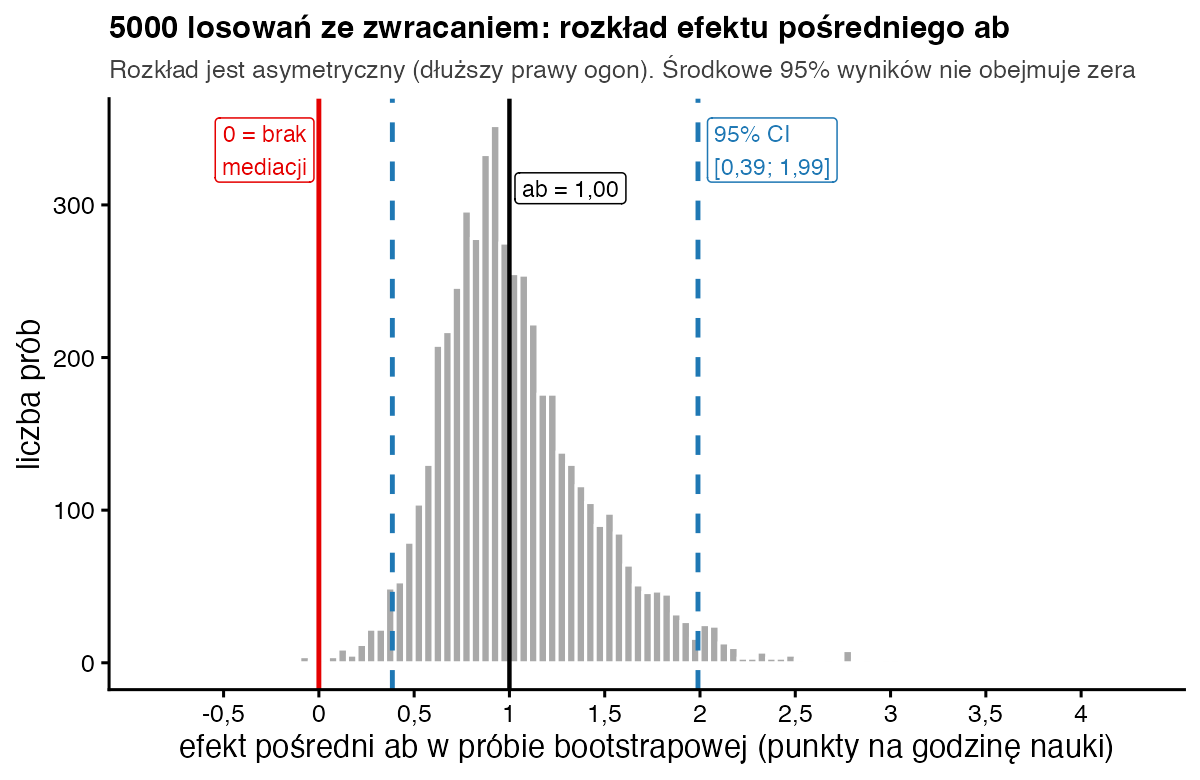
Rozkład iloczynu a × b jest zwykle asymetryczny, więc testy zakładające rozkład normalny (jak test Sobela) mają małą moc. Dlatego stosujemy bootstrap: program 5000 razy losuje ze zwracaniem 12 osób, w każdej próbie liczy ab, a granice 95% przedziału to 2,5. i 97,5. centyl wyników. Tu przedział wynosi [0,39; 1,99]. Nie obejmuje zera, więc efekt pośredni jest istotny statystycznie. Przedział dla c′ [−0,09; 1,82] obejmuje zero. Przy 12 osobach to jednak słaby dowód, że efektu bezpośredniego nie ma.
Dlaczego nie metoda Barona i Kenny’ego?
Klasyczna procedura Barona i Kenny’ego (1986) wymagała istotnego efektu całkowitego c, a efekt pośredni oceniano testem Sobela, który zakłada normalny rozkład ab. Dziś efekt pośredni testuje się bezpośrednio, bootstrapowym przedziałem ufności (Preacher i Hayes, 2008; Hayes, 2022). Mediacja bywa obecna także przy nieistotnym c (Zhao i in., 2010). Unikaj też etykiet „mediacja pełna” i „częściowa”: zależą głównie od liczebności próby (Rucker i in., 2011).
Krok 4. Jak opisać wynik w pracy?
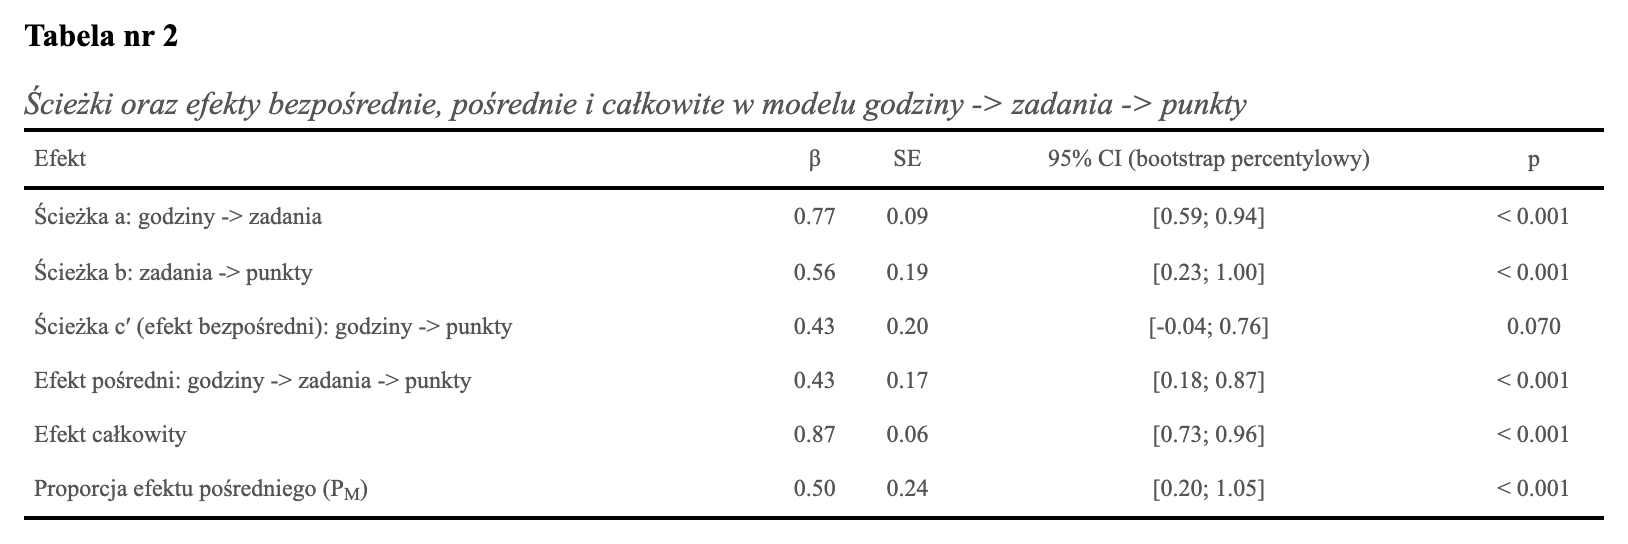
Zapis w stylu APA: Model mediacji prostej oszacowano w pakiecie lavaan metodą największej wiarygodności (N = 12). Przedziały ufności wyznaczono bootstrapem percentylowym (5000 prób). Więcej godzin nauki wiązało się z większą liczbą rozwiązanych zestawów zadań, a = 1,00; 95% CI [0,54; 1,53]. Więcej zestawów wiązało się z wyższym wynikiem kolokwium przy tej samej liczbie godzin, b = 1,00; 95% CI [0,42; 1,70]. Efekt pośredni był istotny, ab = 1,00; 95% CI [0,39; 1,99]; β = 0,43. Efekt bezpośredni okazał się nieistotny, c′ = 1,00; 95% CI [−0,09; 1,82]. Efekt całkowity wyniósł c = 2,00; 95% CI [1,24; 2,63].
| Efekt | b | 95% CI (bootstrap) | β |
|---|---|---|---|
| a: godziny → zadania | 1,00 | [0,54; 1,53] | 0,77 |
| b: zadania → punkty | 1,00 | [0,42; 1,70] | 0,56 |
| c′: godziny → punkty (bezpośredni) | 1,00 | [−0,09; 1,82] | 0,43 |
| ab: efekt pośredni | 1,00 | [0,39; 1,99] | 0,43 |
| c: efekt całkowity | 2,00 | [1,24; 2,63] | 0,87 |
W nocie podaj liczbę prób bootstrapowych, typ przedziału i ziarno losowania. Model wyjaśnia 59% wariancji liczby zestawów i 88% wariancji punktów.
Czy mediacja dowodzi, że nauka „powoduje” punkty?
Nie. Dane z jednego pomiaru pasują też do innych kierunków, np. punkty z poprzedniego kolokwium mogą zachęcać do zadań. Mogą też działać zmienne zakłócające, np. zdolności matematyczne. Wniosek przyczynowy wymaga planu badania: losowego przydziału do warunków X, pomiarów w kolejnych terminach i kontroli zmiennych zakłócających. W pracy pisz więc o „efekcie pośrednim w modelu” i „związku”, a nie o „wpływie”.
Cała analiza w R
library(lavaan)
# 12 studentów: godziny nauki (X), rozwiązane zestawy zadań próbnych (M), punkty z kolokwium (Y)
dane <- data.frame(godziny = c(1, 2, 2, 3, 3, 4, 4, 5, 5, 6, 6, 7),
                   zadania = c(4, 1, 2, 3, 6, 6, 3, 8, 5, 6, 8, 8),
                   punkty  = c(6, 6, 8, 7, 13, 10, 8, 14, 11, 13, 17, 19))

# 1) ścieżki z trzech regresji: a, b, c′ oraz efekt całkowity c
a  <- coef(lm(zadania ~ godziny, dane))[["godziny"]]
m  <- coef(lm(punkty ~ godziny + zadania, dane)); b <- m[["zadania"]]; c_prim <- m[["godziny"]]
c_calk <- coef(lm(punkty ~ godziny, dane))[["godziny"]]
round(c(a = a, b = b, c_prim = c_prim, ab = a * b, c = c_calk), 2)

# 2) ten sam model w lavaan z bootstrapem (5000 prób, przedziały percentylowe)
model <- '
  zadania ~ a * godziny
  punkty  ~ cp * godziny + b * zadania
  ab := a * b          # efekt pośredni
  c  := cp + a * b     # efekt całkowity
'
fit <- sem(model, data = dane, se = "bootstrap", bootstrap = 5000, iseed = 2026)
pe <- parameterEstimates(fit, boot.ci.type = "perc")
pe[pe$label != "", c("label", "est", "ci.lower", "ci.upper")]

# 3) współczynniki standaryzowane (β) i wyjaśniona wariancja
st <- standardizedSolution(fit)
round(setNames(st$est.std[st$label != ""], st$label[st$label != ""]), 2)
round(inspect(fit, "r2"), 2)
Wynik w konsoli R:
     a      b c_prim     ab      c
     1      1      1      1      2
  label est ci.lower ci.upper
1     a   1    0.544    1.525
2    cp   1   -0.089    1.817
3     b   1    0.416    1.696
7    ab   1    0.386    1.989
8     c   2    1.244    2.628
   a   cp    b   ab    c
0.77 0.43 0.56 0.43 0.87
zadania  punkty
   0.59    0.88
Ten sam model z kilkoma mediatorami lub zmiennymi ukrytymi zbudujesz w modelowaniu równań strukturalnych – zobacz PLS-SEM.
Pytania promotora i recenzenta
Czy 12 osób wystarczy?
Nie – to tylko ilustracja. Aby z mocą 0,80 wykryć efekt pośredni przy średnich ścieżkach a i b, bootstrap potrzebuje około 70–80 osób, a przy słabych ścieżkach – kilkuset (Fritz i MacKinnon, 2007).
Czym różni się mediacja od moderacji?
Mediacja odpowiada na pytanie „jak?” (przez co X wiąże się z Y). Moderacja pyta „kiedy?” lub „dla kogo?” – czy siła związku zależy od trzeciej zmiennej, np. płci.
Najczęstsze błędy
- Wnioskowanie o mediacji z serii testów Barona i Kenny’ego albo z samego testu Sobela.
- Rezygnacja z analizy, bo efekt całkowity c jest nieistotny.
- Język przyczynowy („wpływa”, „powoduje”) przy danych z jednego pomiaru.
- Brak liczby prób bootstrapowych i typu przedziału w opisie.
Bibliografia
- Baron, R. M., & Kenny, D. A. (1986). The moderator–mediator variable distinction in social psychological research: Conceptual, strategic, and statistical considerations. Journal of Personality and Social Psychology, 51(6), 1173–1182. https://doi.org/10.1037/0022-3514.51.6.1173
- Preacher, K. J., & Hayes, A. F. (2008). Asymptotic and resampling strategies for assessing and comparing indirect effects in multiple mediator models. Behavior Research Methods, 40(3), 879–891. https://doi.org/10.3758/BRM.40.3.879
- Hayes, A. F. (2022). Introduction to mediation, moderation, and conditional process analysis: A regression-based approach (3rd ed.). Guilford Press.
- Zhao, X., Lynch, J. G., Jr., & Chen, Q. (2010). Reconsidering Baron and Kenny: Myths and truths about mediation analysis. Journal of Consumer Research, 37(2), 197–206. https://doi.org/10.1086/651257
- Rucker, D. D., Preacher, K. J., Tormala, Z. L., & Petty, R. E. (2011). Mediation analysis in social psychology: Current practices and new recommendations. Social and Personality Psychology Compass, 5(6), 359–371. https://doi.org/10.1111/j.1751-9004.2011.00355.x
- Fritz, M. S., & MacKinnon, D. P. (2007). Required sample size to detect the mediated effect. Psychological Science, 18(3), 233–239. https://doi.org/10.1111/j.1467-9280.2007.01882.x
- Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówRegresja liniowa
- Słownik wzorówBootstrap
- PoradnikRegresja liniowa – przykład
- PoradnikModelowanie PLS-SEM
- PoradnikAlfa Cronbacha – przykład
- Przykładowy raportAnaliza mediacji
Przygotowujesz artykuł, doktorat lub grant?
Zaplanujemy i wykonamy analizy, przygotujemy raport z tabelami, wykresami i kodem R oraz pomożemy odpowiedzieć na uwagi recenzentów dotyczące statystyki.