

Bootstrap w statystyce – błąd standardowy i przedział ufności
Bootstrap to metoda szacowania błędu standardowego i przedziału ufności przez wielokrotne losowanie ze zwracaniem z Twojej własnej próby. Typowe pytanie z pracy dyplomowej lub artykułu: jak policzyć przedział ufności dla mediany, korelacji albo efektu pośredniego w mediacji, gdy nie ma na to prostego wzoru?
W prostych słowachNie możesz zbadać populacji jeszcze sto razy, więc udajesz, że Twoja próba jest populacją w miniaturze. Losujesz z niej nowe próby tej samej wielkości, pozwalając, by ta sama osoba trafiła kilka razy. W każdej liczysz statystykę. To, jak bardzo wyniki „skaczą” między losowaniami, mówi, jak niepewne jest Twoje oszacowanie.
Kiedy stosować bootstrap?
- chcesz przedziału ufności dla statystyki bez prostego wzoru: mediany, różnicy median, korelacji, efektu pośredniego w mediacji, ścieżek w modelowaniu PLS-SEM;
- wątpisz w założenia klasycznego wzoru (np. rozkład jest skośny, a próba niezbyt duża);
- obserwacje są niezależne i pochodzą z losowej, reprezentatywnej próby.
Dla zwykłej średniej z niewielką skośnością wystarczy klasyczny przedział ufności z rozkładem t i błąd standardowy s/√n. Bootstrap nie naprawia małej próby. Przy pięciu osobach jego przedziały wychodzą za wąskie, co zobaczysz w przykładzie.
Wzory bootstrapu
- \(\hat{\theta}\)
- statystyka policzona z oryginalnej próby (tu: średnia); to ona jest Twoim oszacowaniem
- \(\hat{\theta}^{*}_{b}\)
- ta sama statystyka w b-tej próbie bootstrapowej (replikacji)
- \(B\)
- liczba replikacji, w praktyce co najmniej 1000
- \(\bar{\theta}^{*}\)
- średnia ze wszystkich replikacji
- \(\hat{\theta}^{*}_{(2{,}5\%)},\ \hat{\theta}^{*}_{(97{,}5\%)}\)
- wartości, poniżej których leży 2,5% i 97,5% replikacji – granice przedziału percentylowego
Przykład krok po kroku
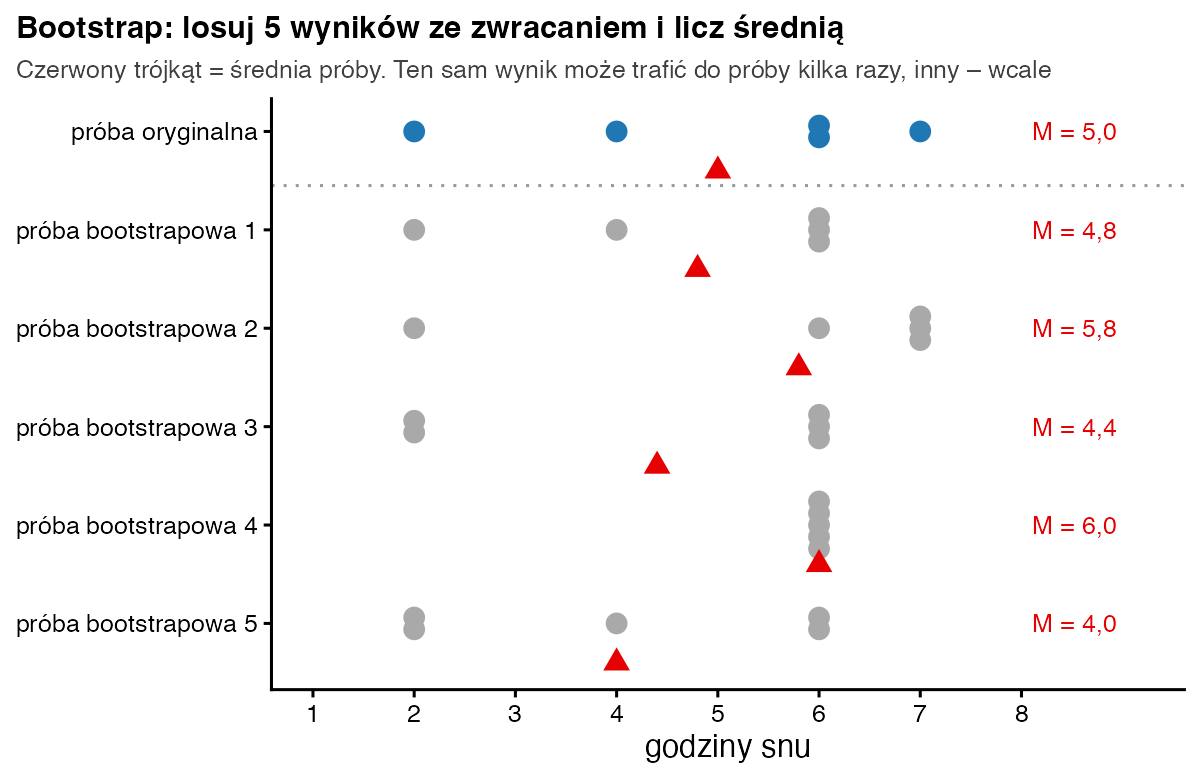
Pięcioro studentów spało przed kolokwium 6, 2, 7, 4 i 6 godzin (średnia 5 h). Najpierw zróbmy bootstrap „ręcznie” z pięcioma replikacjami.
| Replikacja | Wylosowane wyniki | Średnia M* | M* − 5 | (M* − 5)² |
|---|---|---|---|---|
| 1 | 6, 4, 6, 2, 6 | 4,8 | −0,2 | 0,04 |
| 2 | 7, 2, 7, 7, 6 | 5,8 | 0,8 | 0,64 |
| 3 | 6, 6, 2, 2, 6 | 4,4 | −0,6 | 0,36 |
| 4 | 6, 6, 6, 6, 6 | 6,0 | 1,0 | 1,00 |
| 5 | 6, 2, 2, 6, 4 | 4,0 | −1,0 | 1,00 |
| Σ = 25,0 | 0 | 3,04 |
- Losowanie. Z pięciu wyników losujesz pięć, za każdym razem „oddając” wylosowany wynik z powrotem. Liczysz średnią i powtarzasz B razy.
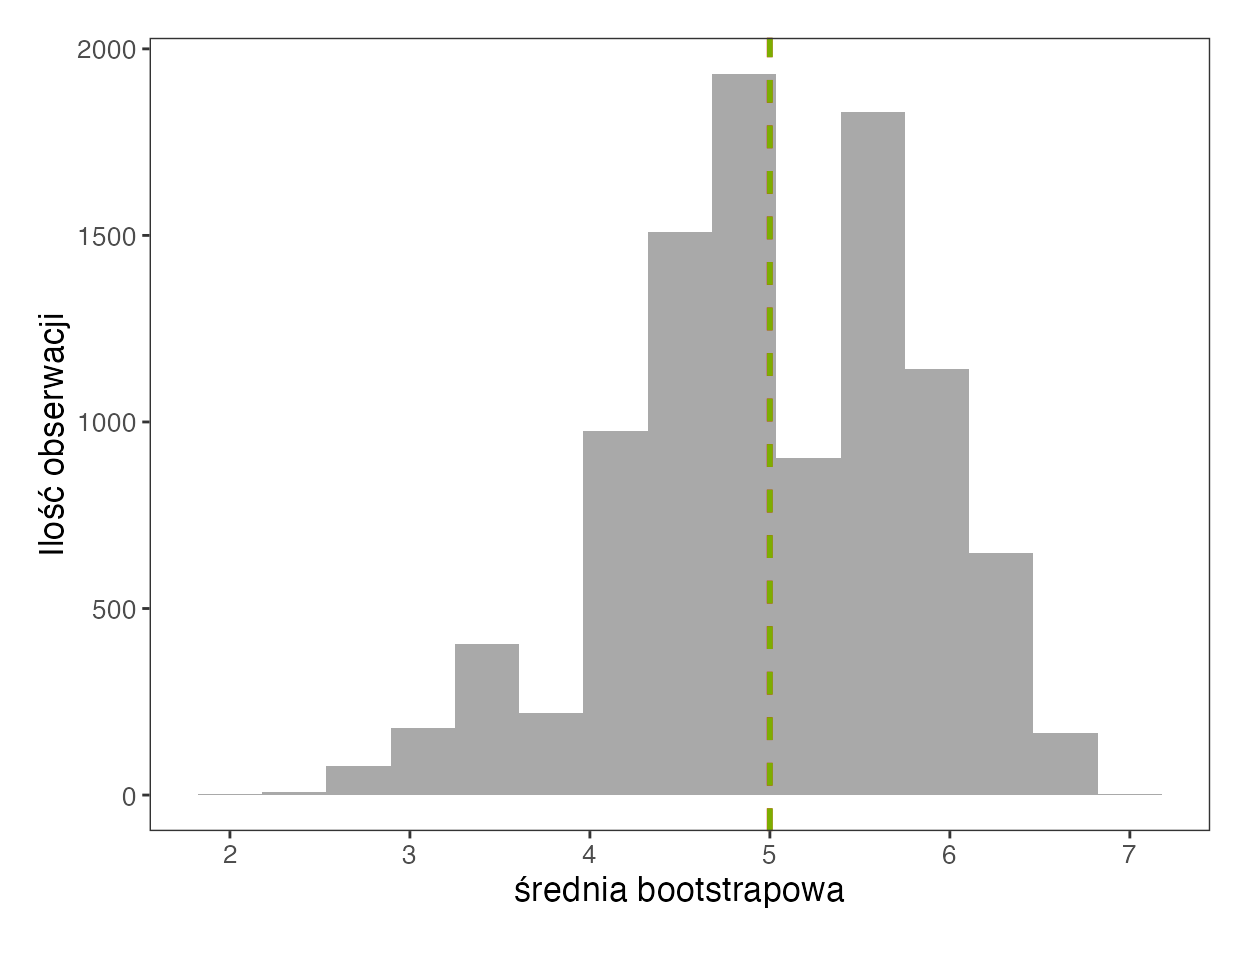
- Średnia replikacji. 25,0 / 5 = 5,0. Obciążenie: 5,0 − 5 = 0.
- Błąd standardowy. \(SE_{\text{boot}} = \sqrt{3{,}04 / (5 - 1)} = \sqrt{0{,}76} = 0{,}87\).
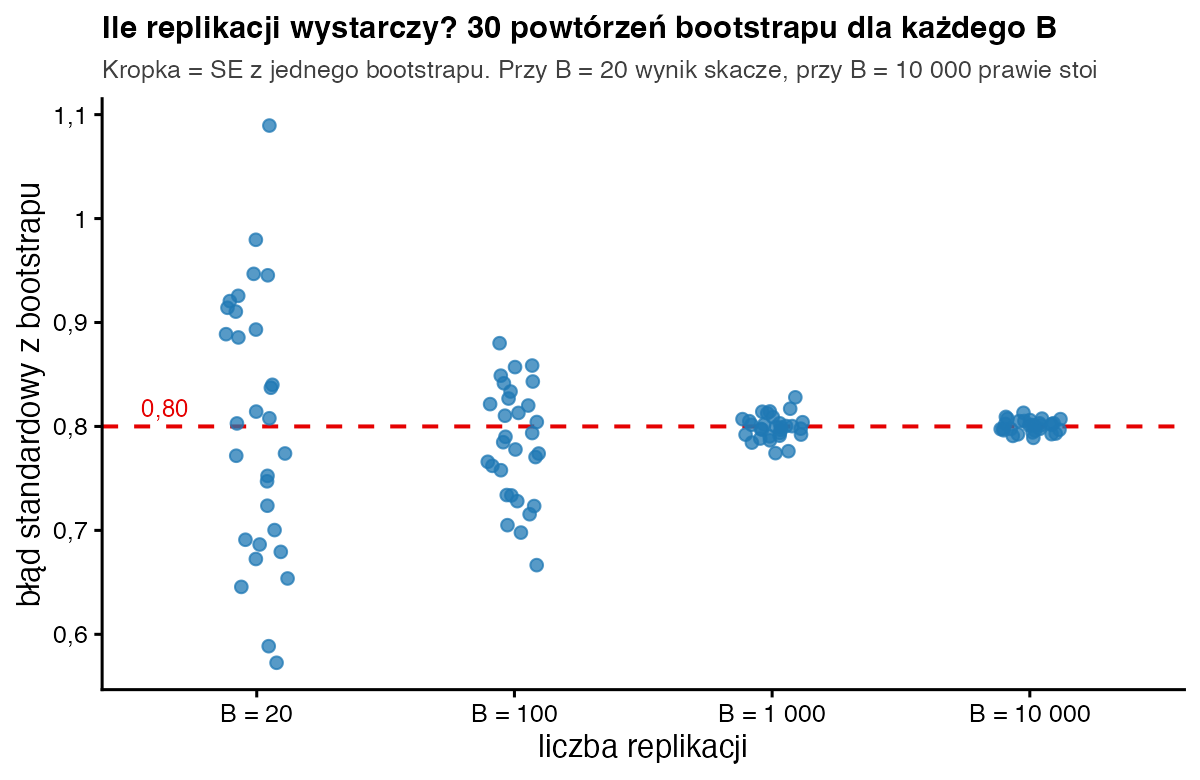
- Więcej replikacji. Pięć to za mało. Przy 10 000 replikacjach (R,
set.seed(2026)) wychodzi SEboot = 0,80, a obciążenie ≈ 0,00. - Przedział percentylowy. Odcinamy 2,5% najmniejszych i 2,5% największych średnich: 95% CI [3,2; 6,4]. Poprawiony przedział BCa: [2,8; 6,2].
- Porównanie. Klasyczny błąd standardowy to 2 / √5 = 0,89, a przedział z rozkładu t: [2,52; 7,48]. Bootstrap daje mniej, bo traktuje próbę jak całą populację i dzieli przez n zamiast n − 1: \(\sqrt{16/5}/\sqrt{5} = 0{,}80\). Przy tak małej próbie niedoszacowuje niepewności.
Jak zinterpretować i opisać wynik?
Twoim oszacowaniem pozostaje statystyka z oryginalnej próby, tu średnia 5 h. Bootstrap nie „poprawia” średniej, tylko mówi, jak bardzo jest niepewna. W opisie podaj liczbę replikacji, rodzaj przedziału (percentylowy, BCa) i to, że wynik zależy od ziarna losowania. Przy skośnych rozkładach i do mediacji częściej poleca się przedział BCa, który koryguje obciążenie i skośność (Efron i Tibshirani, 1993).
Zapis w stylu APA: Studenci spali przed kolokwium średnio M = 5,00 godziny; błąd standardowy oszacowany metodą bootstrap (B = 10 000) wyniósł SE = 0,80; 95% przedział percentylowy [3,20; 6,40].
Jak policzyć bootstrap w R?
library(boot)
sen <- c(6, 2, 7, 4, 6)

# 1) „ręcznie”: 5 prób bootstrapowych jak w tabeli (losowanie ze zwracaniem)
set.seed(1)
proby   <- replicate(5, sample(sen, replace = TRUE))  # kolumna = jedna próba
srednie <- colMeans(proby)
srednie
sd(srednie)                       # SE_boot z 5 replikacji (dzielenie przez B - 1)

# 2) pakiet boot: 10 000 replikacji
set.seed(2026)
b <- boot(sen, statistic = function(d, i) mean(d[i]), R = 10000)
c(srednia = b$t0, SE_boot = sd(b$t), obciazenie = mean(b$t) - b$t0)
quantile(b$t, c(0.025, 0.975))    # przedział percentylowy 95%
boot.ci(b, type = "bca")$bca[4:5] # przedział BCa 95%

# 3) dla porównania: klasyczny błąd standardowy s / sqrt(n)
sd(sen) / sqrt(5)
Wynik w konsoli R:
[1] 4.8 5.8 4.4 6.0 4.0
[1] 0.8717798
   srednia    SE_boot obciazenie
 5.0000000  0.8000338 -0.0013600
 2.5% 97.5%
  3.2   6.4
[1] 2.8 6.2
[1] 0.8944272
Ile replikacji bootstrapu wybrać?
Do samego błędu standardowego wystarczy zwykle kilkaset replikacji. Do przedziału ufności Efron i Tibshirani (1993) zalecali co najmniej 1000. Przy dzisiejszych komputerach nic nie stoi na przeszkodzie, by użyć 5000 lub 10 000 – rysunek 3 pokazuje, że wynik przestaje wtedy „skakać”. Zawsze ustaw ziarno losowania (set.seed()), żeby promotor albo recenzent mógł odtworzyć Twoje liczby.
Najczęstsze błędy
- Przekonanie, że bootstrap ratuje bardzo małą próbę – przy kilku osobach przedziały są za wąskie.
- Za mało replikacji i brak
set.seed(). - Losowanie bez zwracania – to tylko przetasowanie wyników, średnia się nie zmienia.
- Bootstrapowanie danych zależnych (pomiary powtarzane, uczniowie w klasach) jak niezależnych; potrzebny jest wtedy bootstrap blokowy lub klastrowy.
- Podawanie średniej z replikacji jako „lepszego” wyniku zamiast statystyki z oryginalnej próby.
Bibliografia
- Efron, B. (1979). Bootstrap methods: Another look at the jackknife. The Annals of Statistics, 7(1), 1–26. https://doi.org/10.1214/aos/1176344552
- Efron, B., & Tibshirani, R. J. (1993). An introduction to the bootstrap. Chapman & Hall.
- Davison, A. C., & Hinkley, D. V. (1997). Bootstrap methods and their application. Cambridge University Press. https://doi.org/10.1017/CBO9780511802843
- Canty, A., & Ripley, B. D. (2025). boot: Bootstrap functions (R package version 1.3-32) [Oprogramowanie]. https://doi.org/10.32614/CRAN.package.boot
- Field, A., Miles, J., & Field, Z. (2012). Discovering statistics using R. SAGE.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówPrzedział ufności dla średniej
- Słownik wzorówBłąd standardowy średniej
- Słownik wzorówCentralne twierdzenie graniczne
- PoradnikTest statystyczny – na czym polega
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
Przygotowujesz artykuł, doktorat lub grant?
Zaplanujemy i wykonamy analizy, przygotujemy raport z tabelami, wykresami i kodem R oraz pomożemy odpowiedzieć na uwagi recenzentów dotyczące statystyki.