

Modelowanie równań strukturalnych PLS-SEM – ocena modelu krok po kroku
PLS-SEM (ang. partial least squares structural equation modeling) szacuje związki między konstruktami mierzonymi kilkoma pytaniami. Każdy konstrukt zastępuje ważona suma jego pytań. Typowe pytanie z doktoratu: czy wsparcie promotora wiąże się z postępem pracy przez motywację i jak opisać taki model w artykule?
W skrócieOcena PLS-SEM ma dwa etapy. Najpierw model pomiarowy: ładunki, rzetelność, trafność zbieżna (AVE) i różnicowa (HTMT). Potem model strukturalny: współliniowość, ścieżki z bootstrapowym przedziałem ufności, R² i f². PLS-SEM to nie to samo co klasyczne SEM oparte na kowariancjach (CB-SEM). Pakiet lavaan liczy CB-SEM, a PLS-SEM w R policzysz w pakietach seminr lub cSEM.
PLS-SEM czy CB-SEM? Tabela decyzyjna
| Sytuacja | Wybór | Dlaczego |
|---|---|---|
| Chcesz potwierdzić teorię i ocenić dopasowanie całego modelu (χ², CFI, RMSEA) | CB-SEM (lavaan, AMOS, Mplus) | modeluje błąd pomiaru i daje wskaźniki dopasowania |
| Celem jest wyjaśnienie wariancji i przewidywanie wyników (R², PLSpredict) | PLS-SEM (seminr, cSEM, SmartPLS) | maksymalizuje wyjaśnioną wariancję konstruktów zależnych |
| Konstrukt jest „składany” ze wskaźników (formatywny, np. indeks dochodów) | PLS-SEM | naturalnie obsługuje konstrukty złożone |
| Skale refleksyjne, które sprawdzasz analizą czynnikową | CB-SEM albo PLSc | zwykły PLS zawyża ładunki i zaniża ścieżki |
| Mała próba lub rozkłady dalekie od normalnego | PLS-SEM liczy się stabilnie | ale nie zwiększa mocy – minimalną próbę i tak trzeba policzyć |
Przykład: dane i model
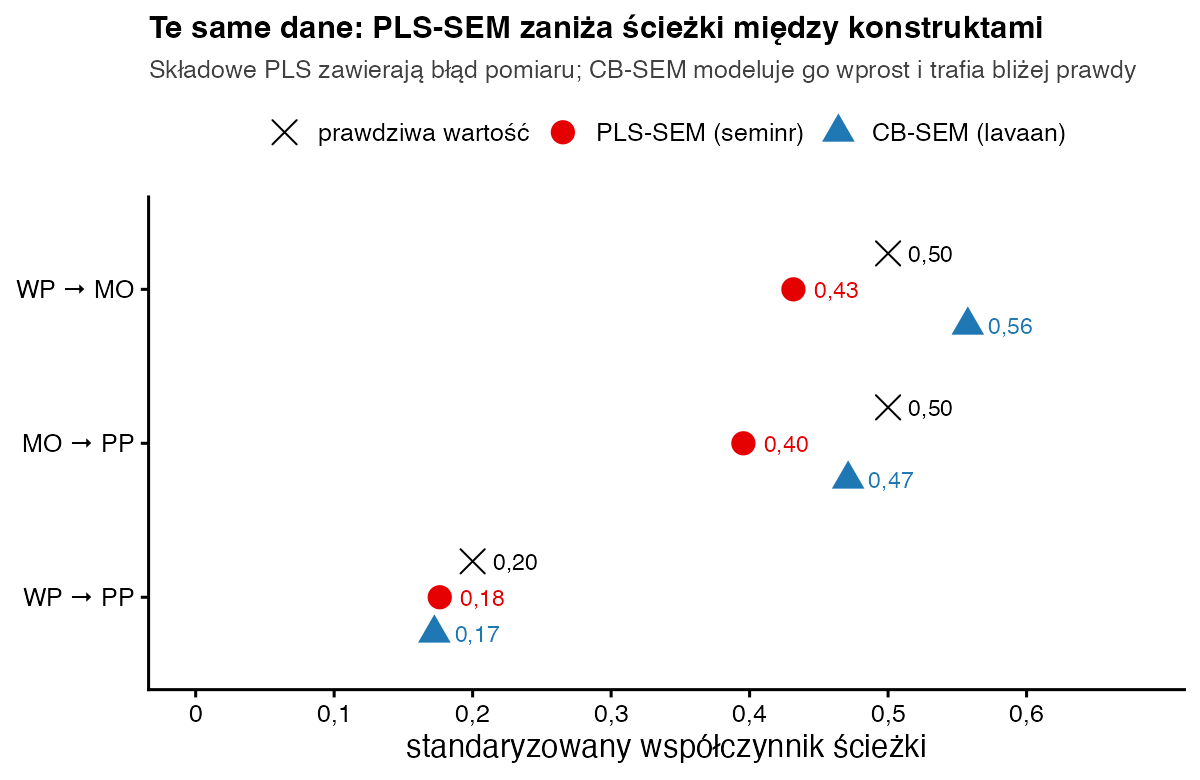
Dwustu doktorantów odpowiedziało na dziewięć pytań (skala 1–7): po trzy o wsparciu promotora (WP), motywacji (MO) i postępie pracy (PP). Model zakłada ścieżki WP → MO, MO → PP i WP → PP. Dane są symulowane, dlatego znamy prawdziwe ścieżki: 0,50; 0,50 i 0,20.
Krok 1. Model pomiarowy: rzetelność i trafność
Dawny opis tego etapu jako „trafności wewnętrznej” jest błędny: trafność wewnętrzna dotyczy planu badania i wniosków przyczynowych. W modelu pomiarowym sprawdzasz rzetelność wskaźników i skal, trafność zbieżną i trafność różnicową (Hair i in., 2022). Wzory znajdziesz w hasłach alfa Cronbacha, omega i rzetelność złożona oraz HTMT.
| Kryterium | Próg | Wynik w przykładzie |
|---|---|---|
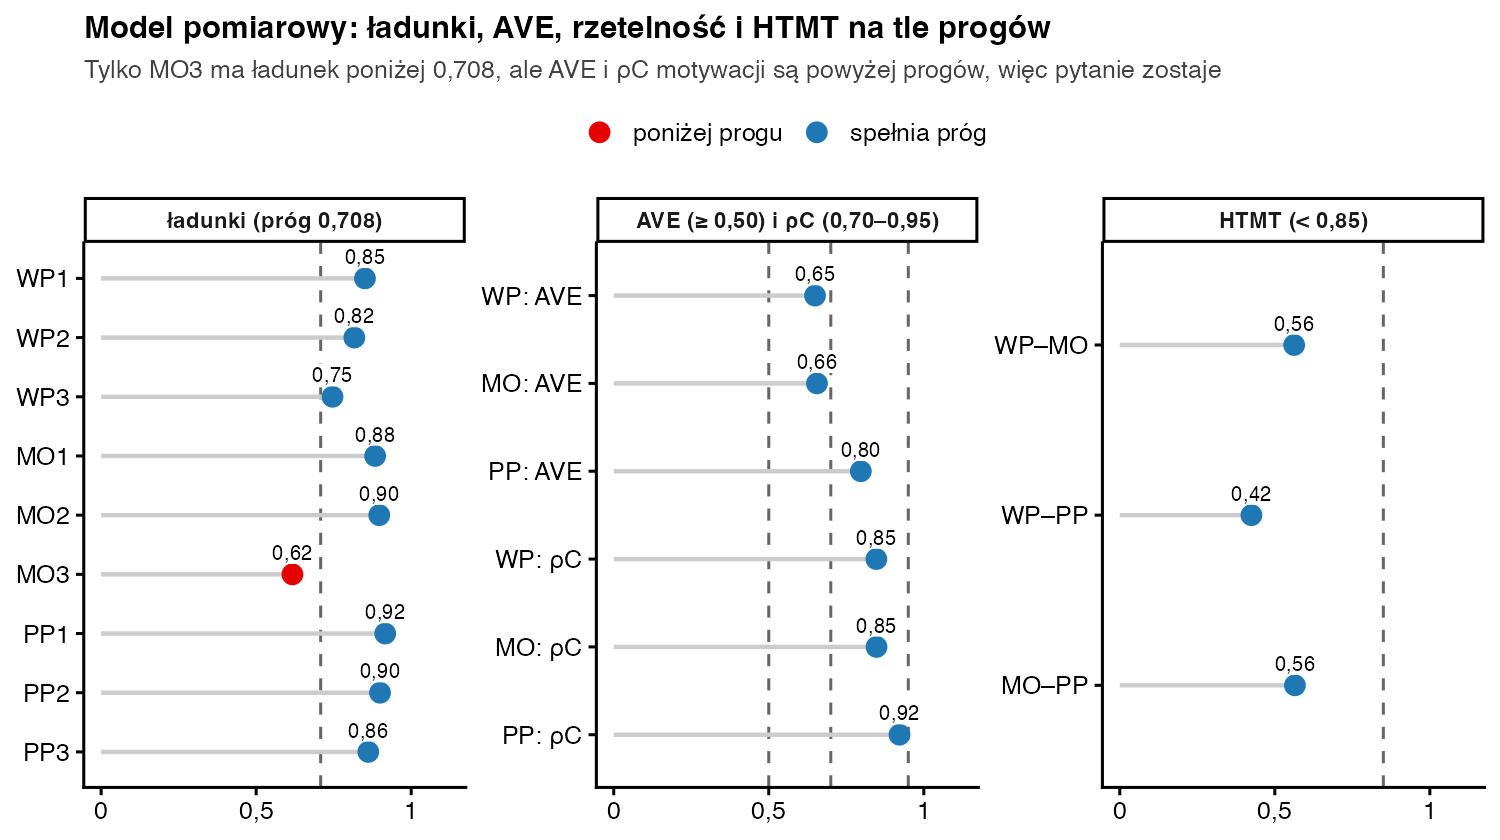
| Ładunki zewnętrzne (rzetelność wskaźników) | ≥ 0,708; od 0,40 do 0,70 usuń tylko, gdy poprawi to AVE lub ρC | 0,62–0,92 (MO3 = 0,62) |
| Rzetelność: α, ρA, ρC | 0,70–0,95 (powyżej 0,95 pytania są zbyt podobne) | ρA 0,75–0,88; ρC 0,85–0,92 |
| Trafność zbieżna: AVE | ≥ 0,50 | 0,65–0,80 |
| Trafność różnicowa: HTMT | < 0,85 (konstrukty bliskie: < 0,90) | 0,42–0,56 |
| Współliniowość predyktorów: VIF | < 3 (od 5 – problem) | 1,23 |
| Ścieżki | 95% CI z bootstrapu (10 000 prób) bez zera | wszystkie trzy |
| R² | 0,25 / 0,50 / 0,75 – słabe / umiarkowane / znaczne | MO 0,19; PP 0,25 |
| f² | 0,02 / 0,15 / 0,35 – mały / średni / duży | 0,03–0,23 |
Jedyny problem to pytanie MO3 o ładunku 0,62. AVE i ρC motywacji przekraczają jednak progi, więc pytanie zostaje. Usuwasz je tylko wtedy, gdy bez niego AVE lub rzetelność przekroczyłyby próg, którego wcześniej nie spełniały. Przy HTMT pożądane są wartości niskie (Henseler i in., 2015) – wysokie oznaczają, że dwie skale mierzą prawie to samo.
Krok 2. Model strukturalny
Ścieżki oceniasz bootstrapem: Hair i in. (2022) zalecają 10 000 prób. Wszystkie trzy przedziały nie obejmują zera, a VIF wynosi 1,23. Model wyjaśnia 19% wariancji motywacji i 25% postępu pracy. Efekt pośredni WP → MO → PP wynosi 0,17; 95% CI [0,11; 0,25]. Mediację w PLS-SEM testuje się tak samo jak w regresji – bootstrapem, nie testem Sobela (zobacz analiza mediacji – przykład).
PLS-SEM a CB-SEM na tych samych danych
Składowa PLS zawiera błąd pomiaru pytań. Dlatego przy skalach refleksyjnych PLS zawyża ładunki, a zaniża ścieżki między konstruktami. CB-SEM modeluje błąd wprost. Jeśli zostajesz przy PLS, a skale są refleksyjne, rozważ spójny PLS (PLSc; Dijkstra i Henseler, 2015).
Jak raportować PLS-SEM w artykule?
Zapis w stylu APA: Model oszacowano metodą PLS-SEM w pakiecie seminr (N = 200), a istotność ścieżek oceniono bootstrapem (10 000 prób). Ładunki wynosiły 0,62–0,92, AVE 0,65–0,80, ρC 0,85–0,92, a HTMT 0,42–0,56. Wsparcie promotora wiązało się z motywacją, β = 0,43; 95% CI [0,33; 0,54]. Motywacja wiązała się z postępem pracy, β = 0,40; 95% CI [0,28; 0,51]. Związek bezpośredni wsparcia z postępem był słabszy, β = 0,18; 95% CI [0,05; 0,30]. Efekt pośredni wyniósł 0,17; 95% CI [0,11; 0,25]. Model wyjaśniał 25% wariancji postępu pracy.
Dodaj tabelę ładunków i rzetelności, macierz HTMT, ocenę predykcyjną PLSpredict oraz uzasadnienie wyboru PLS-SEM (Hair i in., 2019).
Cała analiza w R
Kod korzysta z pakietu seminr, którego użycie krok po kroku opisuje podręcznik Hair i in. (2021), oraz z pakietu lavaan (Rosseel, 2012).
library(seminr); library(lavaan)
# Dane symulowane: 200 doktorantów, 9 pytań (1–7); prawdziwe ścieżki: 0,50; 0,50; 0,20
pop <- ' WP =~ 0.75*WP1 + 0.70*WP2 + 0.65*WP3      # wsparcie promotora
         MO =~ 0.75*MO1 + 0.70*MO2 + 0.40*MO3      # motywacja
         PP =~ 0.75*PP1 + 0.70*PP2 + 0.65*PP3      # postęp pracy
         MO ~ 0.50*WP
         PP ~ 0.50*MO + 0.20*WP '
x <- simulateData(pop, sample.nobs = 200, seed = 8, standardized = TRUE)
dane <- as.data.frame(lapply(x, function(v) pmin(pmax(round(4 + 1.4 * v), 1), 7)))

# 1) PLS-SEM w seminr: model pomiarowy i strukturalny
mm <- constructs(composite("WP", multi_items("WP", 1:3)), composite("MO", multi_items("MO", 1:3)),
                 composite("PP", multi_items("PP", 1:3)))
sm <- relationships(paths(from = "WP", to = c("MO", "PP")), paths(from = "MO", to = "PP"))
pls <- estimate_pls(dane, mm, sm)
s <- summary(pls)
round(rowSums(s$loadings), 2)                 # ładunki zewnętrzne
round(unclass(s$reliability), 2)              # alfa, rho_A, rho_C, AVE
round(s$validity$htmt, 2)                     # HTMT
round(s$paths["R^2", ], 2); round(s$fSquare, 2)

# 2) bootstrap 10 000 prób: ścieżki z 95% CI
b <- summary(bootstrap_model(pls, nboot = 10000, seed = 2026))
round(b$bootstrapped_paths[, c("Original Est.", "2.5% CI", "97.5% CI")], 2)

# 3) dla porównania CB-SEM (lavaan) na tych samych danych – lavaan NIE liczy PLS
cb <- sem(' WP =~ WP1 + WP2 + WP3; MO =~ MO1 + MO2 + MO3; PP =~ PP1 + PP2 + PP3
            MO ~ WP; PP ~ MO + WP ', data = dane)
st <- standardizedSolution(cb); st[st$op == "~", c("lhs", "rhs", "est.std", "pvalue")]
Wynik w konsoli R:
 WP1  WP2  WP3  MO1  MO2  MO3  PP1  PP2  PP3
0.85 0.82 0.75 0.88 0.90 0.62 0.92 0.90 0.86
   alpha rhoA rhoC  AVE
WP  0.73 0.75 0.85 0.65
MO  0.73 0.81 0.85 0.66
PP  0.87 0.88 0.92 0.80
      WP    MO PP
WP     .     .  .
MO 0.560     .  .
PP 0.420 0.560  .
  MO   PP
0.19 0.25
      WP    MO    PP
WP 0.000 0.230 0.030
MO 0.000 0.000 0.170
PP 0.000 0.000 0.000
           Original Est. 2.5% CI 97.5% CI
WP  ->  MO          0.43    0.33     0.54
WP  ->  PP          0.18    0.05     0.30
MO  ->  PP          0.40    0.28     0.51
   lhs rhs est.std pvalue
10  MO  WP   0.558  0.000
11  PP  MO   0.471  0.000
12  PP  WP   0.172  0.081
Najczęstsze pytania
Jaka minimalna próba do PLS-SEM?
Wygodna jest metoda odwrotnego pierwiastka (Kock i Hadaya, 2018): n ≥ (2,486 / βmin)², gdzie βmin to najmniejsza ścieżka, którą chcesz wykryć. Dla najmniejszej ścieżki w przykładzie (β = 0,176) wychodzi około 200 osób – tyle, ile mamy. Reguła „10 osób na strzałkę” jest zbyt łagodna.
Czy model PLS-SEM policzę w lavaan?
Nie. lavaan szacuje CB-SEM. Do PLS-SEM w R służą seminr i cSEM, poza R – SmartPLS.
Jak ocenić konstrukt formatywny?
Innymi kryteriami niż refleksyjny: współliniowością wskaźników (VIF < 3), istotnością i wielkością wag oraz analizą redundancji, czyli korelacją co najmniej 0,70 z globalną miarą konstruktu. Alfa i AVE nie mają tu sensu (Hair i in., 2022).
Czy mogę porównać dwie grupy, np. kobiety i mężczyzn?
Tak, analizą wielogrupową. Najpierw sprawdź jednak niezmienność (inwariancję) pomiaru w grupach procedurą MICOM (Henseler i in., 2016).
Najczęstsze błędy
- Nazywanie rzetelności i trafności zbieżnej „trafnością wewnętrzną”.
- Traktowanie wysokiego HTMT jako zalety – pożądane są wartości niskie.
- Ocenianie konstruktów formatywnych kryteriami refleksyjnymi (α, AVE).
- 500 prób bootstrapowych i brak przedziałów ufności dla ścieżek.
- Wybór PLS-SEM tylko dlatego, że „próba jest mała”.
Bibliografia
- Hair, J. F., Hult, G. T. M., Ringle, C. M., & Sarstedt, M. (2022). A primer on partial least squares structural equation modeling (PLS-SEM) (3rd ed.). Sage.
- Hair, J. F., Risher, J. J., Sarstedt, M., & Ringle, C. M. (2019). When to use and how to report the results of PLS-SEM. European Business Review, 31(1), 2–24. https://doi.org/10.1108/EBR-11-2018-0203
- Henseler, J., Ringle, C. M., & Sarstedt, M. (2015). A new criterion for assessing discriminant validity in variance-based structural equation modeling. Journal of the Academy of Marketing Science, 43(1), 115–135. https://doi.org/10.1007/s11747-014-0403-8
- Dijkstra, T. K., & Henseler, J. (2015). Consistent partial least squares path modeling. MIS Quarterly, 39(2), 297–316. https://doi.org/10.25300/MISQ/2015/39.2.02
- Henseler, J., Ringle, C. M., & Sarstedt, M. (2016). Testing measurement invariance of composites using partial least squares. International Marketing Review, 33(3), 405–431. https://doi.org/10.1108/IMR-09-2014-0304
- Kock, N., & Hadaya, P. (2018). Minimum sample size estimation in PLS-SEM: The inverse square root and gamma-exponential methods. Information Systems Journal, 28(1), 227–261. https://doi.org/10.1111/isj.12131
- Hair, J. F., Jr., Hult, G. T. M., Ringle, C. M., Sarstedt, M., Danks, N. P., & Ray, S. (2021). Partial least squares structural equation modeling (PLS-SEM) using R: A workbook. Springer. https://doi.org/10.1007/978-3-030-80519-7
- Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówHTMT – trafność różnicowa
- Słownik wzorówOmega McDonalda
- Słownik wzorówAlfa Cronbacha
- PoradnikAnaliza mediacji – przykład
- PoradnikAlfa Cronbacha – przykład
- Przykładowy raportPrzykładowy model SZTOS: PLS-SEM
Przygotowujesz artykuł, doktorat lub grant?
Zaplanujemy i wykonamy analizy, przygotujemy raport z tabelami, wykresami i kodem R oraz pomożemy odpowiedzieć na uwagi recenzentów dotyczące statystyki.