

Testy parametryczne – założenia, przykłady i wybór testu
Test parametryczny zakłada, że wyniki pochodzą z rozkładu o znanym kształcie – najczęściej normalnego – opisanego kilkoma parametrami, np. średnią i odchyleniem standardowym. Typowe pytanie z pracy dyplomowej: czy mogę porównać grupy testem t albo ANOVA, czy muszę sięgnąć po test nieparametryczny?
W prostych słowachTesty parametryczne najczęściej porównują średnie i korzystają z dokładnych odległości między wynikami. Dzięki temu łatwiej wykrywają prawdziwe różnice, ale stawiają warunki: niezależne obserwacje, wyniki liczbowe, rozkład zbliżony do normalnego w każdej grupie i podobny rozrzut. Gdy warunki są spełnione, to zwykle najlepszy wybór.
Czym jest test parametryczny?
To test, który zakłada konkretną rodzinę rozkładów (zwykle normalny) i sprawdza hipotezy o jej parametrach: średnich, różnicach średnich, współczynnikach korelacji lub regresji. Należą tu m.in. test t Studenta (dla jednej próby, prób niezależnych i zależnych), analiza wariancji, korelacja Pearsona i regresja liniowa. Ogólną logikę każdego testu – hipotezy, poziom istotności, wartość p – opisujemy we wpisie test statystyczny.
Założenia testów parametrycznych
- Niezależność obserwacji – każda osoba liczy się raz, a wyniki osób na siebie nie wpływają. To założenie najważniejsze i żaden test go nie „naprawi”.
- Skala ilościowa – punkty, czas, wynik skali.
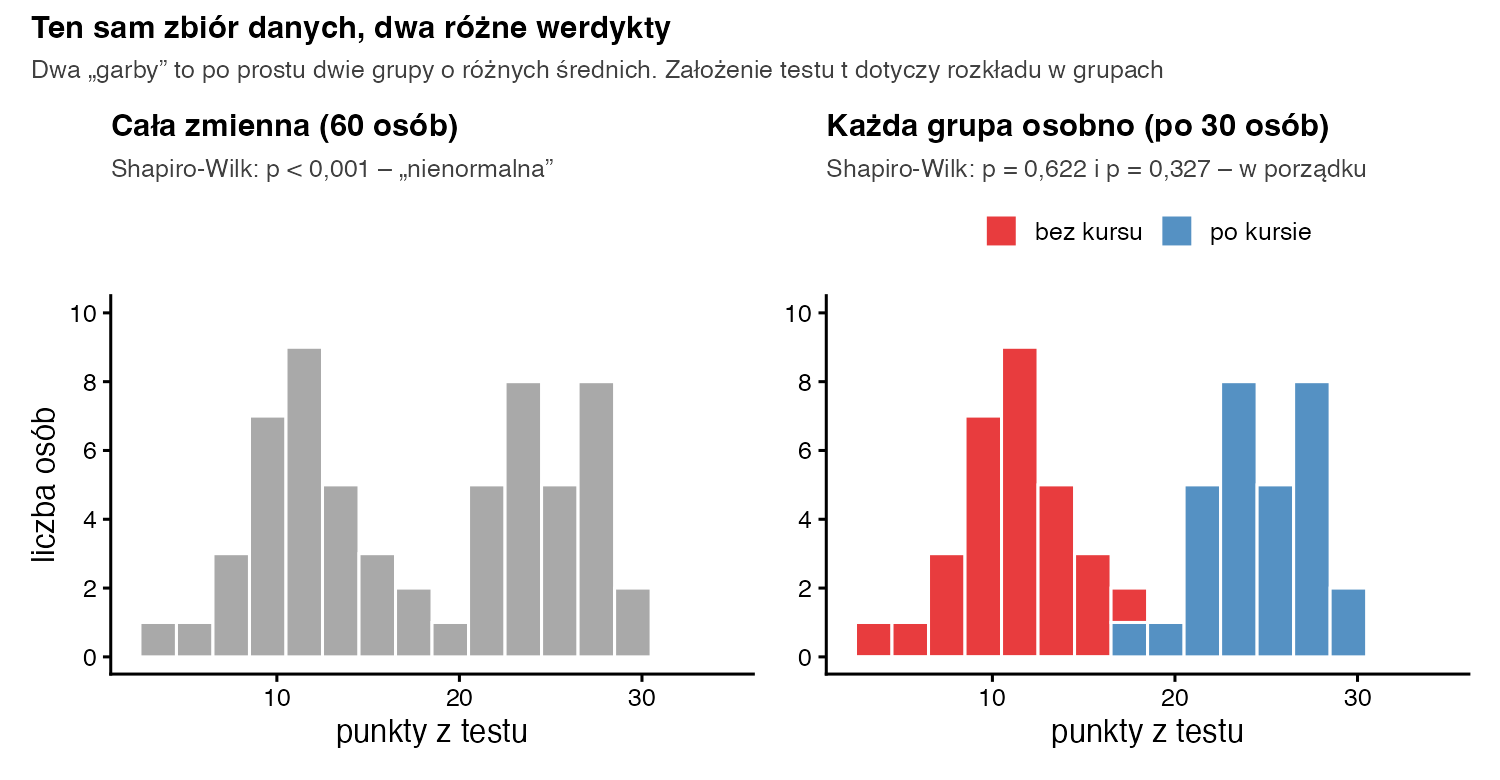
- Normalność w grupach, a nie „całej zmiennej” – sprawdzasz rozkład w każdej grupie osobno (test t dla prób niezależnych), rozkład różnic (test t dla par) albo reszt modelu (ANOVA, regresja), np. testem Shapiro-Wilka i na wykresie kwantyl-kwantyl.
- Podobne wariancje w grupach – sprawdzisz je testem Levene’a. Gdy się różnią, wybierz test t Welcha albo ANOVA Welcha.
- Brak silnych obserwacji odstających, a w korelacji i regresji – związek w przybliżeniu liniowy.
Przy kilkudziesięciu osobach w grupie test t i ANOVA dobrze znoszą umiarkowane odchylenia od normalności, bo rozkład średnich i tak zbliża się do normalnego (centralne twierdzenie graniczne; Lumley i in., 2002).
Który test parametryczny wybrać? Tabela decyzyjna
Zacznij od pytania badawczego i układu badania. Ostatnia kolumna podpowiada, czego użyć, gdy założenia zawodzą.
| Pytanie badawcze | Test parametryczny | Przykład krok po kroku | Gdy założenia zawodzą |
|---|---|---|---|
| Czy średnia różni się od normy lub wartości z literatury? | test t dla jednej próby | – | test Wilcoxona dla jednej próby |
| Czy dwie grupy różnych osób się różnią? | test t Studenta lub Welcha | test t – przykład | test U Manna-Whitneya |
| Czy wynik zmienił się u tych samych osób (przed i po)? | test t dla prób zależnych | – | test Wilcoxona |
| Czy różnią się trzy grupy lub więcej? | jednoczynnikowa ANOVA | ANOVA – przykład | test Kruskala-Wallisa |
| Czy zmienia się wynik w trzech pomiarach tych samych osób? | ANOVA z powtarzanymi pomiarami | – | test Friedmana |
| Czy dwie zmienne ilościowe są powiązane? | korelacja Pearsona | Pearson – przykład | korelacja Spearmana |
| Co przewiduje wynik? | regresja liniowa | regresja – przykład | przekształcenie zmiennej lub bootstrap |
Test t czy test U? Mini-porównanie na tych samych danych
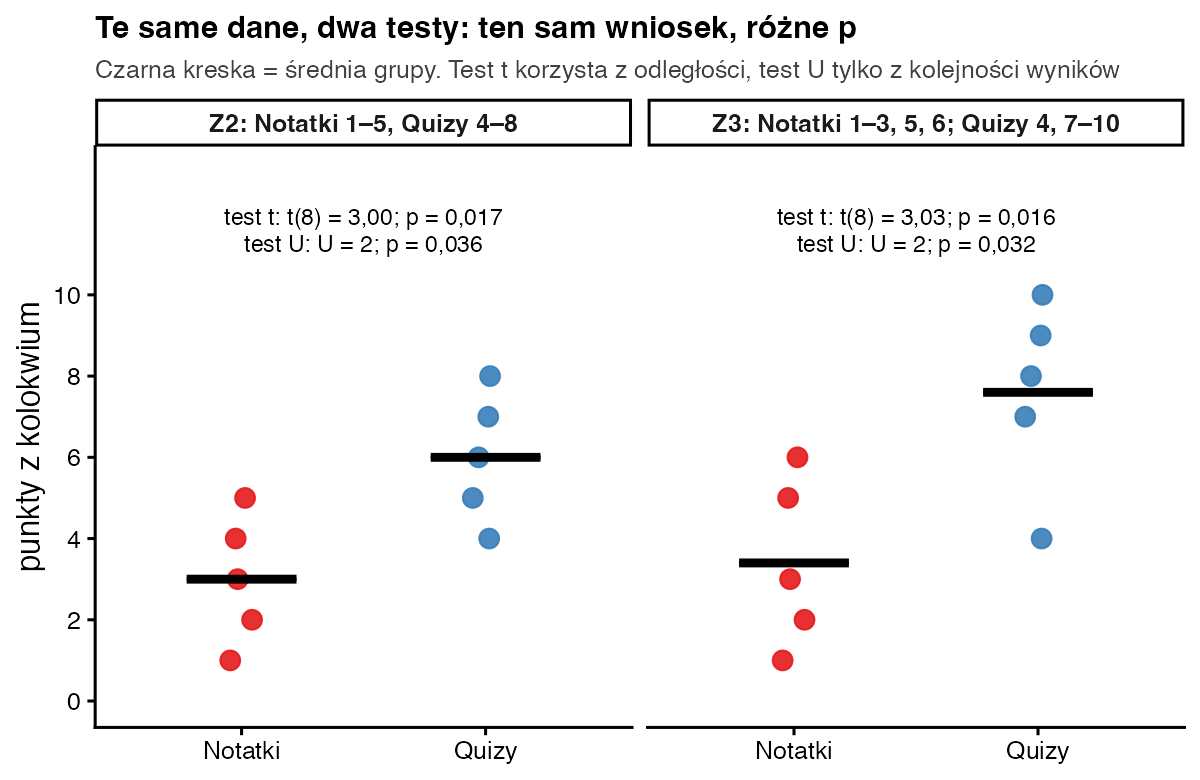
Weźmy dwa małe zbiory z naszego słownika wzorów: punkty z kolokwium studentów uczących się z notatek i z quizów, po pięć osób w grupie. Na obu wykonujemy test parametryczny (t) i nieparametryczny (U).
| Zbiór | Notatki | Quizy | Test t | Test U |
|---|---|---|---|---|
| Dane 1 (jak w haśle o teście t) | 1, 2, 3, 4, 5 | 4, 5, 6, 7, 8 | t(8) = 3,00; p = 0,017 | U = 2; p = 0,036* |
| Dane 2 (jak w haśle o teście U) | 1, 2, 3, 5, 6 | 4, 7, 8, 9, 10 | t(8) = 3,03; p = 0,016 | U = 2; p = 0,032 |
| * W danych 1 są remisy (4 i 5 w obu grupach), więc p testu U pochodzi z przybliżenia rozkładem normalnym. | ||||
Oba testy prowadzą do tego samego wniosku, ale test t daje mniejsze p. Korzysta z dokładnych odległości między wynikami, a test U – tylko z ich kolejności. Gdy założenia są spełnione, test t ma więc zwykle nieco większą moc. Przy silnie skośnych danych z wynikami odstającymi bywa odwrotnie – przykład znajdziesz we wpisie o testach nieparametrycznych. Test wybieraj przed spojrzeniem na wyniki, a nie według tego, który da „lepsze” p.
Błąd I i II rodzaju – poprawne definicje
Każdy test może się pomylić na dwa sposoby. Błąd I rodzaju to odrzucenie hipotezy zerowej, która jest prawdziwa – „fałszywy alarm”. Jego ryzyko ustalasz sam jako poziom istotności α, np. 0,05. Błąd II rodzaju to nieodrzucenie hipotezy zerowej, która jest fałszywa – przeoczenie istniejącego efektu. Jego ryzyko β zależy od liczebności próby, wielkości efektu i α, a 1 − β to moc testu (Neyman i Pearson, 1933). Szczegóły i przykłady: błąd I rodzaju oraz błąd II rodzaju i moc testu.
Jak sprawdzić założenia i wykonać test parametryczny w R?
notatki <- c(1, 2, 3, 4, 5)          # punkty z kolokwium (te same dane co w haśle o teście t)
quizy   <- c(4, 5, 6, 7, 8)
punkty  <- c(notatki, quizy)
grupa   <- factor(rep(c("Notatki", "Quizy"), each = 5))

# 1) normalność: w KAŻDEJ grupie osobno albo na resztach (wynik − średnia grupy)
tapply(punkty, grupa, function(x) shapiro.test(x)$p.value)
shapiro.test(residuals(lm(punkty ~ grupa)))$p.value

# 2) równość wariancji: test Levene'a
car::leveneTest(punkty ~ grupa, center = mean)

# 3) test parametryczny: t Studenta (var.equal = TRUE) i t Welcha (domyślny w R)
t.test(quizy, notatki, var.equal = TRUE)
t.test(quizy, notatki)$p.value

# 4) dla porównania: test U Manna-Whitneya na tych samych danych (R nazywa U literą W)
u <- suppressWarnings(wilcox.test(notatki, quizy))   # remisy, więc p z przybliżenia
c(U = unname(u$statistic), p = u$p.value)
Wynik w konsoli R:
  Notatki     Quizy
0.9671739 0.9671739
[1] 0.3411315
Levene's Test for Homogeneity of Variance (center = mean)
      Df F value Pr(>F)
group  1       0      1
       8

	Two Sample t-test

data:  quizy and notatki
t = 3, df = 8, p-value = 0.01707
alternative hypothesis: true difference in means is not equal to 0
95 percent confidence interval:
 0.6939959 5.3060041
sample estimates:
mean of x mean of y
        6         3

[1] 0.01707168
         U          p
2.00000000 0.03557883
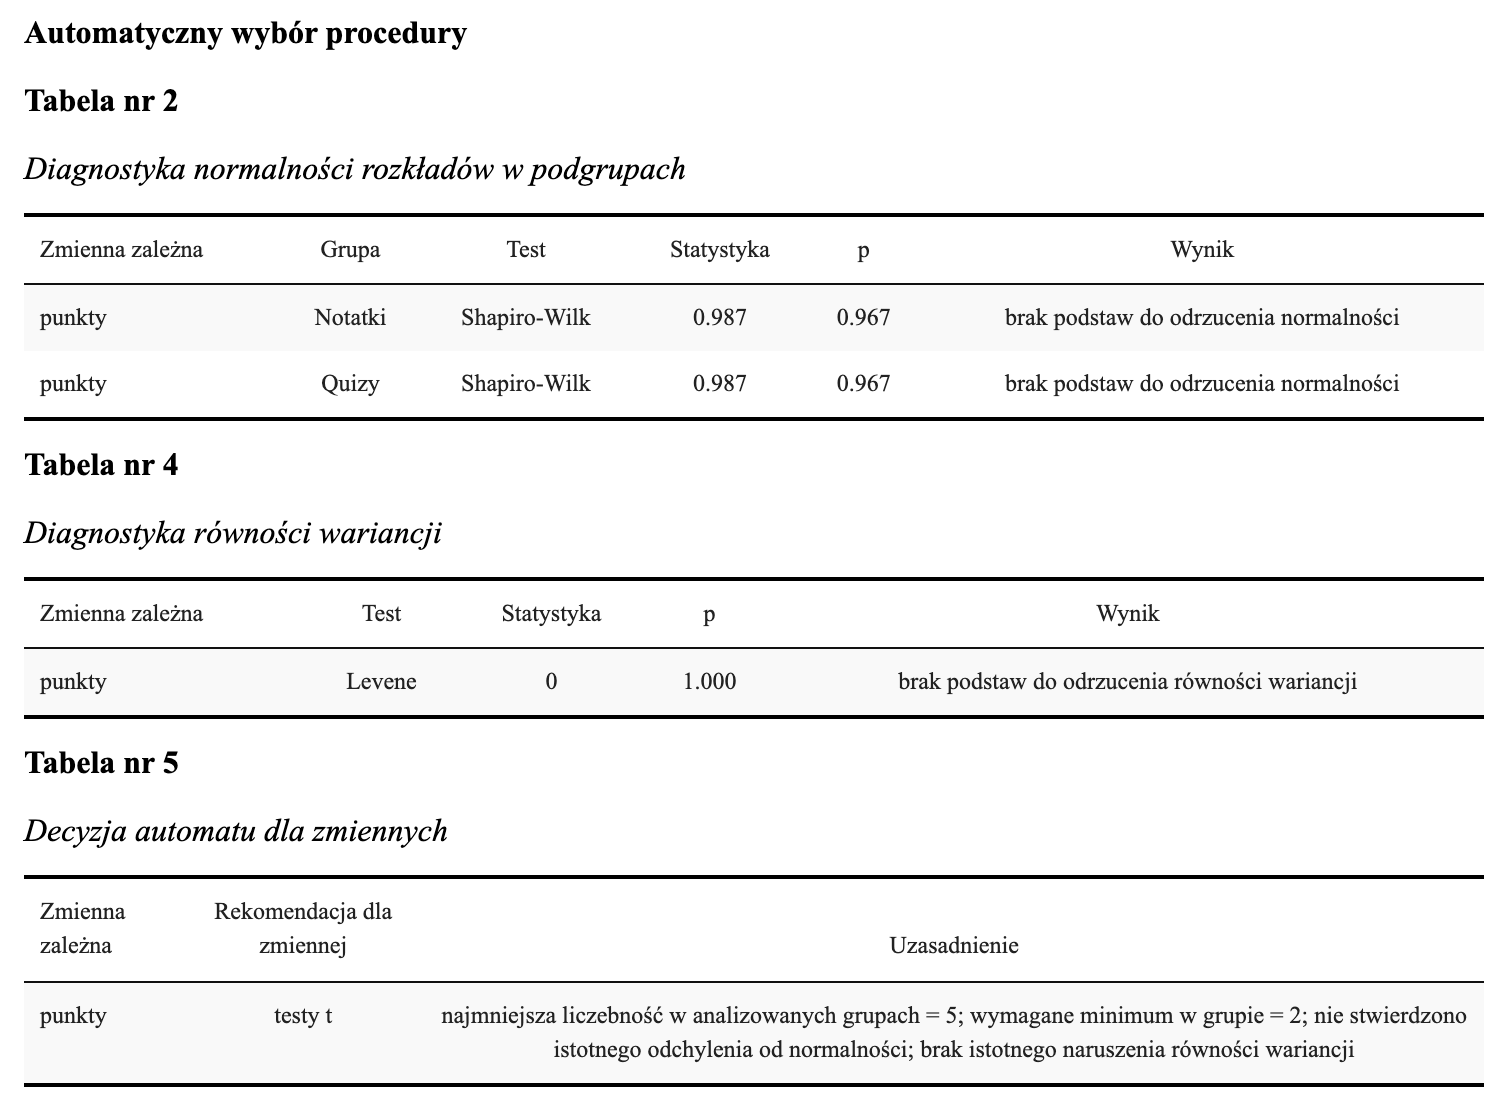
Zapis w stylu APA: Rozkłady punktów w obu grupach nie odbiegały istotnie od normalnego (test Shapiro-Wilka: p = 0,967 w każdej grupie), a wariancje nie różniły się istotnie (test Levene’a: F(1, 8) = 0,00; p = 1,000). Studenci uczący się z quizów (M = 6,00; SD = 1,58) uzyskali istotnie więcej punktów niż studenci uczący się z notatek (M = 3,00; SD = 1,58), t(8) = 3,00; p = 0,017; d = 1,90.
Test parametryczny czy nieparametryczny – co wybrać?
Jeśli zmienna jest ilościowa, a rozkłady w grupach są zbliżone do normalnego albo grupy są duże, wybierz test parametryczny. Ma większą moc i od razu daje różnicę średnich z przedziałem ufności. Nierówne wariancje nie są powodem, by z niego rezygnować – wystarczy wersja Welcha (Delacre i in., 2017). Test nieparametryczny wybierz przy danych porządkowych (np. pojedyncze pytanie 1–5) albo przy małych, wyraźnie skośnych grupach z wynikami odstającymi.
Najczęstsze błędy
- Sprawdzanie normalności na całej zmiennej zamiast w każdej grupie albo na resztach.
- Zamiana definicji: błąd I rodzaju to odrzucenie prawdziwej H0, a błąd II rodzaju – nieodrzucenie fałszywej.
- Przechodzenie na test nieparametryczny przy nierównych wariancjach, gdy wystarczy test Welcha.
- Wybór testu po sprawdzeniu, który daje mniejsze p.
- Pisanie „przyjęto H0”, gdy p > 0,05. Poprawnie: „brak podstaw do odrzucenia H0”.
Bibliografia
- Student. (1908). The probable error of a mean. Biometrika, 6(1), 1–25. https://doi.org/10.1093/biomet/6.1.1
- Neyman, J., & Pearson, E. S. (1933). On the problem of the most efficient tests of statistical hypotheses. Philosophical Transactions of the Royal Society of London. Series A, 231, 289–337. https://doi.org/10.1098/rsta.1933.0009
- Welch, B. L. (1947). The generalization of “Student’s” problem when several different population variances are involved. Biometrika, 34(1–2), 28–35. https://doi.org/10.1093/biomet/34.1-2.28
- Shapiro, S. S., & Wilk, M. B. (1965). An analysis of variance test for normality (complete samples). Biometrika, 52(3–4), 591–611. https://doi.org/10.1093/biomet/52.3-4.591
- Lumley, T., Diehr, P., Emerson, S., & Chen, L. (2002). The importance of the normality assumption in large public health data sets. Annual Review of Public Health, 23, 151–169. https://doi.org/10.1146/annurev.publhealth.23.100901.140546
- Delacre, M., Lakens, D., & Leys, C. (2017). Why psychologists should by default use Welch’s t-test instead of Student’s t-test. International Review of Social Psychology, 30(1), 92–101. https://doi.org/10.5334/irsp.82
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówTest t Studenta dla prób niezależnych
- Słownik wzorówJednoczynnikowa ANOVA
- Słownik wzorówTest Shapiro-Wilka
- PoradnikTesty nieparametryczne
- PoradnikTest t Studenta – przykład
- Przykładowy raportTest t Studenta
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.