

Centralne twierdzenie graniczne – wzór i interpretacja
Centralne twierdzenie graniczne (CTG) mówi, że średnia z wielu niezależnych pomiarów ma rozkład zbliżony do normalnego – nawet wtedy, gdy same pomiary normalne nie są. Typowe pytanie z pracy dyplomowej: czy mogę użyć testu t, skoro rozkład moich wyników jest skośny?
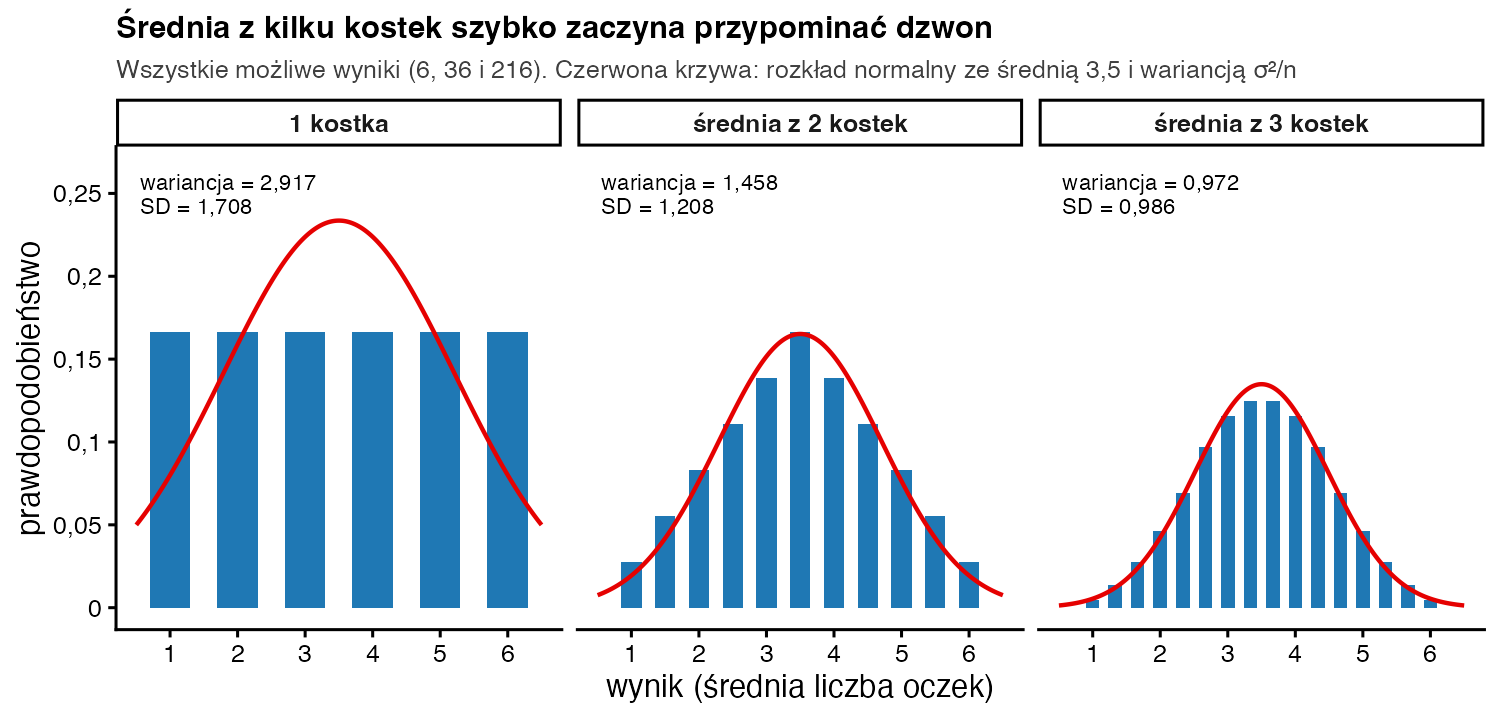
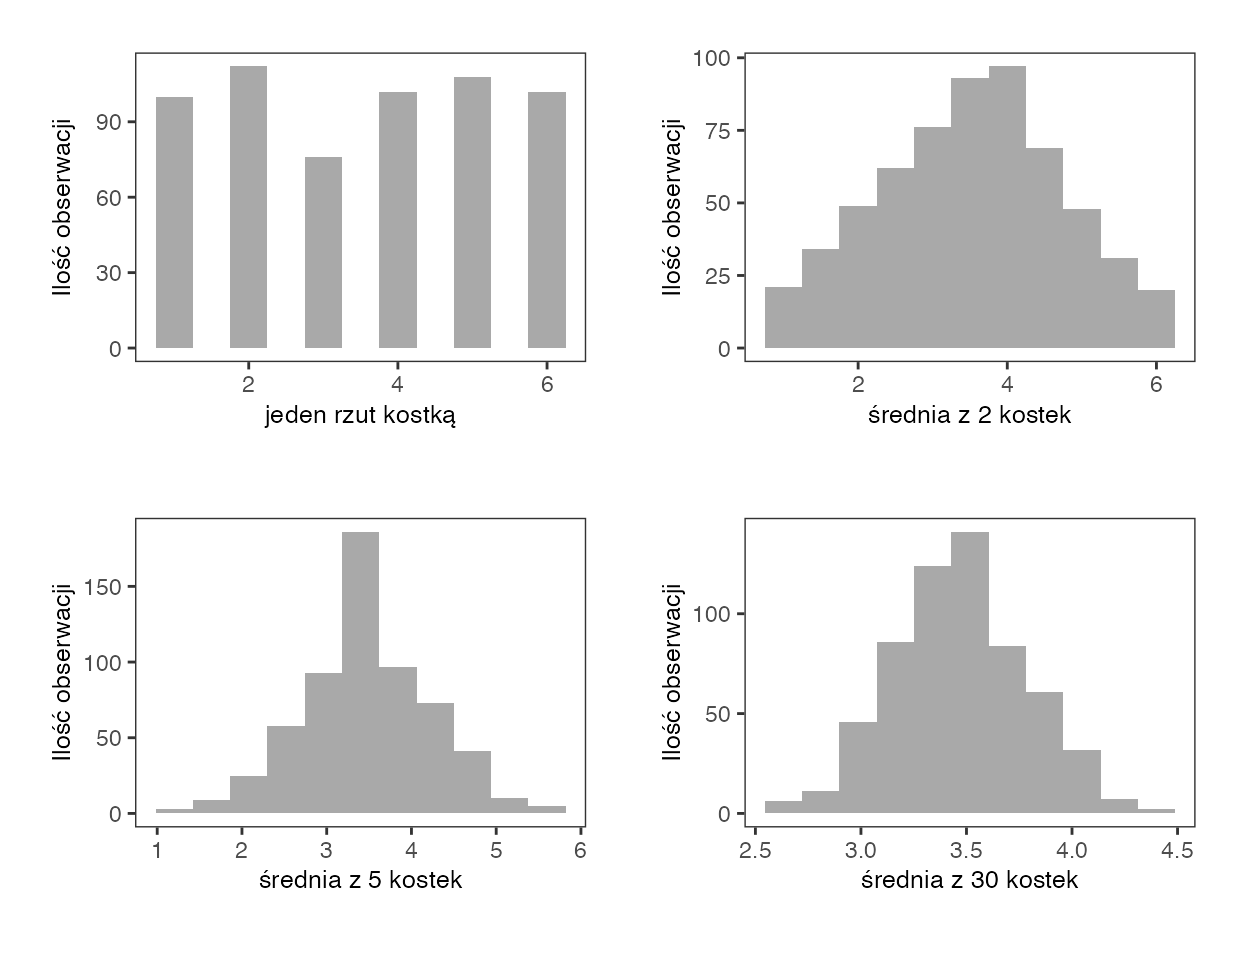
W prostych słowachPojedynczy rzut kostką daje każdy wynik od 1 do 6 z tą samą szansą. Średnia z dwóch rzutów najczęściej wypada jednak w środku, bo skrajne wyniki się znoszą. Im więcej rzutów uśredniasz, tym bardziej rozkład średnich przypomina dzwon i tym jest węższy.
Kiedy centralne twierdzenie graniczne ma znaczenie?
- uzasadniasz użycie testu t, ANOVA albo przedziału ufności dla średniej, gdy dane nie są idealnie normalne, ale grupy są duże;
- liczysz błąd standardowy średniej – wzór SE = σ/√n mówi, jak szeroki jest rozkład średnich, a CTG – jaki ma kształt;
- planujesz liczebność próby i chcesz wiedzieć, jak szybko maleje niepewność średniej.
CTG ma swoje warunki: obserwacje muszą być niezależne, pochodzić z tego samego rozkładu i mieć skończoną wariancję. Twierdzenie dotyczy średnich – nie sprawia, że same dane stają się normalne. Przy silnej skośności potrzeba wielu obserwacji, a przy małych próbach bezpieczniejszy bywa bootstrap albo test nieparametryczny.
Wzór – centralne twierdzenie graniczne
- \(\bar{X}\)
- średnia z próby n niezależnych pomiarów
- \(\mu,\ \sigma\)
- średnia i odchylenie standardowe pojedynczych pomiarów w populacji
- \(n\)
- liczba uśrednianych pomiarów (liczebność próby)
- \(\sigma/\sqrt{n}\)
- błąd standardowy – odchylenie standardowe rozkładu średnich; czterokrotnie większa próba daje dwa razy mniejszy błąd
- \(Z\)
- średnia standaryzowana: o ile błędów standardowych średnia odbiega od μ
- \(N(0,\ 1)\)
- standardowy rozkład normalny; strzałka oznacza „coraz bliżej, gdy n rośnie”
Uwaga: do μ zbiega sama średnia (to prawo wielkich liczb). CTG mówi coś więcej – jaki kształt ma rozrzut średnich wokół μ. To samo zjawisko tłumaczy, dlaczego zmienne będące sumą wielu drobnych wpływów, np. wynik testu złożonego z wielu pytań, mają często rozkład zbliżony do normalnego.
Przykład krok po kroku
Rzucamy dwiema kostkami i liczymy średnią liczbę oczek. Wszystkich par wyników jest 6 · 6 = 36 i każda jest tak samo prawdopodobna.
| Średnia x̄ | Liczba par | Liczba · x̄ | Liczba · (x̄ − 3,5)² |
|---|---|---|---|
| 1 | 1 | 1 | 6,25 |
| 1,5 | 2 | 3 | 8 |
| 2 | 3 | 6 | 6,75 |
| 2,5 | 4 | 10 | 4 |
| 3 | 5 | 15 | 1,25 |
| 3,5 | 6 | 21 | 0 |
| 4 | 5 | 20 | 1,25 |
| 4,5 | 4 | 18 | 4 |
| 5 | 3 | 15 | 6,75 |
| 5,5 | 2 | 11 | 8 |
| 6 | 1 | 6 | 6,25 |
| Σ | 36 | 126 | 52,5 |
- Jedna kostka. μ = 21 / 6 = 3,5. Wariancja: σ² = (6,25 + 2,25 + 0,25 + 0,25 + 2,25 + 6,25) / 6 = 17,5 / 6 = 2,917, więc σ = 1,708. Rozkład jest płaski.
- Dwie kostki. Średnia 3,5 wychodzi z 6 par, a średnie 1 i 6 – tylko z jednej. Rozkład ma już kształt trójkąta ze szczytem w środku.
- Średnia średnich. 126 / 36 = 3,5 – tyle samo co μ.
- Wariancja średnich. 52,5 / 36 = 1,458 = 2,917 / 2, czyli dokładnie σ²/n. Odchylenie standardowe: √1,458 = 1,208 = 1,708 / √2.
- Większa próba. Dla 30 rzutów SE = 1,708 / √30 = 0,312. Około 95% średnich wypadnie więc między 3,5 − 1,96 · 0,312 = 2,89 a 3,5 + 1,96 · 0,312 = 4,11.
Jak zinterpretować i opisać wynik?
CTG nie jest testem, tylko uzasadnieniem. Pozwala korzystać z rozkładu normalnego (a dokładniej z rozkładu t) przy wnioskowaniu o średnich, nawet gdy wyniki pojedynczych osób są lekko skośne. W pracy wystarczy jedno zdanie w części o analizie danych, ale musi ono dotyczyć Twoich danych: podaj liczebności grup i opisz kształt rozkładów. Zawsze jednak pokaż histogram i podaj skośność – recenzent powinien widzieć, z jakimi danymi pracujesz.
Zapis w stylu APA: Rozkład czasu dojazdu był prawostronnie skośny, jednak ze względu na liczebność grup (po 40 osób) przyjęto, zgodnie z centralnym twierdzeniem granicznym, że rozkład średnich jest zbliżony do normalnego, i zastosowano test t Welcha.
Jak sprawdzić centralne twierdzenie graniczne w R?
oczka <- 1:6                                   # jedna kostka
mu <- mean(oczka); s2 <- mean((oczka - mu)^2)  # wariancja populacji
round(c(mu = mu, sigma2 = s2, sigma = sqrt(s2)), 3)

# 1) „ręcznie”: wszystkie 36 par dwóch kostek
pary <- expand.grid(k1 = oczka, k2 = oczka)
srednie <- (pary$k1 + pary$k2) / 2
table(srednie)
round(c(srednia = mean(srednie), wariancja = mean((srednie - mu)^2),
        sigma2_przez_n = s2 / 2), 3)

# 2) symulacja: 10 000 średnich z 30 rzutów
set.seed(2026)
m30 <- replicate(10000, mean(sample(oczka, 30, replace = TRUE)))
round(c(SD_srednich = sd(m30), SE_ze_wzoru = sqrt(s2 / 30)), 3)
Wynik w konsoli R:
    mu sigma2  sigma
 3.500  2.917  1.708
srednie
  1 1.5   2 2.5   3 3.5   4 4.5   5 5.5   6
  1   2   3   4   5   6   5   4   3   2   1
       srednia      wariancja sigma2_przez_n
         3.500          1.458          1.458
SD_srednich SE_ze_wzoru
      0.311       0.312
Symulacja daje SD średnich 0,311 – prawie tyle samo co wzór σ/√n = 0,312.
Czy n = 30 zawsze wystarczy?
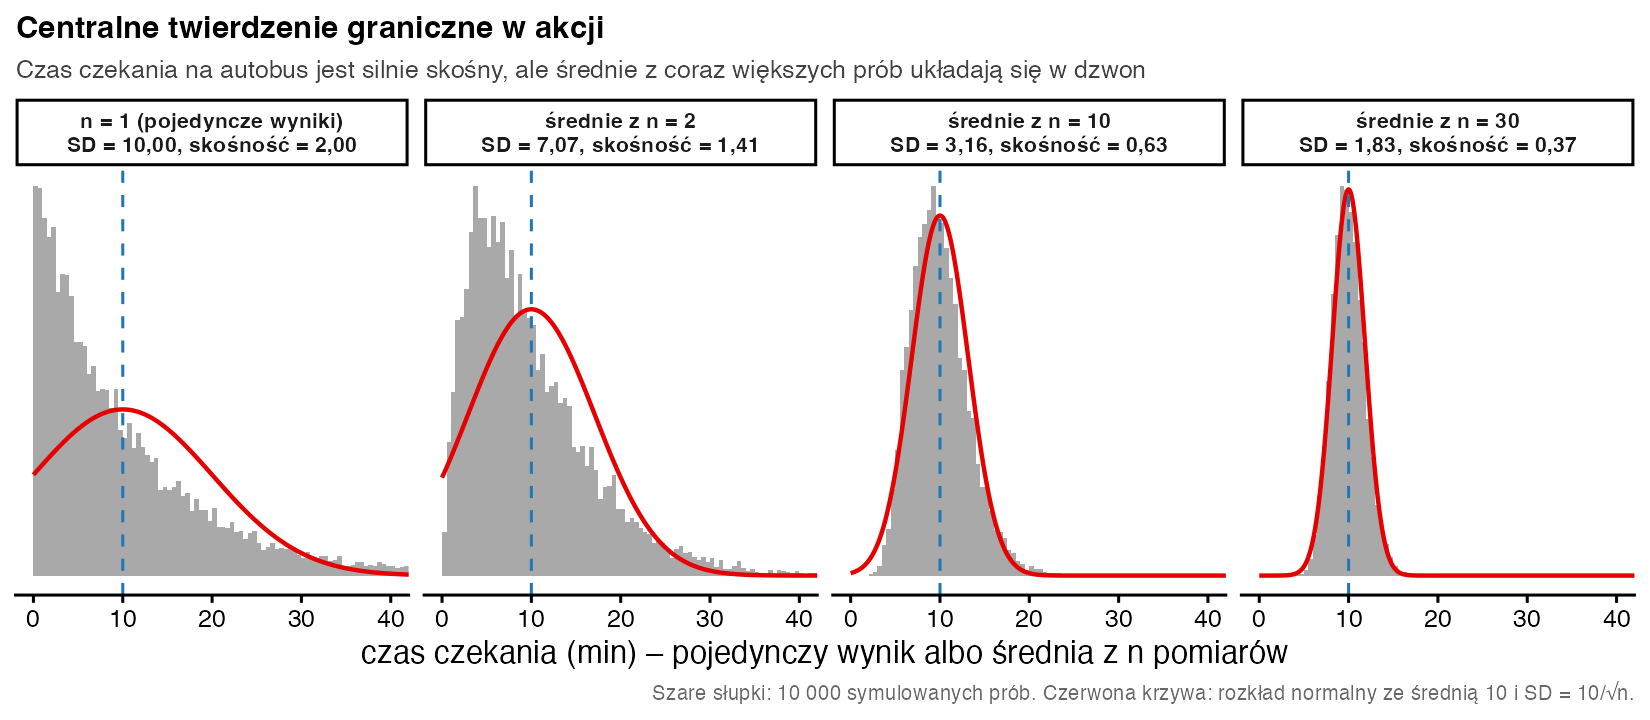
Nie. To tylko reguła kciuka. Przy rozkładach symetrycznych wystarczy często kilkanaście obserwacji, a przy silnie skośnych – czasem ponad sto. Dla czasu czekania z rysunku 2 przy n = 30 granice środkowych 95% standaryzowanych średnich wynoszą −1,78 i 2,13, a nie ±1,96. Rozkład średnich jest więc jeszcze wyraźnie niesymetryczny: zamiast 2,5% średnich w każdym ogonie dostaniesz około 3,4% po prawej i 1,4% po lewej stronie. Test t, który dodatkowo szacuje SD z próby, myli się tu jeszcze bardziej, i to głównie w lewym ogonie. Gdy masz wątpliwości, porównaj wynik z bootstrapem albo testem nieparametrycznym.
Najczęstsze błędy
- Twierdzenie, że „dzięki CTG dane mają rozkład normalny” – twierdzenie dotyczy rozkładu średnich, a nie wyników.
- Traktowanie n ≥ 30 jako magicznej granicy, niezależnie od skośności i wartości odstających.
- Pomijanie niezależności obserwacji (np. kilka pomiarów tej samej osoby liczonych jak różne osoby).
- Mylenie odchylenia standardowego danych (σ) z błędem standardowym średniej (σ/√n).
Bibliografia
- Fischer, H. (2011). A history of the central limit theorem: From classical to modern probability theory. Springer.
- Lumley, T., Diehr, P., Emerson, S., & Chen, L. (2002). The importance of the normality assumption in large public health data sets. Annual Review of Public Health, 23, 151–169.
- Field, A., Miles, J., & Field, Z. (2012). Discovering statistics using R. SAGE.
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówRozkład normalny
- Słownik wzorówBłąd standardowy średniej
- Słownik wzorówPrzedział ufności dla średniej
- PoradnikTest statystyczny – na czym polega
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.