

Przedział ufności dla średniej – wzór i przykład
Przedział ufności dla średniej to średnia z próby plus minus margines błędu. Pokazuje, jak dokładnie kilka zbadanych osób pozwala oszacować średnią w całej populacji. Typowe pytanie z pracy dyplomowej: ile średnio śpią studenci przed kolokwium i jak pewne jest to oszacowanie?
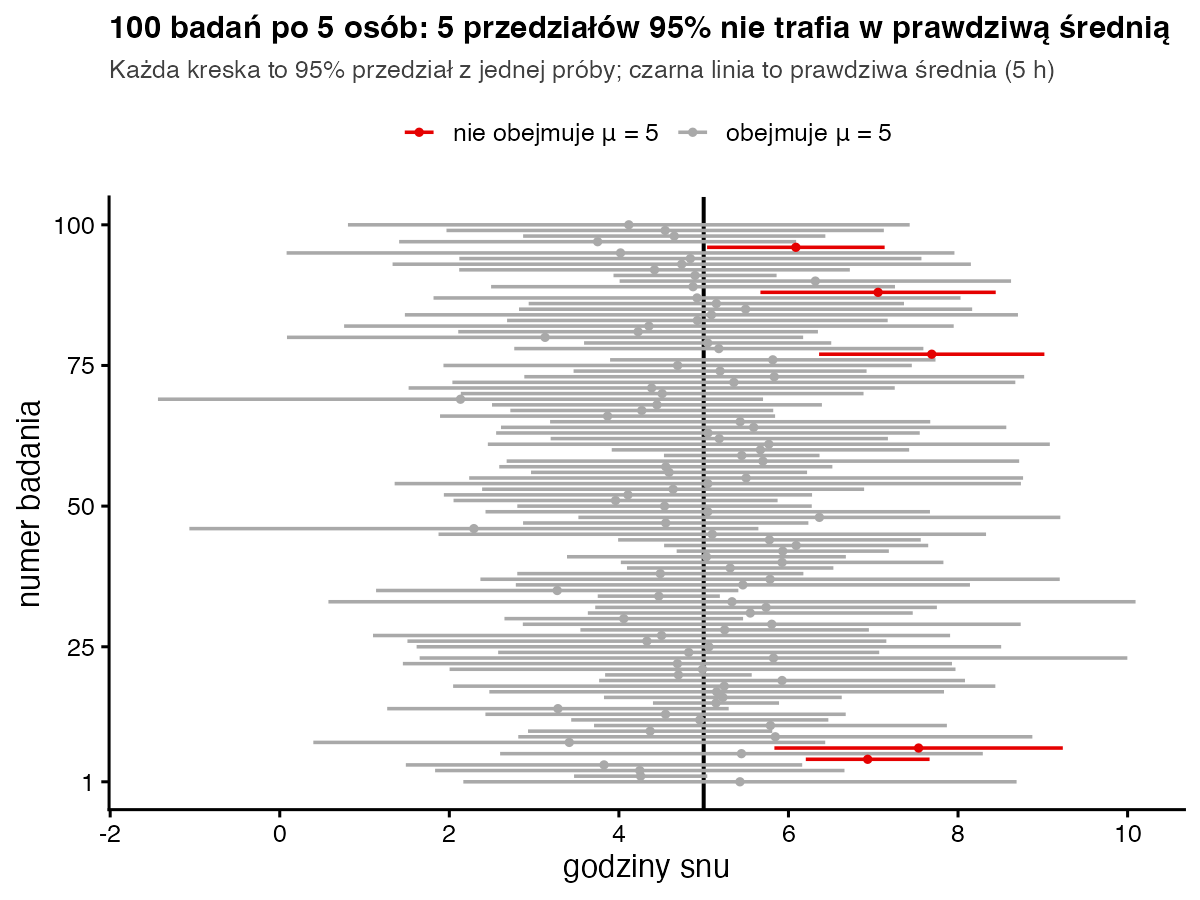
W prostych słowachŚrednia z próby to tylko jedno oszacowanie – inna grupa studentów dałaby trochę inny wynik. Przedział ufności dodaje do średniej margines, który jest szeroki, gdy wyniki są rozrzucone albo osób jest mało. „95%” to cecha metody: tak liczone przedziały w 95 na 100 badań obejmują prawdziwą średnią.
Kiedy stosować przedział ufności dla średniej?
- chcesz podać średnią razem z jej niepewnością – standard APA zaleca podawanie przedziałów ufności przy wynikach;
- zmienna jest ilościowa (godziny, punkty, wynik skali), a obserwacje są niezależne;
- przy małej próbie wyniki nie są mocno skośne; przy kilkudziesięciu osobach pomaga centralne twierdzenie graniczne.
Szerokość przedziału zależy od błędu standardowego średniej. Przedział łączy się z testem t dla jednej próby: jeśli 95% przedział nie obejmuje sprawdzanej wartości, test daje p < 0,05. Dla mediany i innych statystyk bez prostego wzoru użyj bootstrapu.
Wzór na przedział ufności dla średniej
- \(\bar{x}\)
- średnia z próby
- \(s\)
- odchylenie standardowe policzone z próby
- \(n\)
- liczba osób w próbie
- \(s/\sqrt{n}\)
- błąd standardowy średniej (SE) – o ile średnia zmieniałaby się od próby do próby
- \(t_{1-\alpha/2;\ n-1}\)
- wartość krytyczna rozkładu t dla df = n − 1; dla 95% i n = 5 wynosi 2,776
- \(z_{1-\alpha/2},\ \sigma\)
- 1,96 dla 95% – tylko wtedy, gdy odchylenie standardowe populacji σ znasz z góry (w pracach studenckich prawie nigdy)
Przykład krok po kroku
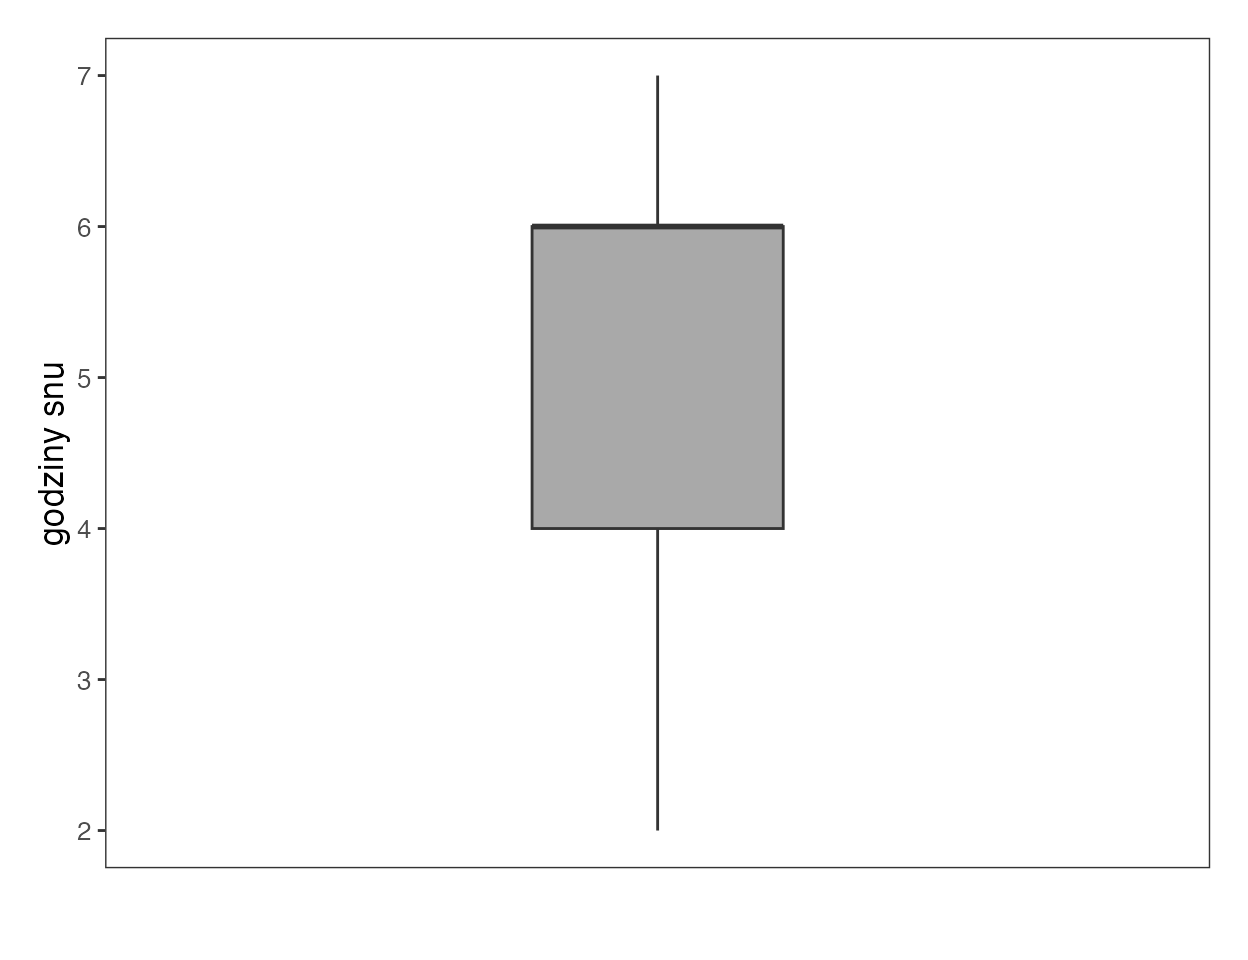
Pięcioro studentów zapisało, ile godzin spało przed kolokwium: 6, 2, 7, 4, 6. Policzmy 95% przedział ufności dla średniej.
| x | x − 5 | (x − 5)² |
|---|---|---|
| 6 | 1 | 1 |
| 2 | −3 | 9 |
| 7 | 2 | 4 |
| 4 | −1 | 1 |
| 6 | 1 | 1 |
| Σ = 25 | 0 | 16 |
- Średnia. 25 / 5 = 5 godzin.
- Odchylenie standardowe. s² = 16 / (5 − 1) = 4, więc s = 2.
- Błąd standardowy. SE = 2 / √5 = 0,894.
- Wartość krytyczna. Z tablic rozkładu t dla df = 4 i 95%: t = 2,776.
- Margines błędu. 2,776 · 0,894 = 2,48.
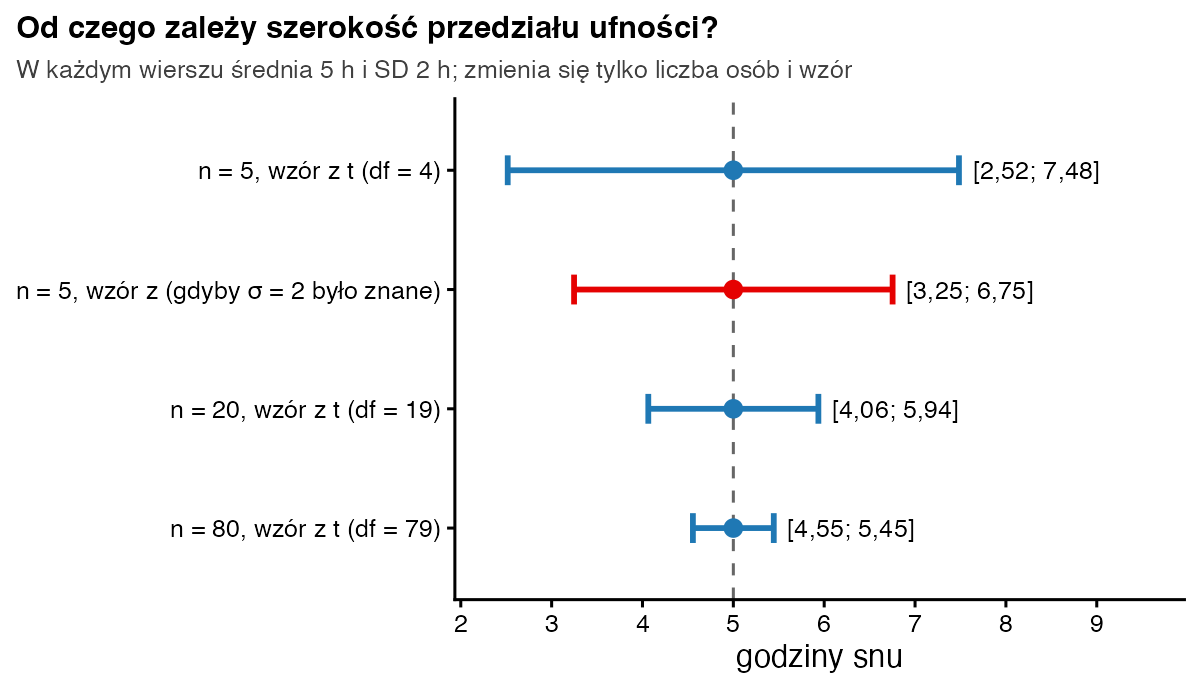
- Przedział. 5 − 2,48 = 2,52 oraz 5 + 2,48 = 7,48. Wynik: 95% CI [2,52; 7,48].
Dla porównania: gdyby σ = 2 było znane z góry, wzór z dałby 5 ± 1,96 · 0,894, czyli [3,25; 6,75]. Ten przedział jest węższy, bo nie uwzględnia niepewności, z jaką samo s oszacowaliśmy z pięciu osób.
Jak zinterpretować i opisać wynik?
Poprawnie: „gdybyśmy wiele razy losowali po pięciu studentów i za każdym razem liczyli taki przedział, około 95% przedziałów objęłoby prawdziwą średnią”. Niepoprawnie: „z prawdopodobieństwem 95% prawdziwa średnia leży między 2,52 a 7,48” – ten konkretny przedział albo ją obejmuje, albo nie (Hoekstra i in., 2014). W praktyce przedział od 2,5 do 7,5 godziny mówi, że pięć osób to za mało, by precyzyjnie oszacować średni sen. Zawsze podawaj poziom ufności i to, z jakiego wzoru korzystasz.
Zapis w stylu APA: Studenci spali przed kolokwium średnio M = 5,00 godziny (SD = 2,00; 95% CI [2,52; 7,48]).
Jak policzyć przedział ufności w R?
sen <- c(6, 2, 7, 4, 6)

# 1) „ręcznie”, według wzoru z rozkładem t (sigma nieznane)
n    <- length(sen)
se   <- sd(sen) / sqrt(n)               # błąd standardowy średniej
t_kr <- qt(0.975, df = n - 1)           # wartość krytyczna t dla 95%
c(srednia = mean(sen), SE = se, t_kr = t_kr)
mean(sen) + c(-1, 1) * t_kr * se        # 95% przedział ufności

# 2) gotową funkcją
t.test(sen)$conf.int

# 3) wariant z – tylko gdy sigma populacji znasz z góry (tu: sigma = 2)
mean(sen) + c(-1, 1) * qnorm(0.975) * 2 / sqrt(n)
Wynik w konsoli R:
  srednia        SE      t_kr
5.0000000 0.8944272 2.7764451
[1] 2.516672 7.483328
[1] 2.516672 7.483328
attr(,"conf.level")
[1] 0.95
[1] 3.246955 6.753045
Przedział ufności czy odchylenie standardowe – co podać?
Najlepiej oba, bo odpowiadają na różne pytania. Odchylenie standardowe opisuje, jak bardzo różnią się od siebie osoby: jedni śpią 2 godziny, inni 7. Przedział ufności opisuje, jak dokładnie znamy średnią. Gdy zbadasz więcej osób, SD zostanie mniej więcej takie samo, a przedział ufności się zwęzi. Dlatego zapis „5 ± 2” bez wyjaśnienia jest niejasny – zawsze dopisz, czy to SD, SE czy 95% CI.
Najczęstsze błędy
- Interpretacja „na 95% prawdziwa średnia leży w tym przedziale” zamiast opisu własności metody.
- Używanie z = 1,96 przy małej próbie i nieznanym σ – przedział wychodzi za wąski.
- Mylenie odchylenia standardowego z błędem standardowym i przedziału ufności z zakresem wyników osób.
- Przekonanie, że przedział „naprawia” stronniczą próbę – zakłada on losowy dobór osób.
- Podawanie samego „±” bez informacji, czy to SD, SE czy przedział ufności.
Bibliografia
- Neyman, J. (1937). Outline of a theory of statistical estimation based on the classical theory of probability. Philosophical Transactions of the Royal Society of London. Series A, 236(767), 333–380. https://doi.org/10.1098/rsta.1937.0005
- Cumming, G. (2014). The new statistics: Why and how. Psychological Science, 25(1), 7–29. https://doi.org/10.1177/0956797613504966
- Hoekstra, R., Morey, R. D., Rouder, J. N., & Wagenmakers, E.-J. (2014). Robust misinterpretation of confidence intervals. Psychonomic Bulletin & Review, 21(5), 1157–1164. https://doi.org/10.3758/s13423-013-0572-3
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówBłąd standardowy średniej
- Słownik wzorówTest t dla jednej próby
- Słownik wzorówBootstrap
- PoradnikInterpretacja wyników statystycznych
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.