

Błąd standardowy średniej (SE) – wzór, przykład i różnica z SD
Błąd standardowy średniej (SE) mówi, jak bardzo średnia z próby wahałaby się, gdybyś powtórzył badanie na innych osobach. Typowe pytanie z pracy dyplomowej: na ile mogę ufać, że średnio 5 godzin snu w mojej próbie jest bliskie średniej wszystkich studentów?
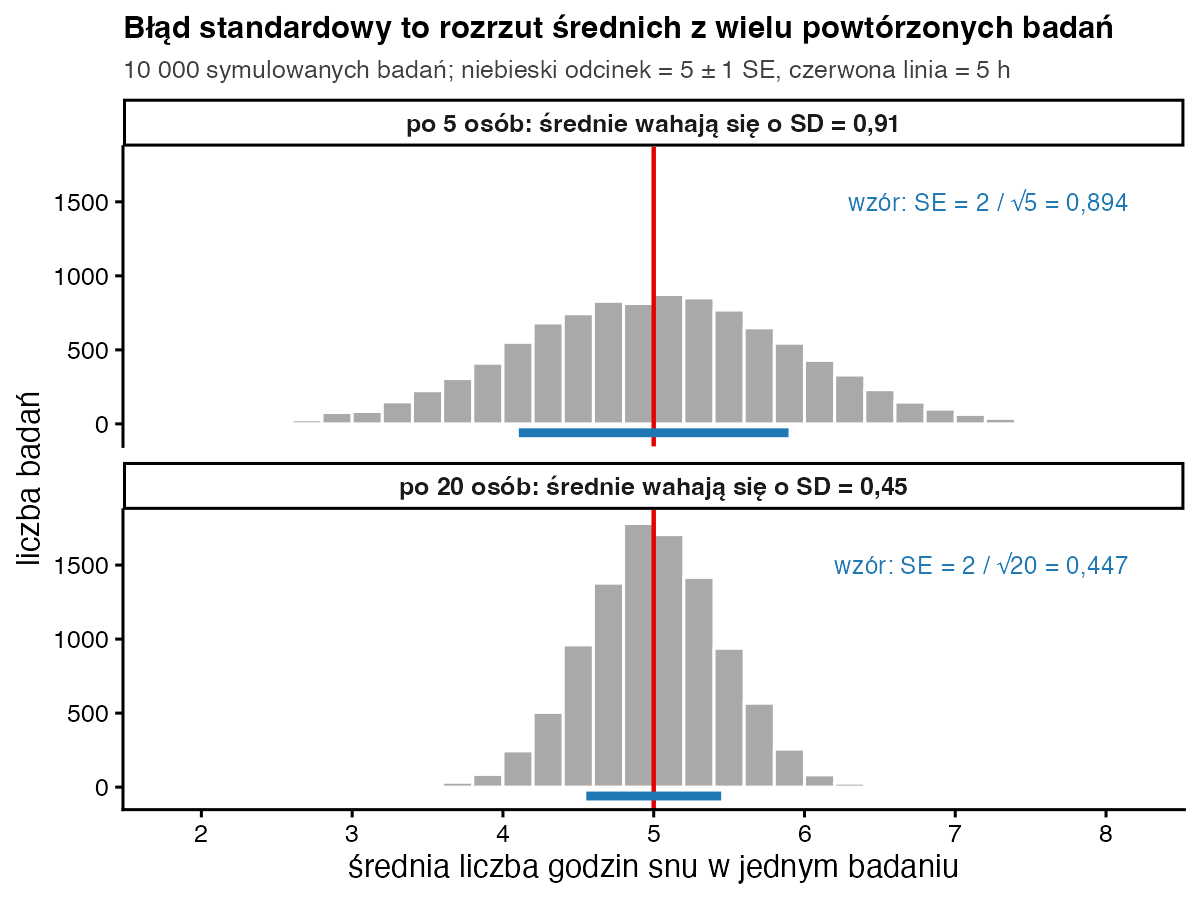
W prostych słowachOdchylenie standardowe mówi, jak bardzo różnią się między sobą ludzie. Błąd standardowy mówi, jak bardzo różniłyby się średnie z kolejnych badań. Im więcej osób zbadasz, tym mniej średnia „skacze” i tym mniejszy SE. Żeby jednak zmniejszyć go o połowę, potrzebujesz czterech razy więcej osób.
Kiedy stosować błąd standardowy?
- chcesz ocenić precyzję średniej, a nie rozrzut wyników;
- budujesz przedział ufności dla średniej albo liczysz test t;
- rysujesz „wąsy” na wykresie średnich – wtedy w podpisie napisz, czy to SE, SD czy przedział ufności.
SE liczysz z odchylenia standardowego, a najczęściej przydaje się do przedziału ufności dla średniej i testu t dla jednej próby. Dlaczego średnie z wielu prób układają się w rozkład zbliżony do normalnego, wyjaśnia centralne twierdzenie graniczne.
Wzór na błąd standardowy średniej
- \(SE\)
- błąd standardowy średniej (w literaturze także SEM)
- \(s\)
- odchylenie standardowe z próby
- \(n\)
- liczba osób
- \(\sqrt{n}\)
- pierwiastek z liczby osób – dlatego cztery razy większa próba daje dwa razy mniejszy SE
- \(\bar{x}\)
- średnia z próby
- \(t_{0{,}975;\ n-1}\)
- wartość z rozkładu t dla n − 1 stopni swobody; dla n = 5 wynosi 2,776
Przykład krok po kroku
Te same godziny snu co w hasłach o średniej i odchyleniu standardowym: 6, 2, 7, 4, 6. Średnia wynosi 5 godzin.
| x | x − 5 | (x − 5)² |
|---|---|---|
| 6 | 1 | 1 |
| 2 | −3 | 9 |
| 7 | 2 | 4 |
| 4 | −1 | 1 |
| 6 | 1 | 1 |
| Σ = 25 | 0 | 16 |
- Odchylenie standardowe. SD = √(16 / 4) = √4 = 2 godziny.
- Pierwiastek z n. √5 = 2,236.
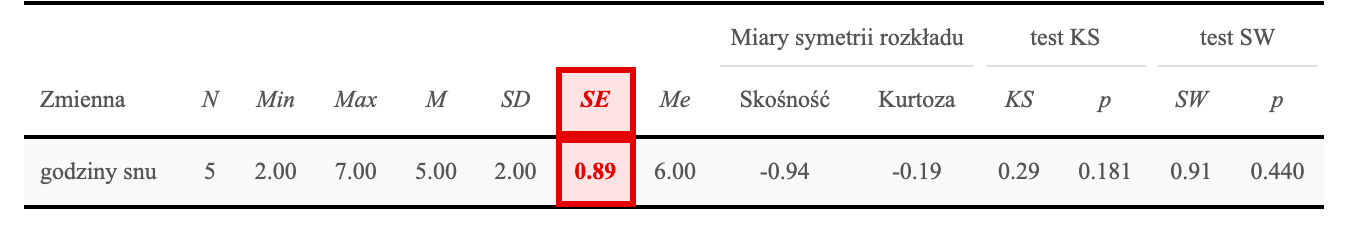
- Błąd standardowy. SE = 2 / 2,236 = 0,894 godziny.
- Wartość t. Dla 4 stopni swobody i 95% ufności t = 2,776 (tablice albo R).
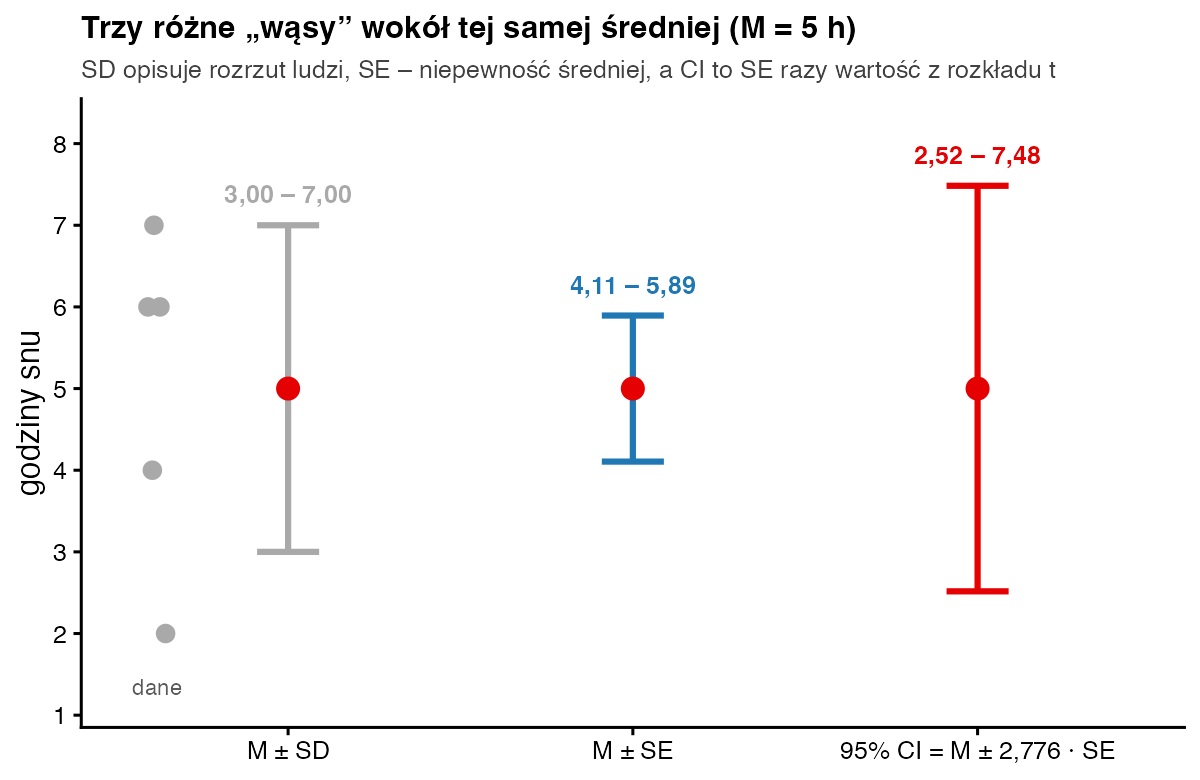
- Przedział ufności. 5 ± 2,776 · 0,894 = 5 ± 2,48, czyli od 2,52 do 7,48 godziny.
- Większa próba. Przy 20 osobach i tym samym SD: SE = 2 / √20 = 0,447 – dwa razy mniej.
Jak zinterpretować i opisać wynik?
Średnia z próby (5 godzin) jest obarczona niepewnością rzędu 0,9 godziny. 95% przedział ufności od 2,52 do 7,48 godziny jest bardzo szeroki: dane pasują zarówno do 3, jak i do 7 godzin snu. Przy pięciu osobach to nic dziwnego. SE nie mówi natomiast nic o tym, czy próba jest reprezentatywna. Jeśli zbadasz tylko znajomych z akademika, nawet duża próba da precyzyjną, ale przesuniętą średnią.
Zapis w stylu APA: W noc przed kolokwium studenci spali średnio 5 godzin (M = 5,00; SE = 0,89; 95% CI [2,52; 7,48]).
Jak policzyć błąd standardowy w R?
sen <- c(6, 2, 7, 4, 6)
n <- length(sen)

# 1) „ręcznie”, dokładnie według wzoru
se <- sd(sen) / sqrt(n)
se                                              # 2 / √5 = 0.894
qt(0.975, df = n - 1)                           # wartość t dla 95% CI: 2.776
mean(sen) + c(-1, 1) * qt(0.975, n - 1) * se    # 95% CI: 2.52; 7.48

# 2) gotowymi funkcjami
t.test(sen)$conf.int
psych::describe(sen)$se

# 3) cztery razy więcej osób przy tym samym SD = 2 -> SE o połowę mniejszy
2 / sqrt(20)
Wynik w konsoli R:
[1] 0.8944272
[1] 2.776445
[1] 2.516672 7.483328
[1] 2.516672 7.483328
attr(,"conf.level")
[1] 0.95
[1] 0.8944272
[1] 0.4472136
W aplikacji SZTOS wąsy na wykresach porównań grup oznaczają średnią ± 2 SE. Przy dużych próbach to prawie 95% przedział ufności, ale przy pięciu osobach właściwy mnożnik to 2,776.
SD czy SE – co podać w pracy?
W tabeli opisującej próbę podaj SD, bo opisuje ono Twoich badanych. SE, a jeszcze lepiej przedział ufności, podaj wtedy, gdy mówisz o tym, jak dokładnie oszacowałeś średnią (Altman i Bland, 2005). SE jest zawsze mniejszy od SD, więc kusi, żeby go podać – wykres wygląda wtedy „czyściej”. To jednak ukrywa prawdziwy rozrzut wyników. Na wykresach zawsze podpisuj, co oznaczają wąsy (Cumming i in., 2007).
Najczęstsze błędy
- Podawanie SE zamiast SD w tabeli statystyk opisowych.
- Niepodpisane wąsy na wykresie średnich.
- Traktowanie M ± 2 SE jako 95% przedziału ufności w bardzo małej próbie – przy n = 5 mnożnik to 2,776.
- Mylenie precyzji z reprezentatywnością: mały SE nie naprawi źle dobranej próby.
- Mylenie SE średniej z innymi błędami standardowymi, np. SE współczynnika regresji.
Bibliografia
- Student. (1908). The probable error of a mean. Biometrika, 6(1), 1–25. https://doi.org/10.1093/biomet/6.1.1
- Altman, D. G., & Bland, J. M. (2005). Standard deviations and standard errors. BMJ, 331(7521), 903. https://doi.org/10.1136/bmj.331.7521.903
- Cumming, G., Fidler, F., & Vaux, D. L. (2007). Error bars in experimental biology. The Journal of Cell Biology, 177(1), 7–11. https://doi.org/10.1083/jcb.200611141
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówOdchylenie standardowe
- Słownik wzorówPrzedział ufności dla średniej
- Słownik wzorówCentralne twierdzenie graniczne
- PoradnikStatystyka opisowa – przykład
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
- Przykładowy raportOpis próby
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.