

Analiza kowariancji (ANCOVA) – wzory, założenia i przykład
Analiza kowariancji (ANCOVA) porównuje średnie grup po uwzględnieniu zmiennej ilościowej, która też wiąże się z wynikiem – najczęściej wyniku sprzed badania (pretestu). Typowe pytanie z pracy dyplomowej: czy grupa warsztatowa ma lepszy wynik po zajęciach niż kontrolna, jeśli weźmiemy pod uwagę, ile każdy umiał na starcie?
W prostych słowachGdy jedna grupa zaczyna z wyższego poziomu, część jej przewagi na końcu nie wynika z warsztatów. ANCOVA szacuje, jak bardzo wynik końcowy zależy od pretestu, i „przesuwa” obie grupy do tego samego, średniego pretestu. Porównujesz wtedy średnie skorygowane – wyniki grup przy tym samym starcie.
Kiedy stosować ANCOVA?
- porównujesz grupy pod względem zmiennej ilościowej i masz zmienną towarzyszącą (kowariant), np. pretest, wiek, liczbę godzin nauki;
- kowariant zmierzono przed interwencją, więc grupa nie mogła na niego wpłynąć;
- związek kowariantu z wynikiem jest liniowy;
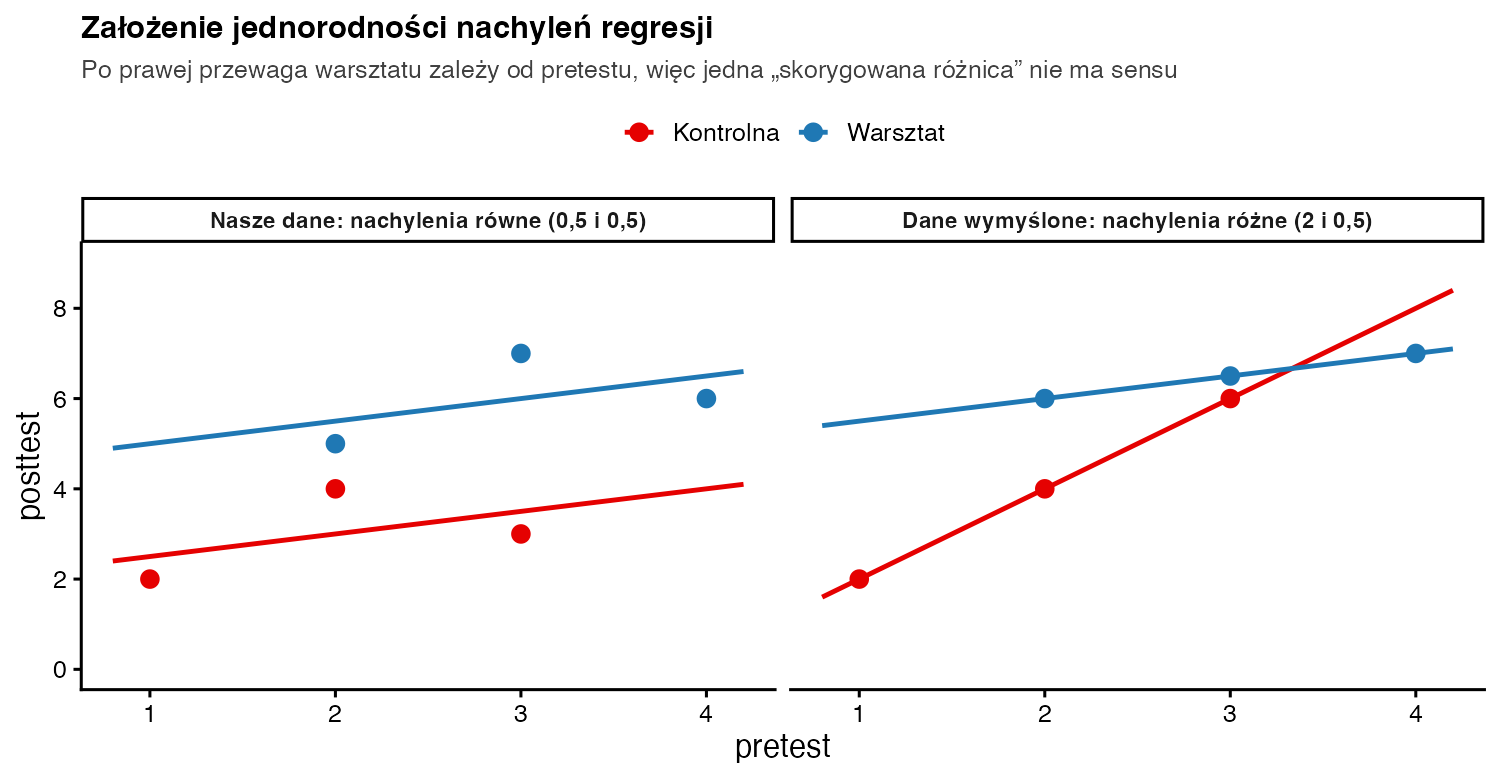
- nachylenie tego związku jest takie samo w każdej grupie – to jednorodność nachyleń (brak interakcji grupa × kowariant);
- reszty mają rozkład zbliżony do normalnego i podobne wariancje w grupach.
Bez kowariantu wystarczy jednoczynnikowa ANOVA. Dla danych „przed i po” alternatywą jest ANOVA w planie mieszanym. Technicznie ANCOVA to regresja liniowa z predyktorem ilościowym i jakościowym.
Wzory ANCOVA
- \(y_{ij},\ x_{ij}\)
- wynik końcowy i wartość kowariantu (pretestu) osoby i z grupy j
- \(\bar{y}_j,\ \bar{x}_j,\ \bar{x}\)
- średnie grupy j (wynik i pretest) oraz średni pretest wszystkich osób
- \(b_w\)
- wspólne nachylenie wewnątrzgrupowe: o ile rośnie wynik, gdy pretest rośnie o 1, w obrębie grupy
- \(\bar{y}'_j\)
- średnia skorygowana grupy j – przewidywany wynik przy średnim preteście
- \(SS_E,\ MS_E\)
- suma kwadratów i średni kwadrat reszt po uwzględnieniu grupy i kowariantu
- \(k,\ N,\ n_j\)
- liczba grup, liczba wszystkich osób i liczba osób w grupie j; df błędu = N − k − 1
Przykład krok po kroku
Sześcioro studentów napisało test przed zajęciami (pretest) i po nich (posttest). Troje było w grupie kontrolnej, troje na warsztatach. Grupa warsztatowa miała wyższy pretest.
| Grupa | Pretest x | Posttest y | x − x̄grupy | y − ȳgrupy | iloczyn | (x − x̄grupy)² |
|---|---|---|---|---|---|---|
| Kontrolna | 1 | 2 | −1 | −1 | 1 | 1 |
| Kontrolna | 2 | 4 | 0 | 1 | 0 | 0 |
| Kontrolna | 3 | 3 | 1 | 0 | 0 | 1 |
| Warsztat | 2 | 5 | −1 | −1 | 1 | 1 |
| Warsztat | 3 | 7 | 0 | 1 | 0 | 0 |
| Warsztat | 4 | 6 | 1 | 0 | 0 | 1 |
| Razem | Σ = 15 | Σ = 27 | 0 | 0 | 2 | 4 |
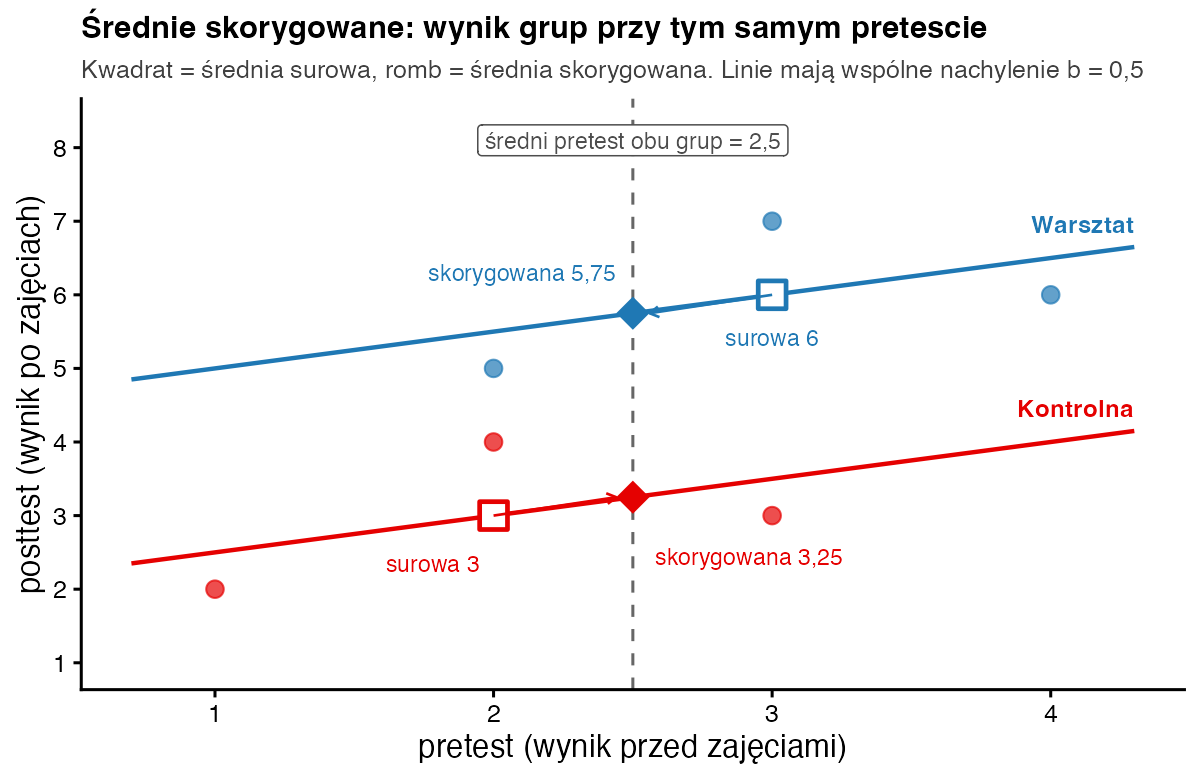
- Średnie. Kontrolna: pretest 2, posttest 3. Warsztat: pretest 3, posttest 6. Surowa różnica: 3 punkty. Średni pretest wszystkich: 15 / 6 = 2,5.
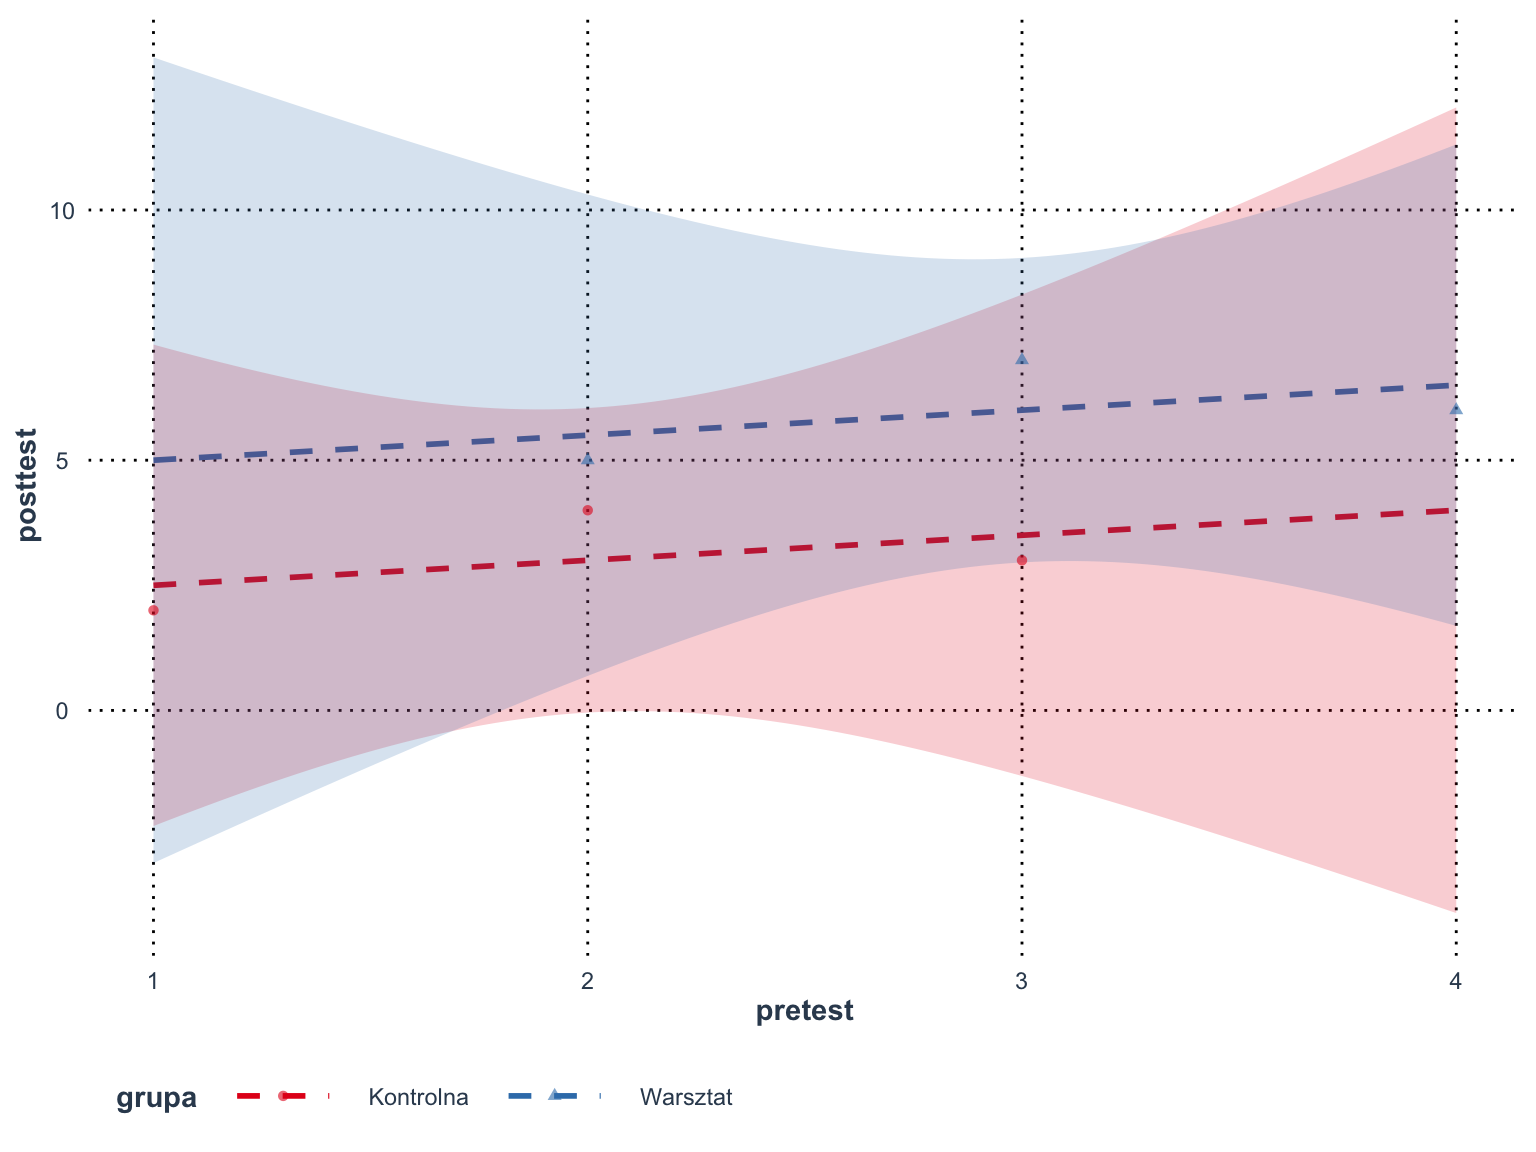
- Nachylenie. bw = 2 / 4 = 0,5. W każdej grupie osobno też wychodzi 1 / 2 = 0,5, więc nachylenia są identyczne – jednorodność nachyleń jest spełniona idealnie.
- Średnie skorygowane. Kontrolna: 3 − 0,5 · (2 − 2,5) = 3,25. Warsztat: 6 − 0,5 · (3 − 2,5) = 5,75. Różnica skorygowana: 2,5 punktu.
- Błąd. Reszty od prostej każdej grupy wynoszą −0,5; 1 i −0,5, więc SSE = 2 · (0,25 + 1 + 0,25) = 3; df = 6 − 2 − 1 = 3; MSE = 1.
- Test. Mianownik: 1 · (1/3 + 1/3 + 1²/4) = 11/12. F = 2,5² / (11/12) = 6,82; df = 1 i 3; p = 0,080. Przy MSE = 1 suma kwadratów grupy też wynosi 6,82, więc η²p = SSgrupa / (SSgrupa + SSE) = 6,82 / (6,82 + 3) = 0,69.
- Porównanie. Bez pretestu (zwykła ANOVA) różnica 3 punktów daje F(1, 4) = 13,5 i p = 0,021. Po korekcie efekt jest mniejszy i nieistotny.
Jak zinterpretować i opisać wynik?
Surowa przewaga warsztatu wynosiła 3 punkty, ale część z niej wynikała z wyższego pretestu. Przy jednakowym preteście różnica spada do 2,5 punktu i nie jest istotna (p = 0,080). To nie dowód, że warsztaty nie działają – przy trzech osobach w grupie test ma bardzo małą moc.
Zapis w stylu APA: Po uwzględnieniu wyniku pretestu różnica między grupą warsztatową (Mskor = 5,75) a kontrolną (Mskor = 3,25) nie była istotna statystycznie, F(1, 3) = 6,82; p = 0,080; η²p = 0,69. Nachylenia regresji posttestu względem pretestu były w obu grupach jednakowe (b = 0,50), więc założenie jednorodności nachyleń było spełnione.
Jak policzyć ANCOVA w R?
grupa    <- factor(rep(c("Kontrolna", "Warsztat"), each = 3))
pretest  <- c(1, 2, 3, 2, 3, 4)
posttest <- c(2, 4, 3, 5, 7, 6)

# 1) założenie: jednorodność nachyleń (interakcja grupa × pretest powinna być nieistotna)
round(anova(lm(posttest ~ pretest * grupa))["pretest:grupa", c("F value", "Pr(>F)")], 3)

# 2) ANCOVA: car::Anova() z typem III (albo aov z kowariantem PRZED czynnikiem)
model <- lm(posttest ~ pretest + grupa)
car::Anova(model, type = 3)
emmeans::emmeans(model, ~ grupa)          # średnie skorygowane (przy pretest = 2,5)

# 3) pułapka: w aov() czynnik wpisany PRZED kowariantem nie jest skorygowany (typ I)
summary(aov(posttest ~ grupa + pretest))
Wynik w konsoli R:
              F value Pr(>F)
pretest:grupa       0      1
Anova Table (Type III tests)

Response: posttest
            Sum Sq Df F value Pr(>F)
(Intercept) 3.0000  1  3.0000 0.1817
pretest     1.0000  1  1.0000 0.3910
grupa       6.8182  1  6.8182 0.0796 .
Residuals   3.0000  3
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
 grupa     emmean    SE df lower.CL upper.CL
 Kontrolna   3.25 0.629  3     1.25     5.25
 Warsztat    5.75 0.629  3     3.75     7.75

Confidence level used: 0.95
            Df Sum Sq Mean Sq F value Pr(>F)
grupa        1   13.5    13.5    13.5 0.0349 *
pretest      1    1.0     1.0     1.0 0.3910
Residuals    3    3.0     1.0
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
Zwróć uwagę na ostatnią tabelę: aov(posttest ~ grupa + pretest) liczy sumy kwadratów typu I, czyli po kolei. Grupa wpisana jako pierwsza nie jest skorygowana o pretest, więc dostajesz F = 13,5 i p = 0,035 zamiast poprawnego F = 6,82 i p = 0,080. Wpisz kowariant przed czynnikiem albo użyj car::Anova().
Czy ANCOVA zastąpi losowy przydział do grup?
Nie. Gdy grupy powstały bez losowania (np. dwa różne roczniki), ANCOVA nie „wyrówna” ich w pełni. Koryguje tylko o zmierzony kowariant i tylko liniowo. Gdy grupy w ogóle nie nakładają się pod względem kowariantu, średnie skorygowane są zgadywaniem poza zakresem danych (Miller i Chapman, 2001). ANCOVA najlepiej sprawdza się w eksperymencie z losowym przydziałem, gdzie zmniejsza błąd i zwiększa moc testu.
Najczęstsze błędy
- Wpisanie w
aov()czynnika przed kowariantem – efekt grupy nie jest wtedy skorygowany. - Brak sprawdzenia jednorodności nachyleń (interakcji grupa × kowariant).
- Kowariant zmierzony po interwencji, więc sam mógł się zmienić pod jej wpływem.
- Traktowanie ANCOVA jako „naprawy” braku losowego przydziału do grup.
- Raportowanie średnich surowych zamiast skorygowanych.
Bibliografia
- Huitema, B. E. (2011). The analysis of covariance and alternatives: Statistical methods for experiments, quasi-experiments, and single-case studies (2nd ed.). Wiley.
- Miller, G. A., & Chapman, J. P. (2001). Misunderstanding analysis of covariance. Journal of Abnormal Psychology, 110(1), 40–48. https://doi.org/10.1037/0021-843X.110.1.40
- Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). SAGE.
- Field, A., Miles, J., & Field, Z. (2012). Discovering statistics using R. SAGE.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówJednoczynnikowa ANOVA
- Słownik wzorówRegresja liniowa
- Słownik wzorówEta kwadrat (η²)
- PoradnikANOVA – przykład
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
- Przykładowy raportAnaliza wariancji
Przygotowujesz artykuł, doktorat lub grant?
Zaplanujemy i wykonamy analizy, przygotujemy raport z tabelami, wykresami i kodem R oraz pomożemy odpowiedzieć na uwagi recenzentów dotyczące statystyki.