

Jednoczynnikowa analiza wariancji (ANOVA) – wzór i przykład
Jednoczynnikowa analiza wariancji (ANOVA) sprawdza, czy średnie w trzech lub więcej grupach różnych osób różnią się bardziej, niż mogłyby się różnić przez przypadek. Typowe pytanie z pracy dyplomowej: czy studenci z trzech grup ćwiczeniowych zdobywają średnio tyle samo punktów z kolokwium?
W prostych słowachF = zróżnicowanie między grupami ÷ zróżnicowanie wewnątrz grup. Jeśli średnie grup różnią się mniej więcej tak jak osoby z tej samej grupy, F jest bliskie 1. Im bardziej średnie „odjeżdżają” od siebie, tym większe F. ANOVA mówi, czy jakieś różnice są, a które grupy się różnią – pokazuje dopiero test post hoc.
Kiedy stosować jednoczynnikową ANOVA?
- porównujesz trzy lub więcej grup różnych osób (np. grupy ćwiczeniowe, kierunki studiów);
- zmienna zależna jest ilościowa (punkty, czas, wynik skali);
- wyniki w grupach (reszty) mają rozkład zbliżony do normalnego – przy większych grupach test jest na to dość odporny;
- rozrzut wyników w grupach jest podobny – sprawdzisz to testem Levene’a; jeśli nie jest, wybierz ANOVA Welcha.
Przy dwóch grupach ANOVA daje ten sam wynik co test t Studenta (F = t²). Gdy te same osoby mierzysz kilka razy, potrzebujesz ANOVA z powtarzanymi pomiarami. Gdy wyniki są porządkowe albo bardzo skośne – testu Kruskala-Wallisa.
Wzór na statystykę F w ANOVA
- \(x_{ij}\)
- wynik i-tej osoby w grupie j
- \(\bar{x}_j,\ n_j\)
- średnia i liczba osób w grupie j
- \(\bar{x}\)
- średnia ogólna – średnia wszystkich wyników razem
- \(SS_B\)
- suma kwadratów między grupami: jak daleko średnie grup leżą od średniej ogólnej
- \(SS_W\)
- suma kwadratów wewnątrz grup: jak daleko wyniki leżą od średniej własnej grupy
- \(MS_B,\ MS_W\)
- średnie kwadraty, czyli sumy kwadratów podzielone przez stopnie swobody
- \(k,\ N\)
- liczba grup i liczba wszystkich osób; stopnie swobody to k − 1 oraz N − k
Przykład krok po kroku
Dziewięcioro studentów z trzech grup ćwiczeniowych napisało kolokwium (0–10 punktów). Grupa A: 1, 3, 5. Grupa B: 2, 4, 6. Grupa C: 7, 8, 9.
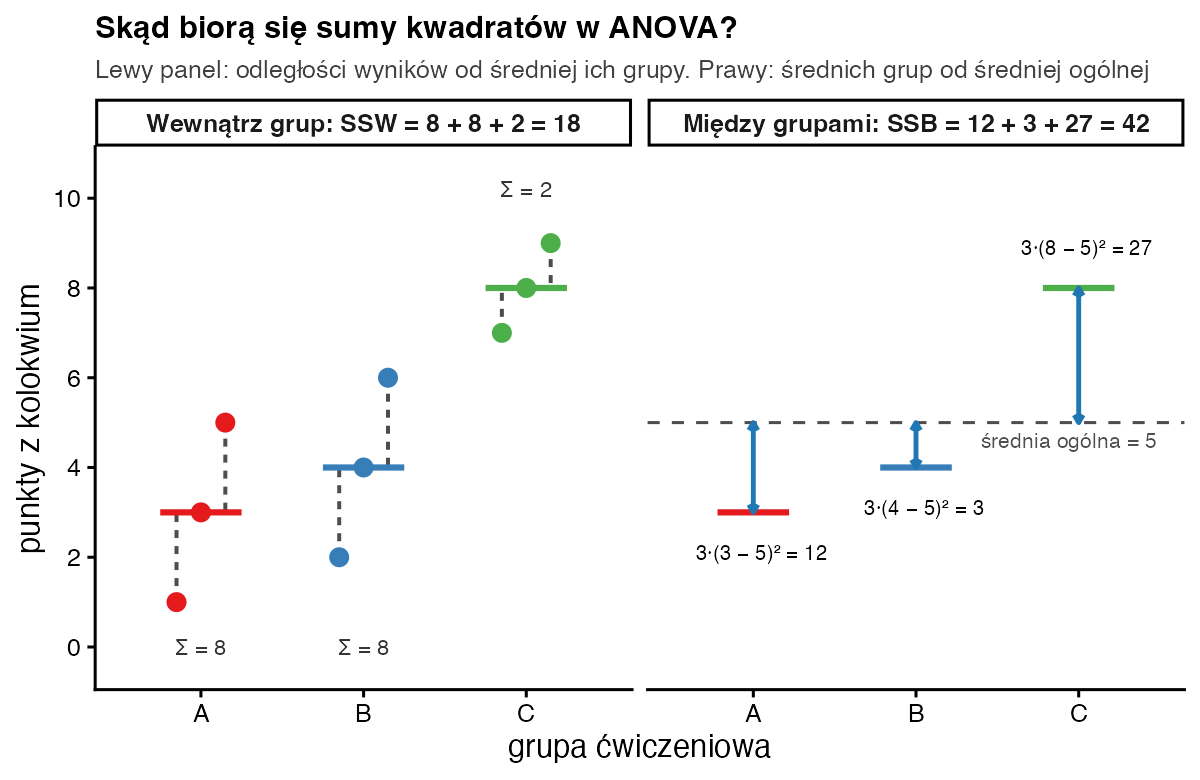
| Grupa | Wyniki x | Średnia grupy | (x − średnia grupy)² | Suma w grupie | n · (średnia grupy − 5)² |
|---|---|---|---|---|---|
| A | 1, 3, 5 | 3 | 4, 0, 4 | 8 | 3 · (−2)² = 12 |
| B | 2, 4, 6 | 4 | 4, 0, 4 | 8 | 3 · (−1)² = 3 |
| C | 7, 8, 9 | 8 | 1, 0, 1 | 2 | 3 · 3² = 27 |
| razem | Σ = 45 | 5 | – | SSW = 18 | SSB = 42 |
- Średnie. A: 9 / 3 = 3. B: 12 / 3 = 4. C: 24 / 3 = 8. Średnia ogólna: 45 / 9 = 5.
- Zmienność wewnątrz grup. \(SS_W = 8 + 8 + 2 = 18\).
- Zmienność między grupami. \(SS_B = 12 + 3 + 27 = 42\). Kontrola: suma kwadratów odchyleń wszystkich wyników od 5 wynosi 60 = 42 + 18.
- Średnie kwadraty. \(MS_B = 42 / 2 = 21\), \(MS_W = 18 / 6 = 3\).
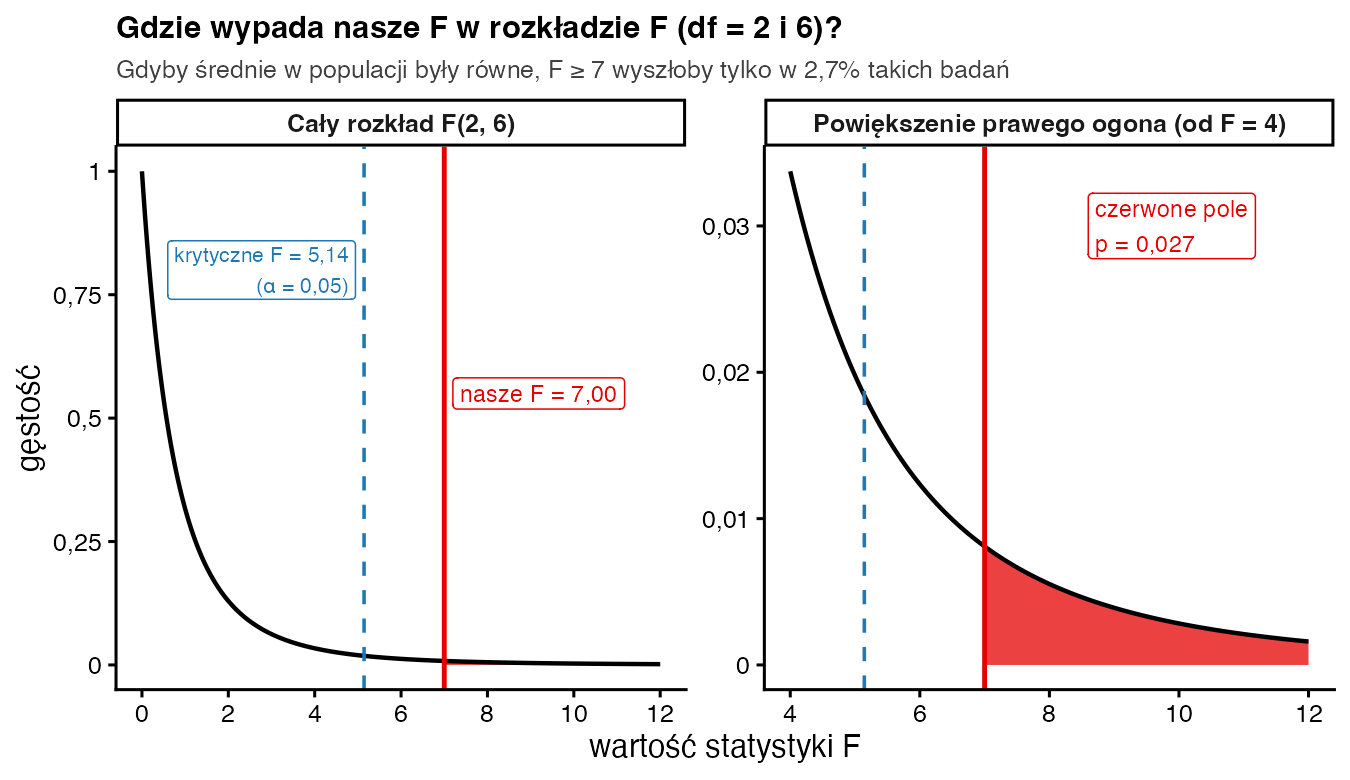
- Statystyka F. F = 21 / 3 = 7,00; df = 2 i 6; p = 0,027 (wartość krytyczna dla α = 0,05 to 5,14).
- Wielkość efektu. Eta kwadrat: η² = 42 / 60 = 0,70.
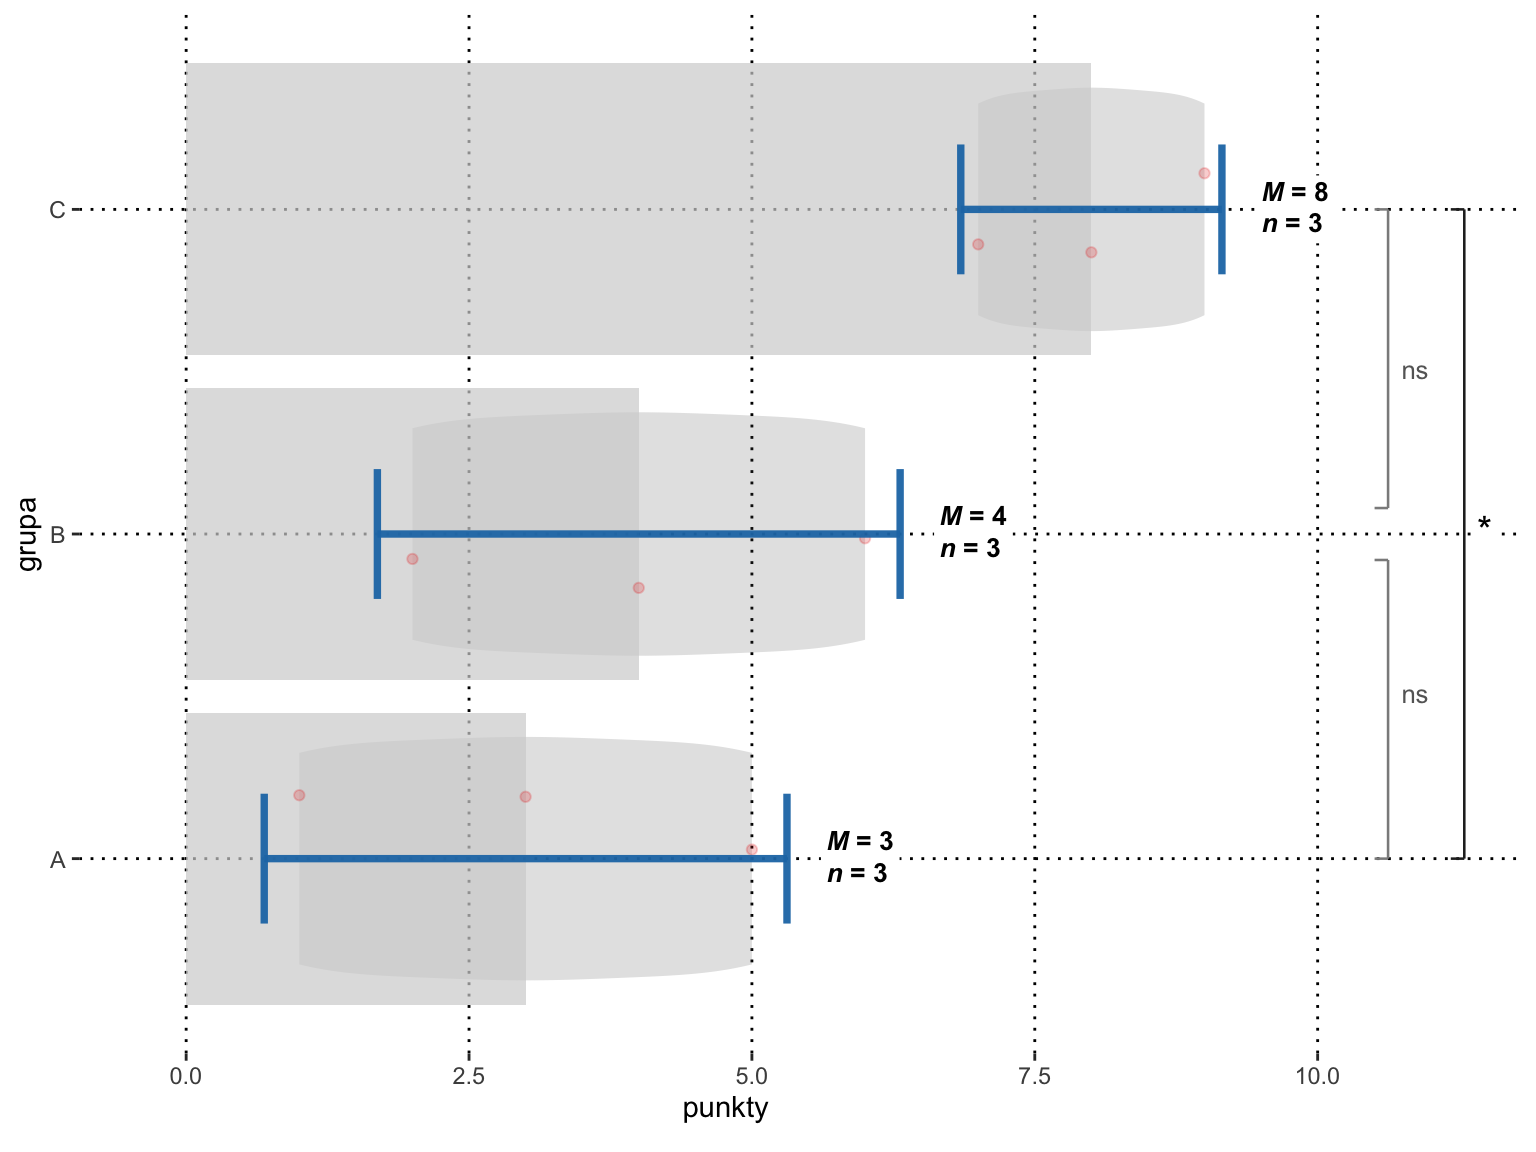
- Które grupy się różnią? Test post hoc Tukeya wskazuje tylko parę C–A (p = 0,028). Różnice C–B (p = 0,067) i B–A (p = 0,768) nie są istotne.
Jak zinterpretować i opisać wynik?
Gdyby średnie grup były w populacji równe, F = 7 lub większe otrzymalibyśmy tylko w około 2,7% podobnych badań – to mówi wartość p. η² = 0,70 znaczy, że przynależność do grupy wyjaśnia 70% zmienności punktów. Umownie 0,01 to efekt mały, 0,06 – średni, a 0,14 – duży (Cohen, 1988). Istotne F nie znaczy, że każda grupa różni się od każdej: tutaj od grupy A odstaje tylko grupa C. Trzy osoby w grupie to tylko ilustracja.
Zapis w stylu APA: Grupy ćwiczeniowe różniły się istotnie liczbą punktów z kolokwium, F(2, 6) = 7,00; p = 0,027; η² = 0,70. Test post hoc Tukeya wykazał, że grupa C (M = 8,00; SD = 1,00) uzyskała więcej punktów niż grupa A (M = 3,00; SD = 2,00), p = 0,028. Grupa B (M = 4,00; SD = 2,00) nie różniła się istotnie od pozostałych.
Jak policzyć ANOVA w R?
punkty <- c(1, 3, 5,  2, 4, 6,  7, 8, 9)
grupa  <- factor(rep(c("A", "B", "C"), each = 3))

# 1) „ręcznie”, dokładnie według wzoru
srednie <- tapply(punkty, grupa, mean)                # 3, 4, 8
SSB <- sum(3 * (srednie - mean(punkty))^2)            # 42
SSW <- sum((punkty - ave(punkty, grupa))^2)           # 18
F <- (SSB / 2) / (SSW / 6)
c(F = F, p = pf(F, 2, 6, lower.tail = FALSE), eta2 = SSB / (SSB + SSW))

# 2) gotowymi funkcjami: tabela ANOVA i test post hoc Tukeya
model <- aov(punkty ~ grupa)
summary(model)
TukeyHSD(model)
Wynik w konsoli R:
    F     p  eta2
7.000 0.027 0.700
            Df Sum Sq Mean Sq F value Pr(>F)
grupa        2     42      21       7  0.027 *
Residuals    6     18       3
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
  Tukey multiple comparisons of means
    95% family-wise confidence level

Fit: aov(formula = punkty ~ grupa)

$grupa
    diff        lwr      upr     p adj
B-A    1 -3.3391953 5.339195 0.7684325
C-A    5  0.6608047 9.339195 0.0284838
C-B    4 -0.3391953 8.339195 0.0673680
Gdy wariancje w grupach wyraźnie się różnią, zamiast aov() użyj oneway.test(punkty ~ grupa) – to ANOVA Welcha.
Dlaczego nie zrobić po prostu kilku testów t?
Przy trzech grupach potrzebowałbyś trzech testów t. Każdy ma 5% ryzyka fałszywego alarmu, więc szansa, że co najmniej jeden „wykryje” nieistniejącą różnicę, rośnie do około 1 − 0,95³ ≈ 14%. ANOVA sprawdza wszystkie średnie jednym testem, a rozrzut szacuje na podstawie wszystkich dziewięciu osób. Pary porównaj dopiero potem, testem post hoc kontrolującym błąd, np. Tukeya albo z poprawką Bonferroniego.
Najczęstsze błędy
- Seria testów t bez żadnej korekty zamiast ANOVA i testu post hoc.
- Wniosek „wszystkie grupy się różnią” na podstawie samego istotnego F.
- Sprawdzanie normalności na wszystkich wynikach razem zamiast osobno w grupach lub na resztach.
- Pisanie „przyjęto H0”, gdy p > 0,05. Poprawnie: „brak podstaw do odrzucenia H0” – brak istotności nie dowodzi równości średnich.
- Podawanie samego F i p bez średnich, odchyleń standardowych i wielkości efektu.
Bibliografia
- Fisher, R. A. (1925). Statistical methods for research workers. Oliver and Boyd.
- Welch, B. L. (1951). On the comparison of several mean values: An alternative approach. Biometrika, 38(3–4), 330–336. https://doi.org/10.1093/biomet/38.3-4.330
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Field, A., Miles, J., & Field, Z. (2012). Discovering statistics using R. SAGE.
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówEta kwadrat (η²)
- Słownik wzorówTest post hoc Tukeya
- Słownik wzorówTest Kruskala-Wallisa
- Słownik wzorówTest Levene’a
- PoradnikANOVA – przykład
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
- Przykładowy raportAnaliza wariancji
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.