

Analiza wariancji (ANOVA) – przykład krok po kroku
Jednoczynnikowa analiza wariancji porównuje średnie w trzech lub więcej grupach różnych osób. Poniżej pokazujemy test ANOVA na przykładzie: od pytania badawczego, przez założenia i test post hoc, po akapit wyników i tabelę do pracy. Pytanie z pracy dyplomowej: czy sposób powtórki materiału wiąże się z wynikiem kolokwium?
W skróciePytanie i hipotezy → statystyki opisowe → założenia → test F i eta kwadrat → test post hoc → opis w stylu APA, tabela i wykres. Skąd biorą się sumy kwadratów i statystyka F, pokazujemy ręcznie w haśle jednoczynnikowa ANOVA – wzór i przykład.
Test ANOVA – przykład: pytanie badawcze i hipotezy
Dwunastu studentów losowo przydzielono do trzech sposobów powtórki: notatki, fiszki i quizy (po 4 osoby). Po tygodniu napisali kolokwium (0–10 punktów). Mamy jeden czynnik o trzech poziomach i jedną zmienną zależną ilościową, czyli sytuację dla jednoczynnikowej ANOVA.
- H0: średnie w populacji są równe (\(\mu_N = \mu_F = \mu_Q\));
- H1: co najmniej jedna średnia różni się od pozostałych; poziom istotności α = 0,05.
Dane i statystyki opisowe
| Sposób powtórki | Wyniki 4 osób | M | SD |
|---|---|---|---|
| Notatki | 3, 4, 4, 5 | 4,00 | 0,82 |
| Fiszki | 4, 6, 7, 7 | 6,00 | 1,41 |
| Quizy | 6, 7, 9, 10 | 8,00 | 1,83 |
Średnie rosną od notatek do quizów. Rośnie też rozrzut: w grupie Quizy SD jest ponad dwa razy większe niż w grupie Notatki.
Sprawdzenie założeń
- Niezależność obserwacji: każda osoba należy do jednej grupy i pisała kolokwium raz.
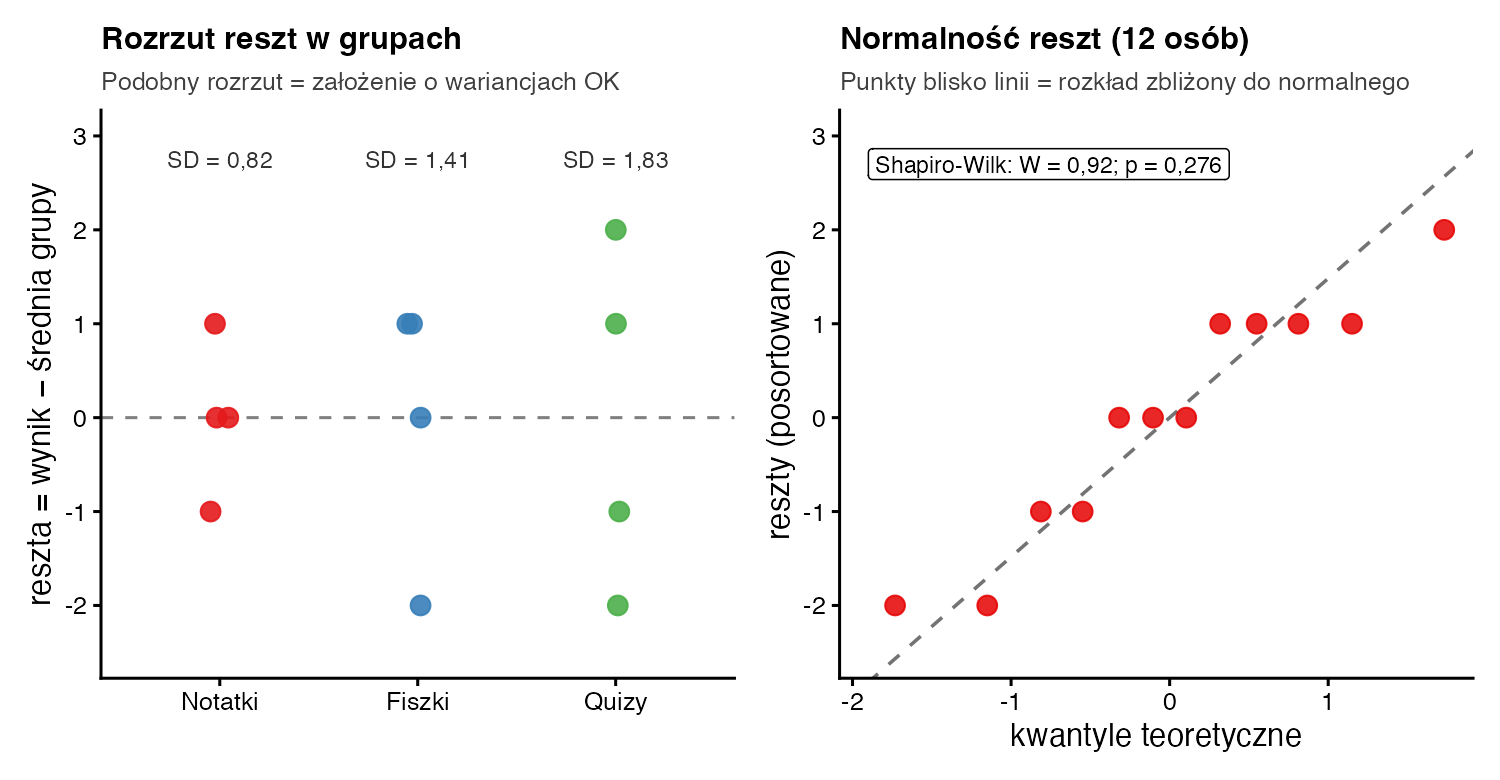
- Normalność reszt. Przy 4 osobach w grupie test normalności w każdej grupie osobno niewiele powie. Sprawdzamy więc reszty modelu, czyli różnice między wynikiem a średnią grupy: Shapiro-Wilk W = 0,92; p = 0,276.
- Równość wariancji. Test Levene’a: F(2, 9) = 2,25; p = 0,161. Nie ma podstaw, by odrzucić założenie o równych wariancjach, ale przy 4 osobach w grupie test ma małą moc.
Wynik testu F i eta kwadrat
| Źródło zmienności | SS | df | MS | F | p | η² |
|---|---|---|---|---|---|---|
| Sposób powtórki | 32 | 2 | 16 | 8,00 | 0,010 | 0,64 |
| Wewnątrz grup | 18 | 9 | 2 | |||
| Razem | 50 | 11 |
- Test F: F = 16 / 2 = 8,00 przy df = 2 i 9; p = 0,010. Odrzucamy H0: co najmniej jedna średnia różni się od pozostałych.
- Wielkość efektu: eta kwadrat η² = 32 / 50 = 0,64. Sposób powtórki wyjaśnia 64% zmienności punktów, a według konwencji Cohena (1988) próg efektu dużego to 0,14. W tak małej próbie η² zawyża efekt; mniej obciążona omega kwadrat wynosi 0,54 (Lakens, 2013).
- Co dalej: istotne F nie mówi, które grupy się różnią. To pokazuje dopiero test post hoc.
Test post hoc Tukeya – które grupy się różnią?
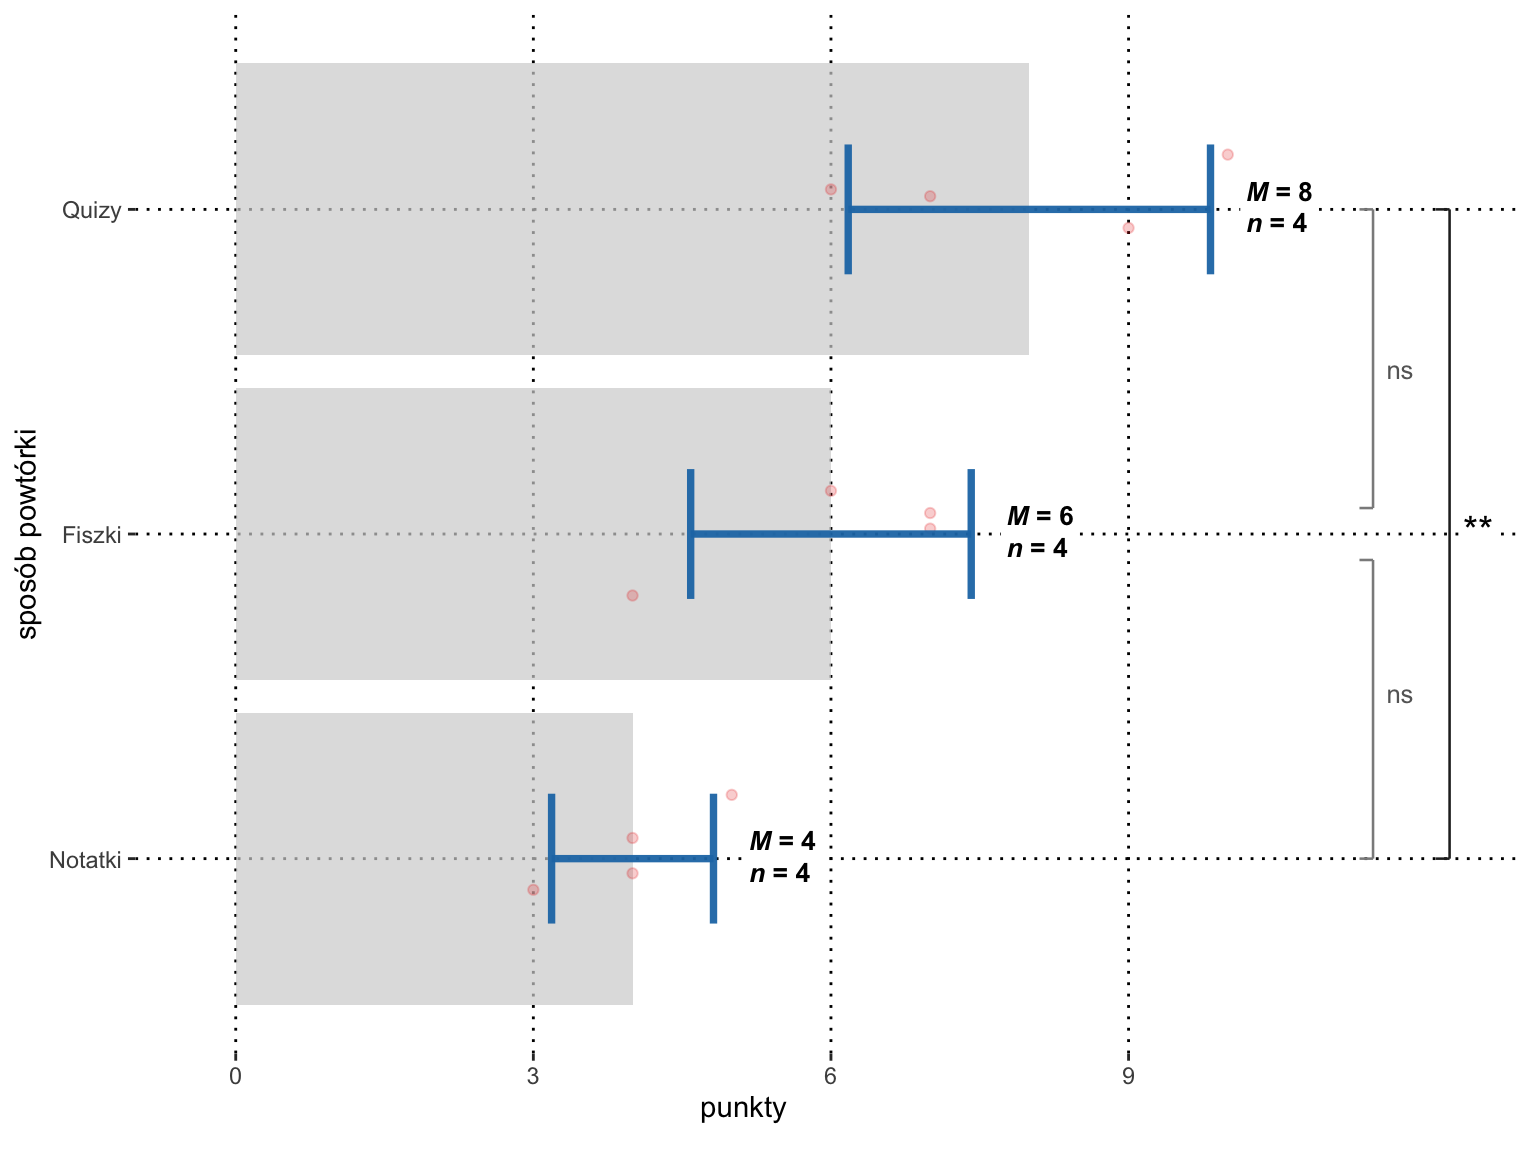
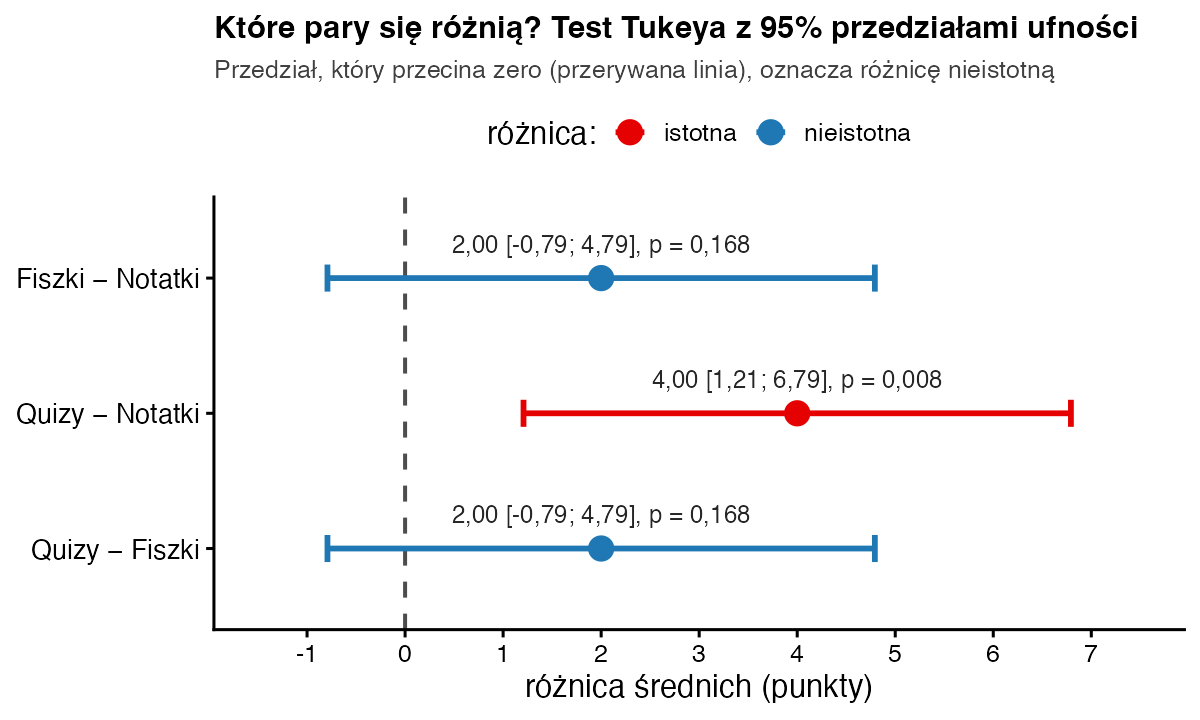
Test Tukeya porównuje wszystkie pary i kontroluje ryzyko fałszywego alarmu dla całej serii. Quizy wypadły o 4 punkty lepiej niż notatki (p = 0,008). Fiszki różnią się od obu pozostałych grup o 2 punkty, ale te różnice nie są istotne (p = 0,168) – przy 4 osobach w grupie test ma za małą moc, by rozstrzygnąć, czy te różnice są realne.
Jak opisać wynik w pracy?
Zapis w stylu APA: Sposób powtórki istotnie różnicował liczbę punktów z kolokwium, F(2, 9) = 8,00; p = 0,010; η² = 0,64. Test post hoc Tukeya wykazał, że studenci powtarzający materiał z quizów (M = 8,00; SD = 1,83) uzyskali więcej punktów niż studenci uczący się z notatek (M = 4,00; SD = 0,82), p = 0,008. Grupa Fiszki (M = 6,00; SD = 1,41) nie różniła się istotnie od pozostałych (p = 0,168).
W podpisie rysunku wyjaśnij, co oznaczają słupki, wąsy, kropki i klamry, a w tekście odwołaj się do niego jednym zdaniem. Tabelę ANOVA możesz przenieść do aneksu, jeśli promotor woli krótszy rozdział wyników. Pełny raport z takiej analizy zobaczysz w przykładowym raporcie SZTOS z analizy wariancji.
Cała analiza w R
options(show.signif.stars = FALSE)
# Dane: punkty z kolokwium (0–10), po 4 osoby w grupie
punkty <- c(3, 4, 4, 5,  4, 6, 7, 7,  6, 7, 9, 10)
sposob <- factor(rep(c("Notatki", "Fiszki", "Quizy"), each = 4),
                 levels = c("Notatki", "Fiszki", "Quizy"))

# 1) statystyki opisowe w grupach
aggregate(punkty ~ sposob, FUN = function(x) round(c(M = mean(x), SD = sd(x)), 2))

# 2) model i założenia: normalność reszt i równość wariancji
model <- aov(punkty ~ sposob)
shapiro.test(residuals(model))$p.value
car::leveneTest(punkty ~ sposob, center = mean)

# 3) test F (tabela ANOVA) i eta kwadrat
summary(model)
effectsize::eta_squared(model, partial = FALSE, ci = NULL)

# 4) test post hoc Tukeya
TukeyHSD(model)

# 5) przy różnych wariancjach: ANOVA Welcha
oneway.test(punkty ~ sposob)
Wynik w konsoli R:
   sposob punkty.M punkty.SD
1 Notatki     4.00      0.82
2  Fiszki     6.00      1.41
3   Quizy     8.00      1.83
[1] 0.2759076
Levene's Test for Homogeneity of Variance (center = mean)
      Df F value Pr(>F)
group  2    2.25 0.1613
       9
            Df Sum Sq Mean Sq F value Pr(>F)
sposob       2     32      16       8 0.0101
Residuals    9     18       2
# Effect Size for ANOVA (Type I)

Parameter | Eta2
----------------
sposob    | 0.64
  Tukey multiple comparisons of means
    95% family-wise confidence level

Fit: aov(formula = punkty ~ sposob)

$sposob
               diff        lwr      upr     p adj
Fiszki-Notatki    2 -0.7920056 4.792006 0.1678128
Quizy-Notatki     4  1.2079944 6.792006 0.0078617
Quizy-Fiszki      2 -0.7920056 4.792006 0.1678128

	One-way analysis of means (not assuming equal variances)

data:  punkty and sposob
F = 8.3543, num df = 2.0000, denom df = 5.3706, p-value =
0.02246
Co zrobić, gdy założenia nie są spełnione?
Gdy wariancje wyraźnie się różnią, zwłaszcza przy nierównych grupach, raportuj ANOVA Welcha, a pary porównuj testem Gamesa-Howella. Na naszych danych: F(2; 5,37) = 8,35; p = 0,022. Gdy rozkłady są mocno skośne, mają wartości odstające albo dane są porządkowe, wybierz test Kruskala-Wallisa: tutaj H(2) = 7,04; p = 0,030. Wszystkie trzy podejścia prowadzą do tego samego wniosku. Jak wygląda opis testu Kruskala-Wallisa w raporcie, zobaczysz w przykładowym raporcie SZTOS.
Pytania promotora i recenzenta
Dlaczego nie zrobić po prostu trzech testów t?
Przy trzech testach na poziomie 0,05 ryzyko, że co najmniej jeden da fałszywy alarm, rośnie do około 14%. ANOVA sprawdza wszystkie średnie jednym testem, a test post hoc kontroluje ryzyko dla całej serii porównań. Porównanie dwóch grup opisujemy we wpisie test t Studenta – przykład.
F jest istotne, a różni się tylko jedna para. Czy to błąd?
Nie. Test F odpowiada na pytanie, czy średnie w ogóle się różnią. Tutaj różnią się grupy skrajne, a grupa środkowa nie odstaje istotnie od żadnej z nich.
Czy 4 osoby w grupie wystarczą?
Do ilustracji tak, do pracy raczej nie. Przy tak małych grupach test ma małą moc, a przedziały ufności są bardzo szerokie. Liczebność zaplanuj przed badaniem i zawsze podawaj wielkość efektu.
Bibliografia
- Fisher, R. A. (1925). Statistical methods for research workers. Oliver and Boyd.
- Tukey, J. W. (1949). Comparing individual means in the analysis of variance. Biometrics, 5(2), 99–114. https://doi.org/10.2307/3001913
- Welch, B. L. (1951). On the comparison of several mean values: An alternative approach. Biometrika, 38(3–4), 330–336. https://doi.org/10.1093/biomet/38.3-4.330
- Kruskal, W. H., & Wallis, W. A. (1952). Use of ranks in one-criterion variance analysis. Journal of the American Statistical Association, 47(260), 583–621. https://doi.org/10.1080/01621459.1952.10483441
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Lakens, D. (2013). Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs. Frontiers in Psychology, 4, 863. https://doi.org/10.3389/fpsyg.2013.00863
- Field, A., Miles, J., & Field, Z. (2012). Discovering statistics using R. SAGE.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówJednoczynnikowa ANOVA
- Słownik wzorówEta kwadrat (η²)
- Słownik wzorówTest post hoc Tukeya
- PoradnikTesty parametryczne
- PoradnikTesty nieparametryczne
- Przykładowy raportAnaliza wariancji
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.