

Kwartyle i rozstęp międzykwartylowy (IQR) – wzór i przykład
Kwartyle dzielą uporządkowane wyniki na cztery równe części: Q1 odcina najniższe 25% wyników, Q2 to mediana, a Q3 odcina najwyższe 25%. Typowe pytanie z pracy dyplomowej: ile kubków kawy pije „środkowa połowa” studentów w sesji i czy ktoś wyraźnie odstaje od reszty?
W prostych słowachUstaw wyniki w kolejce od najmniejszego do największego i podziel ją na cztery równe części. Granice tych części to kwartyle. Odległość między pierwszym a trzecim kwartylem, czyli rozstęp międzykwartylowy (IQR), mówi, jak szeroko rozkłada się środkowa połowa osób. Skrajne wyniki nie mają na nią wpływu.
Kiedy stosować kwartyle i IQR?
- opisujesz zmienną o rozkładzie skośnym albo z wartościami odstającymi – wtedy podajesz medianę i IQR zamiast średniej i SD;
- zmienna jest porządkowa, np. ocena zajęć 1–5;
- chcesz wykryć obserwacje odstające albo narysować wykres pudełkowy.
Drugi kwartyl to po prostu mediana. Gdy rozkład jest symetryczny, rozrzut zwykle opisuje się odchyleniem standardowym. Czy rozkład jest skośny, sprawdzisz w haśle o skośności.
Wzór na kwartyle i IQR
- \(\text{poz}(Q_p)\)
- numer miejsca kwartyla w uporządkowanej kolejce – to pozycja, a nie wartość
- \(p\)
- 0,25 dla Q1, 0,5 dla Q2 (mediany), 0,75 dla Q3
- \(n\)
- liczba wyników
- \(Q_1,\ Q_3\)
- wyniki stojące na tych pozycjach; przy pozycji niecałkowitej (np. 1,5) bierzesz wartość pośrednią między sąsiednimi wynikami
- \(IQR\)
- rozstęp międzykwartylowy, czyli szerokość środkowej połowy wyników
- \(1{,}5 \cdot IQR\)
- odległość „płotów” od pudełka; wyniki poza płotami to obserwacje odstające według reguły Tukeya (1977)
Przykład krok po kroku
Siedmioro studentów zapisało, ile kubków kawy wypiło w tygodniu sesji: 1, 2, 2, 4, 6, 6, 21. To te same dane co w haśle o medianie.
| Pozycja | 1 | 2 | 3 | 4 | 5 | 6 | 7 |
|---|---|---|---|---|---|---|---|
| Kubki kawy | 1 | 2 | 2 | 4 | 6 | 6 | 21 |
| Kwartyl | – | Q1 | – | Me | – | Q3 | – |
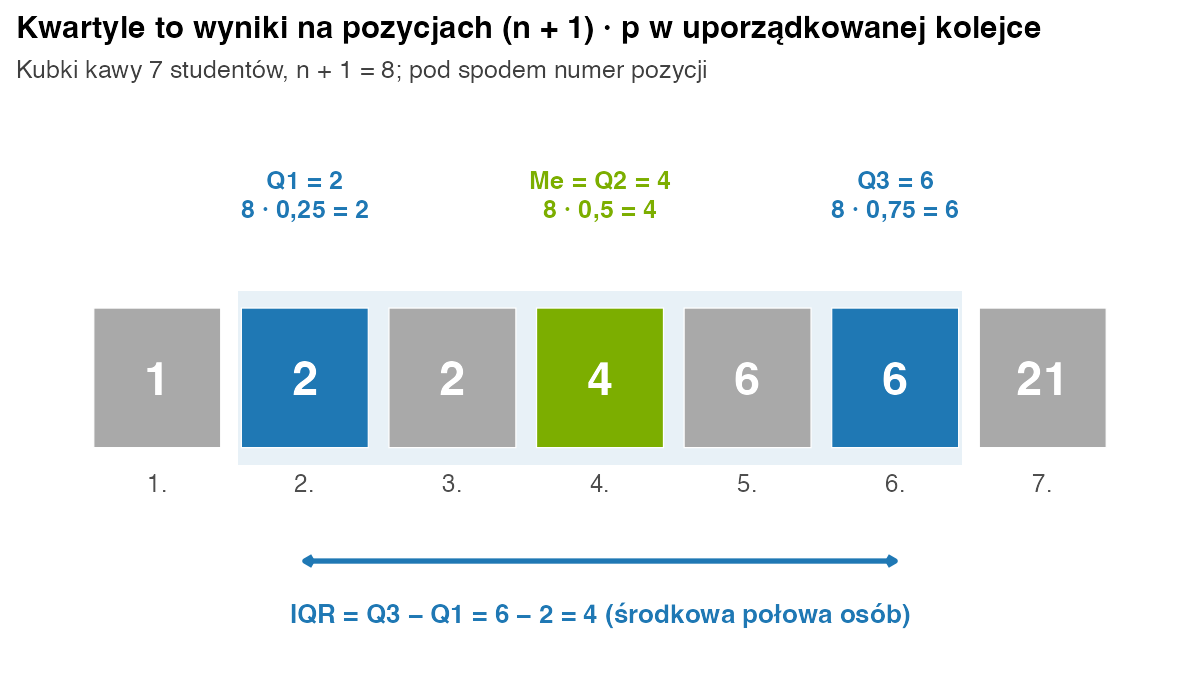
- Uporządkuj. Dane są już posortowane. n = 7, więc n + 1 = 8.
- Pozycje. Q1: 8 · 0,25 = 2. Me: 8 · 0,5 = 4. Q3: 8 · 0,75 = 6.
- Wartości. Na 2. miejscu stoi 2, na 4. – 4, na 6. – 6. Zatem Q1 = 2, Me = 4, Q3 = 6. Uwaga: tutaj pozycje i wartości przypadkiem się pokrywają. W innych danych tak nie będzie.
- IQR. 6 − 2 = 4 kubki. Środkowa połowa studentów pije od 2 do 6 kubków.
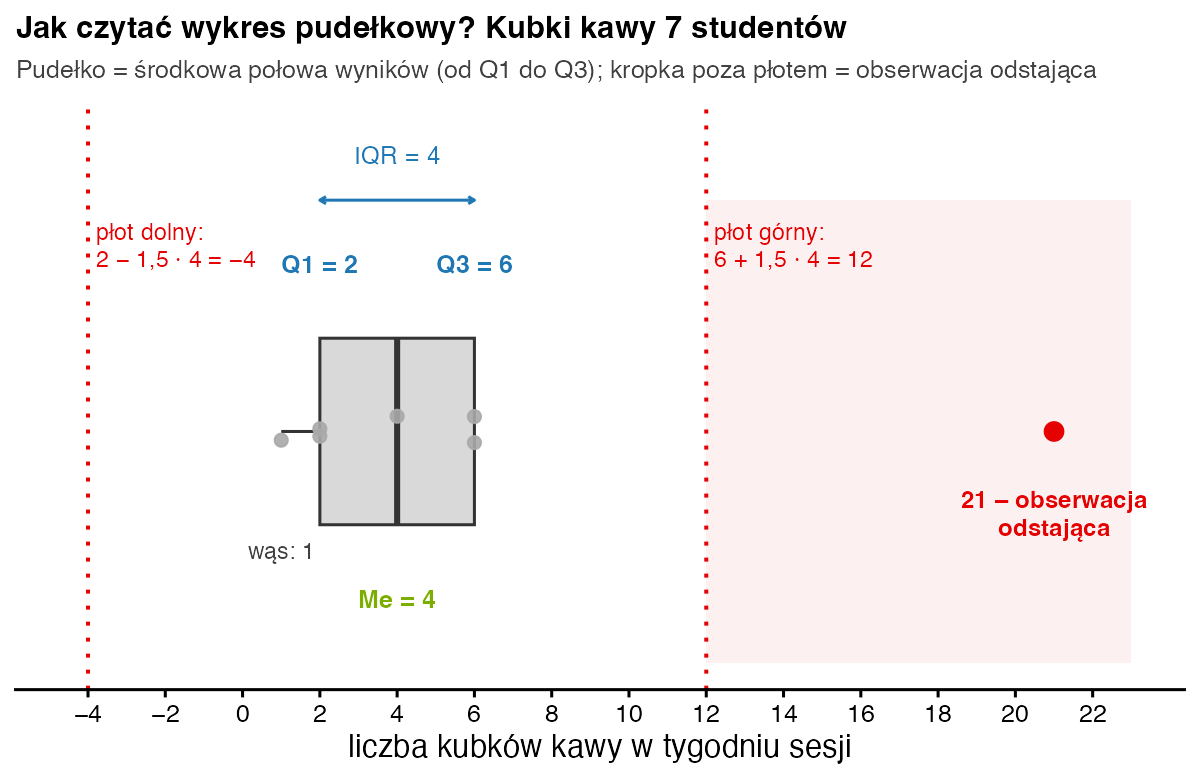
- Płoty Tukeya. Dolny: 2 − 1,5 · 4 = −4. Górny: 6 + 1,5 · 4 = 12. Wynik 21 jest powyżej 12, więc to obserwacja odstająca.
Programy liczą kwartyle różnymi metodami (Hyndman i Fan, 1996). Dla tych danych R, Excel i SPSS zgadzają się, ale nie zawsze tak jest.
Jak zinterpretować i opisać wynik?
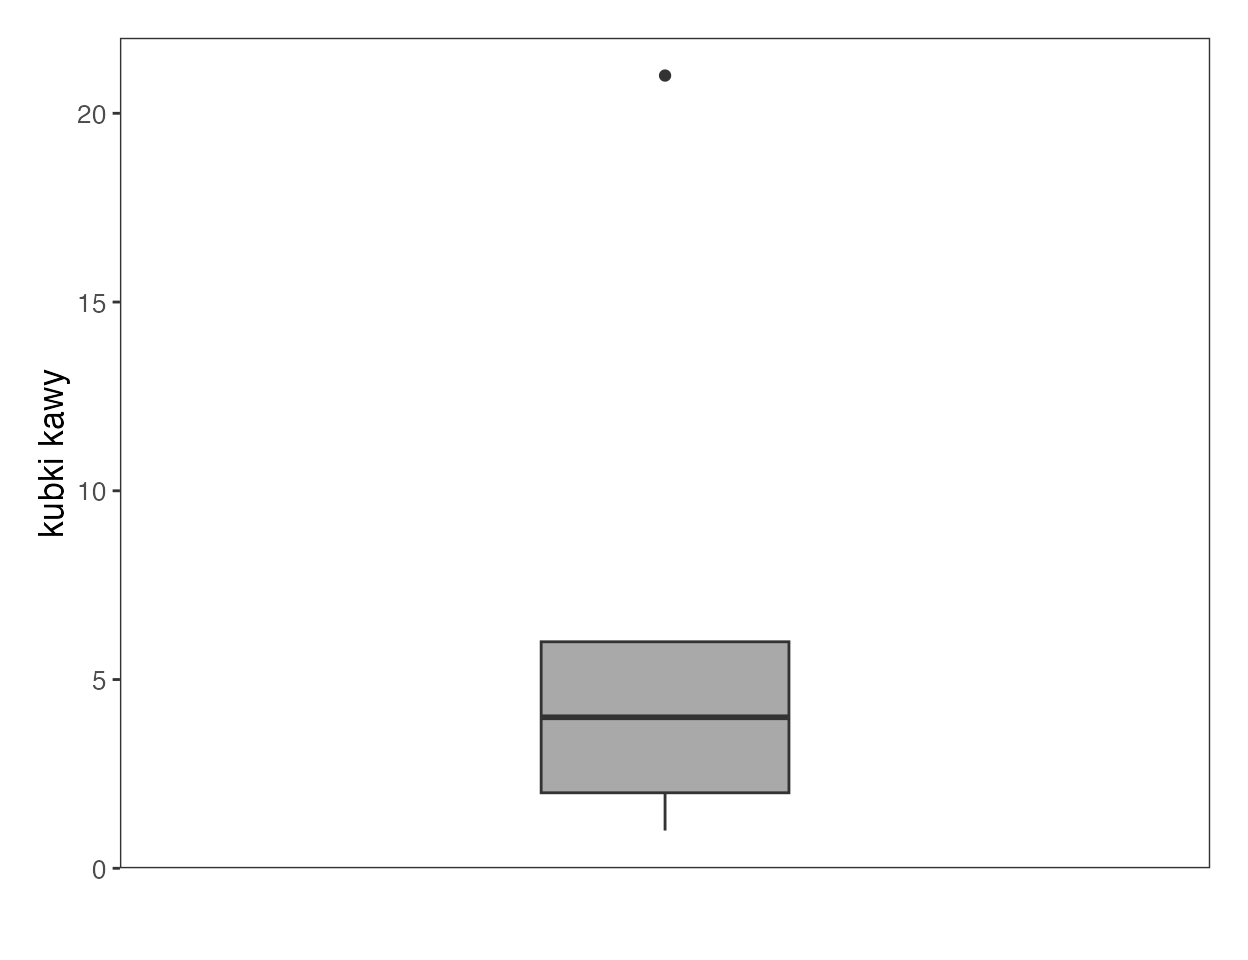
Typowy student pije w sesji 4 kubki kawy tygodniowo, a połowa studentów mieści się między 2 a 6 kubkami. Osoba z 21 kubkami wyraźnie odstaje. Reguła Tukeya tylko wskazuje ją do sprawdzenia – nie każe jej usuwać. Zapis „Me (IQR)” to standard przy testach nieparametrycznych, np. teście U Manna-Whitneya.
Zapis w stylu APA: Studenci wypijali w tygodniu sesji od 1 do 21 kubków kawy (Me = 4; Q1 = 2; Q3 = 6; IQR = 4). Jedna osoba (21 kubków) była obserwacją odstającą według reguły 1,5 · IQR (Tukey, 1977).
Jak policzyć kwartyle w R?
kawa <- c(1, 2, 2, 4, 6, 6, 21)

# 1) „ręcznie”: pozycje (n + 1) · p w uporządkowanych danych
x <- sort(kawa); n <- length(x)
(n + 1) * c(0.25, 0.5, 0.75)                     # pozycje: 2 4 6
x[(n + 1) * c(0.25, 0.5, 0.75)]                  # Q1, Me, Q3: 2 4 6

# 2) gotowymi funkcjami: type = 7 to domyślna metoda R i Excela, type = 6 – SPSS
quantile(kawa, c(0.25, 0.5, 0.75), type = 7)
quantile(kawa, c(0.25, 0.5, 0.75), type = 6)
IQR(kawa)
boxplot.stats(kawa)$out                          # wyniki poza płotami Tukeya

# 3) sen z hasła o średniej: przy n = 5 metody dają różne kwartyle
sen <- c(6, 2, 7, 4, 6)
rbind(R_Excel = quantile(sen, c(0.25, 0.75), type = 7),
      SPSS    = quantile(sen, c(0.25, 0.75), type = 6))
Wynik w konsoli R:
[1] 2 4 6
[1] 2 4 6
25% 50% 75%
  2   4   6
25% 50% 75%
  2   4   6
[1] 4
[1] 21
        25% 75%
R_Excel   4 6.0
SPSS      3 6.5
Funkcja boxplot.stats() wypisuje wyniki leżące poza płotami Tukeya.
Dlaczego Excel, SPSS i R dają różne kwartyle?
Bo nie ma jednej definicji kwartyla. Hyndman i Fan (1996) opisali dziewięć metod, które inaczej traktują pozycje niecałkowite. R i funkcja QUARTILE.INC w Excelu domyślnie liczą metodą nr 7, a SPSS – metodą nr 6, czyli wzorem (n + 1) · p z tej strony. Dla wyników snu z hasła o średniej (2, 4, 6, 6, 7) R podaje Q1 = 4 i Q3 = 6, a SPSS Q1 = 3 i Q3 = 6,5. Przy dużych próbach różnice są zwykle niewielkie. W pracy napisz, w jakim programie liczyłeś kwartyle.
Najczęstsze błędy
- Mylenie pozycji z wartością. W danych o kawie oba przypadkiem wynoszą 2, 4 i 6, ale dla snu (2, 4, 6, 6, 7) pozycja Q1 to (5 + 1) · 0,25 = 1,5, a Q1 = 3, czyli połowa drogi między 2 a 4.
- Liczenie kwartyli z nieposortowanych danych.
- Mylenie IQR z odchyleniem ćwiartkowym, czyli połową IQR (tu 4 / 2 = 2) – napisz, którą miarę podajesz.
- Automatyczne usuwanie obserwacji spoza płotów bez sprawdzenia, skąd się wzięły.
- Porównywanie kwartyli z różnych programów przy małych próbach bez podania metody.
Bibliografia
- Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.
- Hyndman, R. J., & Fan, Y. (1996). Sample quantiles in statistical packages. The American Statistician, 50(4), 361–365. https://doi.org/10.1080/00031305.1996.10473566
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówMediana
- Słownik wzorówOdchylenie standardowe
- Słownik wzorówSkośność
- PoradnikStatystyka opisowa – przykład
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
- Przykładowy raportOpis próby
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.