

Skośność rozkładu – wzór, interpretacja i przykład
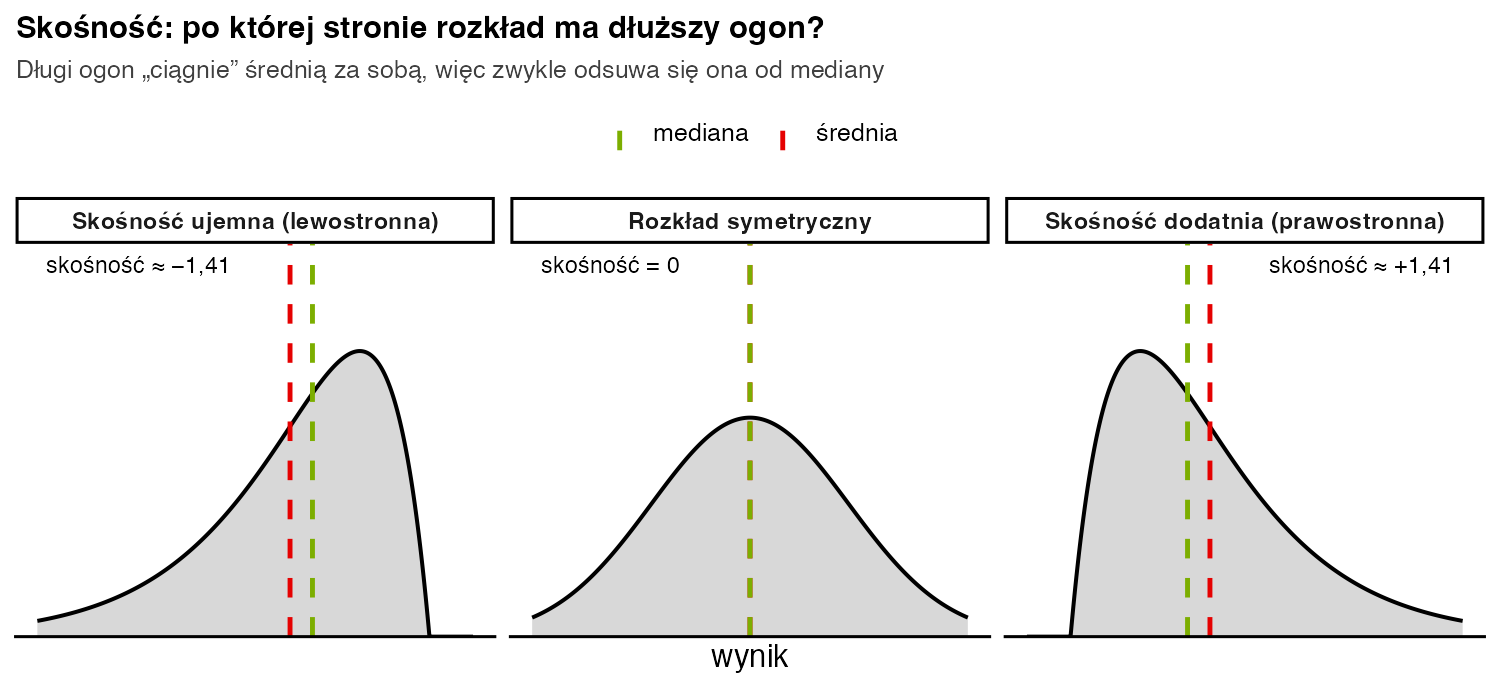
Skośność mówi, czy rozkład wyników jest symetryczny, czy ma dłuższy „ogon” po jednej stronie. Typowe pytanie z pracy dyplomowej: czy czas snu przed kolokwium rozkłada się symetrycznie, czy kilka osób, które prawie nie spały, „ciągnie” średnią w dół?
W prostych słowachGdy pojedyncze wyniki odstają daleko w jedną stronę, rozkład ma po tej stronie długi ogon. Skośność ujemna to długi ogon po lewej (kilka bardzo niskich wyników), dodatnia – po prawej (kilka bardzo wysokich). Wynik bliski zera oznacza rozkład (prawie) symetryczny, taki jak rozkład normalny.
Kiedy liczyć skośność?
- opisujesz zmienną ilościową w tabeli statystyk opisowych (obok średniej, SD i mediany);
- sprawdzasz, czy rozkład jest zbliżony do normalnego, zanim wybierzesz test t albo ANOVA;
- decydujesz, czy lepiej podać średnią, czy medianę – przy silnej skośności mediana lepiej opisuje typowy wynik.
Skośność czytaj zawsze razem z kurtozą, histogramem i testem Shapiro-Wilka. Gdy rozkład jest wyraźnie skośny, a grupy są małe, rozważ test U Manna-Whitneya zamiast testu t.
Prawostronnie skośne bywają czasy reakcji, dochody i liczba kaw wypitych w sesji – większość osób ma niskie wyniki, a nieliczne bardzo wysokie. Lewostronnie skośne są często wyniki łatwych kolokwiów i oceny zadowolenia z zajęć, gdy prawie wszyscy wybierają najwyższe odpowiedzi.
Wzór na skośność
- \(x_i,\ \bar{x}\)
- wynik i-tej osoby i średnia wszystkich wyników
- \(s\)
- odchylenie standardowe z próby (dzielone przez n − 1)
- \((x_i - \bar{x})/s\)
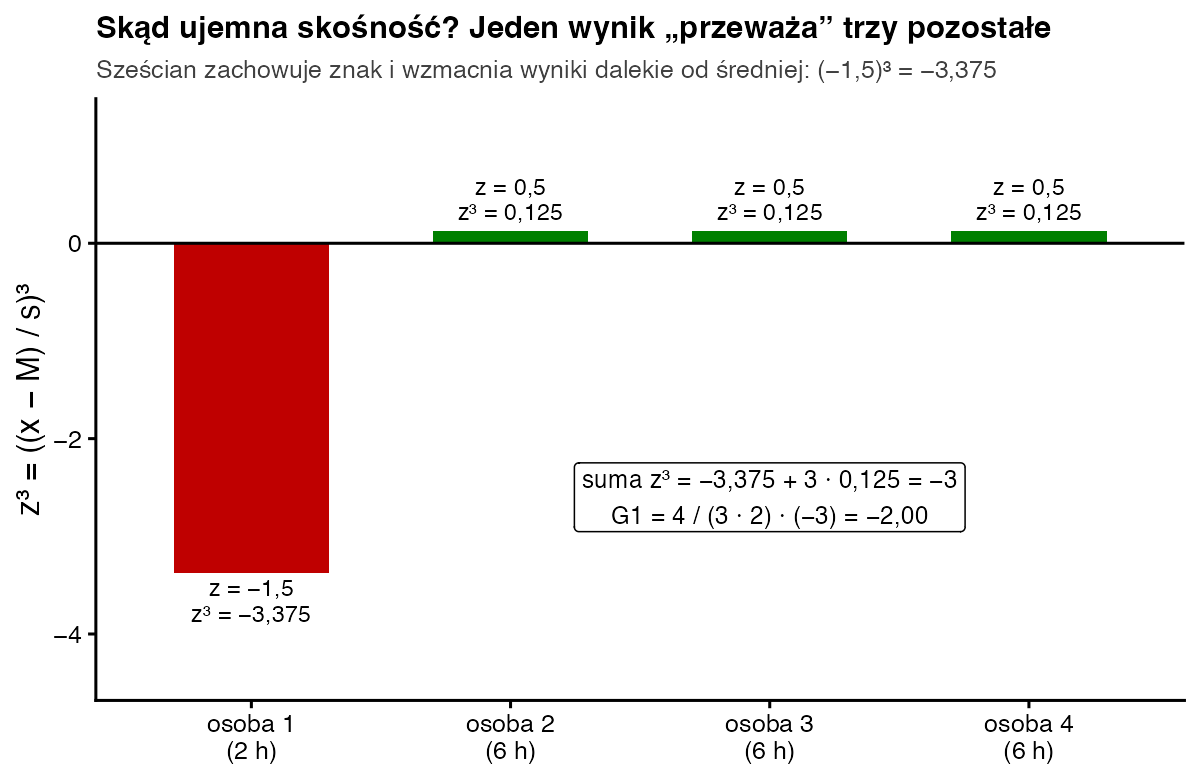
- wynik standaryzowany z; podniesiony do sześcianu zachowuje znak i mocno wzmacnia wyniki dalekie od średniej
- \(\frac{n}{(n-1)(n-2)}\)
- poprawka na małą próbę
- \(SE_{G_1}\)
- błąd standardowy skośności – zależy tylko od n
To wersja G1 – liczą ją SPSS, Excel (funkcja SKOŚNOŚĆ) i aplikacja SZTOS. Inne programy mogą podawać wersję bez poprawki, więc wyniki się różnią (Joanes i Gill, 1998).
Przykład krok po kroku
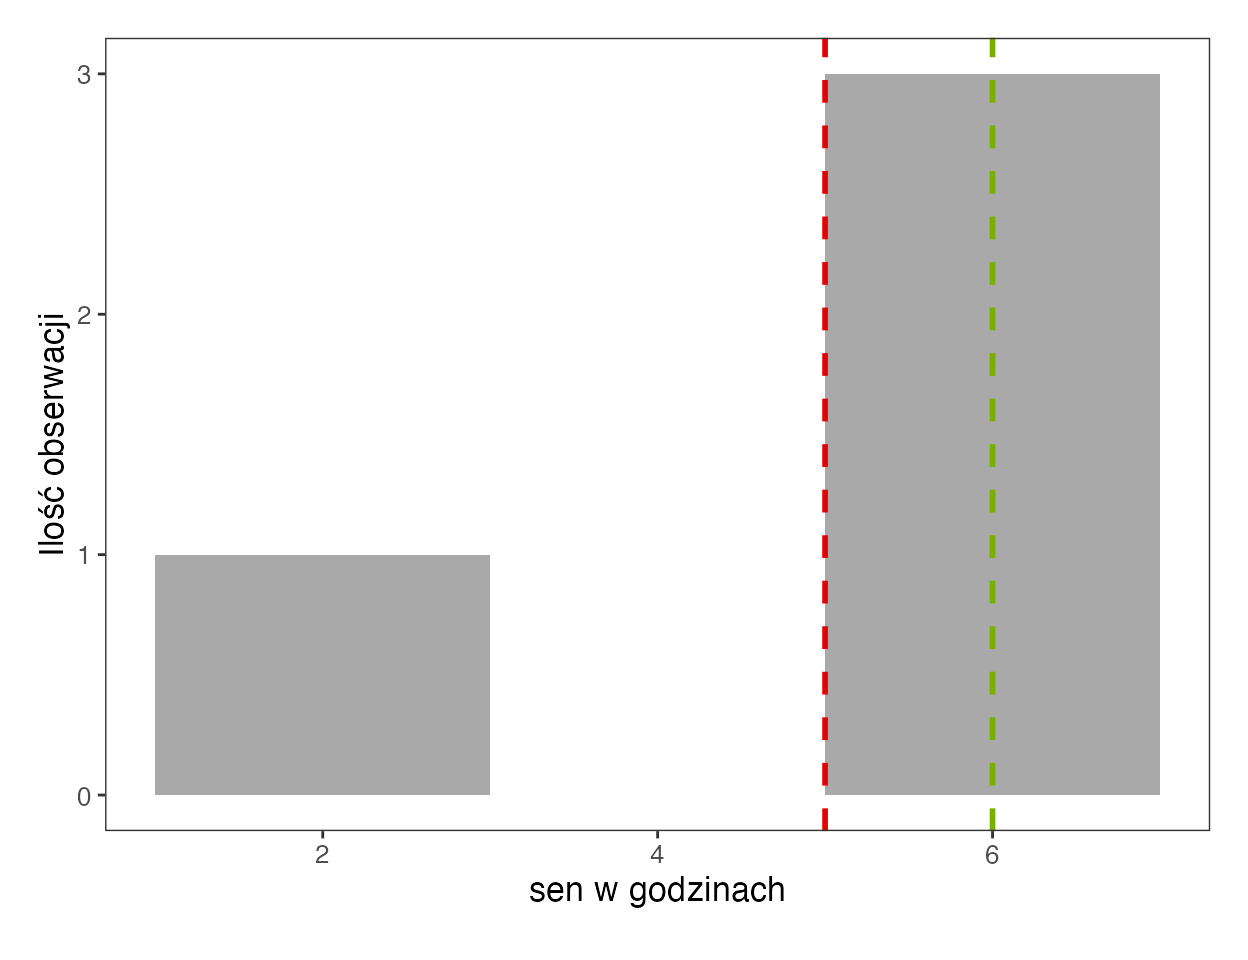
Czworo studentów zapisało, ile spało przed kolokwium: 2, 6, 6 i 6 godzin.
| Sen x | x − 5 | z = (x − 5) / 2 | z³ |
|---|---|---|---|
| 2 | −3 | −1,5 | −3,375 |
| 6 | 1 | 0,5 | 0,125 |
| 6 | 1 | 0,5 | 0,125 |
| 6 | 1 | 0,5 | 0,125 |
| Σ = 20 | 0 | 0 | −3,000 |
- Średnia i SD. M = 20 / 4 = 5 h. Suma kwadratów odchyleń: 9 + 1 + 1 + 1 = 12, więc s² = 12 / 3 = 4 i s = 2.
- Wyniki z. Dzielimy odchylenia przez 2: −1,5 oraz trzy razy 0,5.
- Sześciany. (−1,5)³ = −3,375, a 0,5³ = 0,125. Suma: −3,375 + 3 · 0,125 = −3.
- Poprawka. n / ((n − 1)(n − 2)) = 4 / (3 · 2) = 0,667. G1 = 0,667 · (−3) = −2,00.
- Błąd standardowy. SE = √(6 · 4 · 3 / (2 · 5 · 7)) = √(72 / 70) = 1,01, a z = −2,00 / 1,01 = −1,97.
Jak zinterpretować i opisać wynik?
G1 = −2,00 oznacza silną skośność ujemną: lewy ogon tworzy jedna osoba, która spała 2 h. Widać to też po tym, że średnia jest mniejsza od mediany, choć ta wskazówka nie zawsze działa (von Hippel, 2005). Kiedy skośność jest „duża”? Kim (2013) proponuje: przy n < 50 porównaj z = G1 / SE z wartością ±1,96, przy 50–300 osobach z ±3,29, a w dużych próbach patrz na histogram i samą skośność (|G1| > 2 to wyraźne odejście od normalności). U nas z = −1,97 leży tuż za granicą, ale przy czterech osobach to tylko ćwiczenie rachunkowe. Pamiętaj też, że skośność opisuje kształt rozkładu – sama nie rozstrzyga, czy możesz użyć testu t.
Zapis w stylu APA: Rozkład czasu snu był lewostronnie skośny (M = 5,00; Me = 6,00; skośność = −2,00, SE skośności = 1,01), dlatego jako miarę tendencji centralnej podano medianę.
Jak policzyć skośność w R?
sen <- c(2, 6, 6, 6)
n <- length(sen)

# 1) „ręcznie”, według wzoru G1 (jak w SPSS i Excelu)
z  <- (sen - mean(sen)) / sd(sen)
G1 <- n / ((n - 1) * (n - 2)) * sum(z^3)
SE <- sqrt(6 * n * (n - 1) / ((n - 2) * (n + 1) * (n + 3)))
round(c(G1 = G1, SE = SE, z = G1 / SE), 2)

# 2) gotowymi funkcjami – zawsze sprawdź, który to wzór!
e1071::skewness(sen, type = 2)          # G1 (SPSS, Excel, SZTOS)
psych::describe(sen, type = 2)$skew     # G1
psych::describe(sen)$skew               # domyślny type = 3 – inny wzór
moments::skewness(sen)                  # g1 bez poprawki – inny wzór
Wynik w konsoli R:
   G1    SE     z
-2.00  1.01 -1.97
[1] -2
[1] -2
[1] -0.75
[1] -1.154701
Te same dane, a trzy różne liczby: −2,00, −0,75 i −1,15. To nie błąd, tylko różne wzory. Przy dużych próbach różnice znikają, ale w pracy zawsze napisz, którą wersję podajesz.
Co zrobić, gdy rozkład jest skośny?
Najpierw sprawdź, czy skrajne wyniki nie są pomyłką (np. 2 zamiast 12). Potem wybierz opis: przy silnej skośności podaj medianę i rozstęp międzykwartylowy zamiast samej średniej i SD. Do porównań grup użyj testu nieparametrycznego albo – przy dużych grupach – testu t, który jest wtedy dość odporny. Przy skośności dodatniej (np. czasy reakcji) pomaga też przekształcenie logarytmiczne.
Najczęstsze błędy
- Mylenie kierunku: skośność ujemna to długi ogon po lewej, a nie „większość wyników po lewej”.
- Porównywanie skośności z różnych programów bez sprawdzenia, którym wzorem je policzono.
- Wyciąganie wniosków ze skośności przy kilku obserwacjach – błąd standardowy jest wtedy ogromny.
- Ocenianie normalności wyłącznie na podstawie skośności, bez kurtozy i wykresu.
- Usuwanie „niewygodnych” wyników tylko po to, żeby zmniejszyć skośność.
Bibliografia
- Joanes, D. N., & Gill, C. A. (1998). Comparing measures of sample skewness and kurtosis. Journal of the Royal Statistical Society: Series D (The Statistician), 47(1), 183–189. https://doi.org/10.1111/1467-9884.00122
- Kim, H.-Y. (2013). Statistical notes for clinical researchers: Assessing normal distribution (2) using skewness and kurtosis. Restorative Dentistry & Endodontics, 38(1), 52–54. https://doi.org/10.5395/rde.2013.38.1.52
- von Hippel, P. T. (2005). Mean, median, and skew: Correcting a textbook rule. Journal of Statistics Education, 13(2).
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówKurtoza
- Słownik wzorówTest Shapiro-Wilka
- Słownik wzorówRozkład normalny
- PoradnikStatystyka opisowa – przykład
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
- Przykładowy raportOpis próby
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.