

Test U Manna-Whitneya – wzór i przykład
Test U Manna-Whitneya porównuje dwie niezależne grupy, gdy nie chcesz zakładać rozkładu normalnego – na przykład przy ocenach na skali 1–5, czasach reakcji z długim „ogonem” albo w bardzo małych grupach. Zamiast średnich porównuje rangi, czyli miejsca wyników w szeregu od najmniejszego do największego.
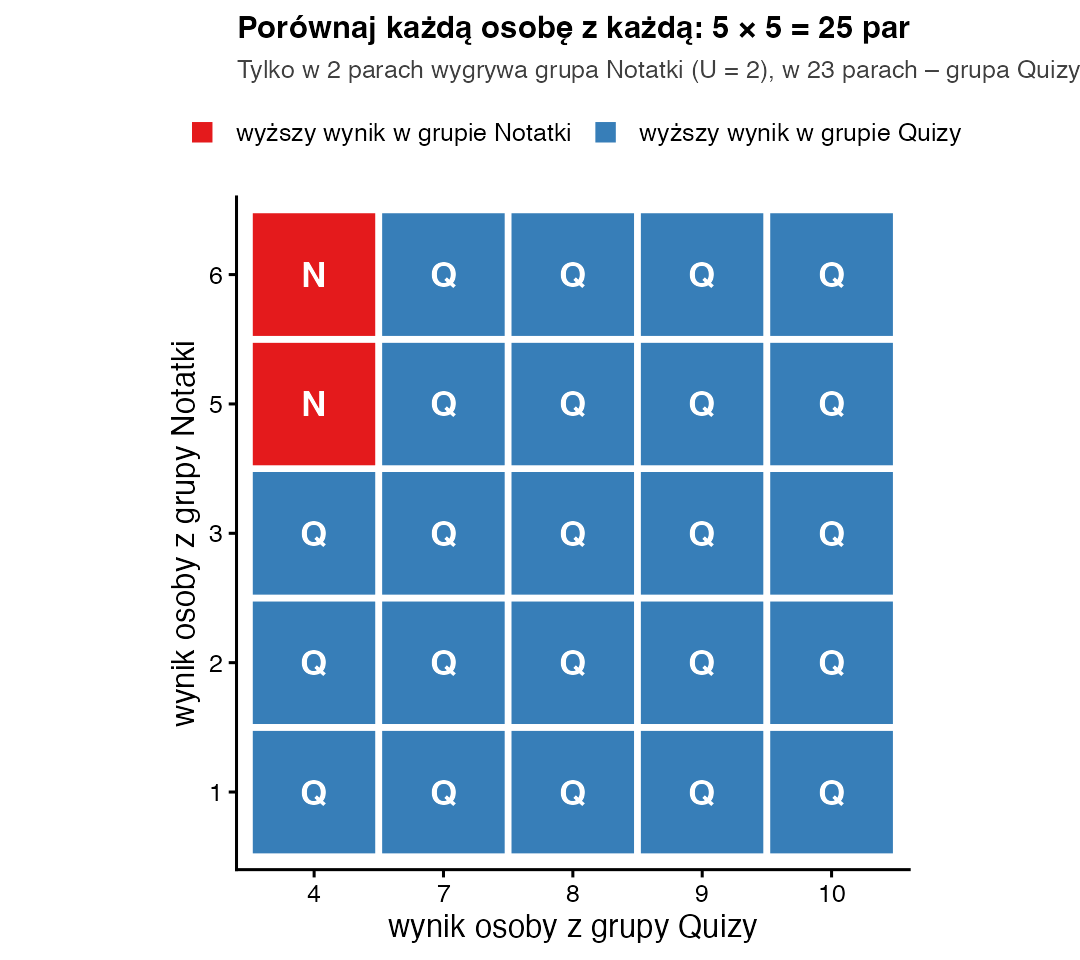
W prostych słowachWyobraź sobie, że losujesz jedną osobę z każdej grupy i sprawdzasz, która ma wyższy wynik. Test U liczy, w ilu takich parach „wygrywa” dana grupa. Jeśli jedna grupa wygrywa prawie zawsze, U jest bliskie zera, a różnica między grupami – wyraźna.
Kiedy stosować test U Manna-Whitneya?
- porównujesz dwie grupy różnych osób;
- zmienna jest co najmniej porządkowa (da się ustawić wyniki od najmniejszego do największego);
- rozkład wyników jest wyraźnie skośny, ma obserwacje odstające albo grupy są bardzo małe – wtedy jest bezpieczniejszą alternatywą dla testu t Studenta.
Gdy te same osoby badasz dwa razy, użyj testu Wilcoxona. Przy trzech i więcej grupach – testu Kruskala-Wallisa.
Wzór na statystykę U
- \(R_1\)
- suma rang osób z grupy 1 (rangi nadajesz wszystkim osobom razem)
- \(n_1,\ n_2\)
- liczba osób w grupie 1 i w grupie 2
- \(U_1\)
- liczba par, w których osoba z grupy 1 ma wyższy wynik niż osoba z grupy 2 (remis liczy się jako ½)
- \(n_1 n_2\)
- liczba wszystkich możliwych par – dlatego \(U_1 + U_2 = n_1 n_2\)
Siłę efektu najprościej opisać korelacją rangowo-dwuseryjną: \( r_{rb} = 1 - \dfrac{2U}{n_1 n_2} \). Przyjmuje wartości od 0 (brak przewagi) do 1 (jedna grupa wygrywa we wszystkich parach).
Przykład krok po kroku
Ci sami studenci co w przykładzie z testem t, tylko z innymi wynikami (wybraliśmy je tak, żeby nie było remisów). Notatki: 1, 2, 3, 5, 6 punktów. Quizy: 4, 7, 8, 9, 10 punktów.
| Wynik | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 |
|---|---|---|---|---|---|---|---|---|---|---|
| Grupa | N | N | N | Q | N | N | Q | Q | Q | Q |
| Ranga | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 |
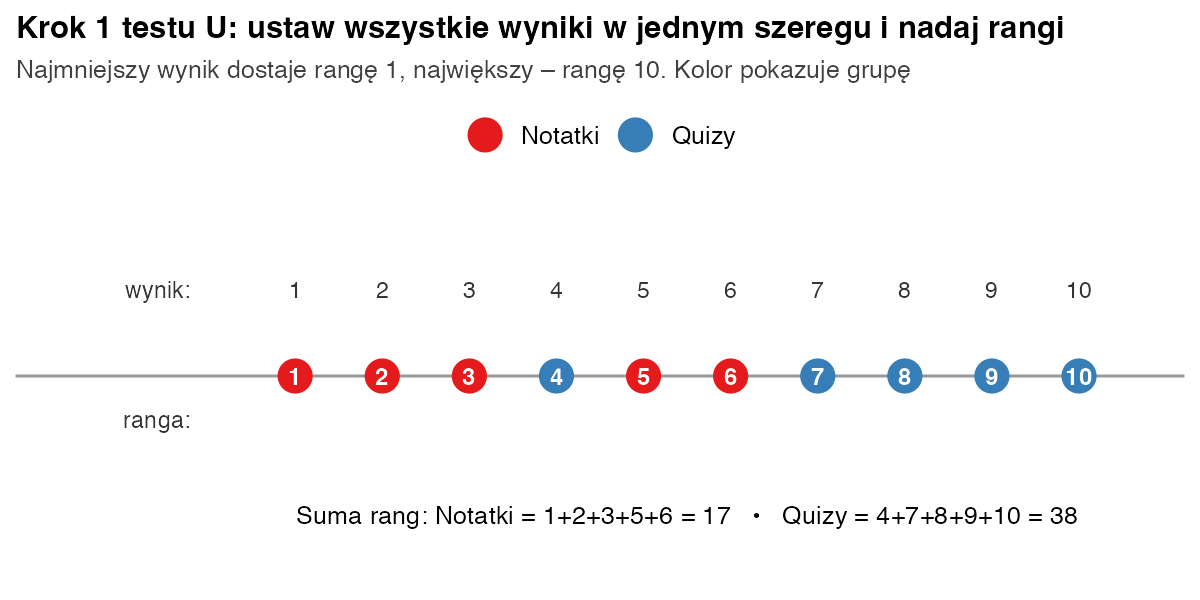
- Rangi. Ustaw wszystkie 10 wyników od najmniejszego do największego i ponumeruj je od 1 do 10 (Tabela 1).
- Sumy rang. Notatki: 1 + 2 + 3 + 5 + 6 = 17. Quizy: 4 + 7 + 8 + 9 + 10 = 38. Kontrola: 17 + 38 = 55, czyli suma liczb od 1 do 10.
- Statystyka U. \(U_N = 17 - 5 \cdot 6 / 2 = 17 - 15 = 2\), a \(U_Q = 25 - 2 = 23\). Mniejsza z nich to U = 2.
- Wartość p. Dla U = 2 i grup po 5 osób dokładna wartość p wynosi 0,032 – mniej niż 0,05.
- Wielkość efektu. \(r_{rb} = 1 - 2 \cdot 2 / 25 = 0{,}84\). Inaczej: w 23 z 25 par (92%) wyższy wynik ma osoba z grupy Quizy.
Jak zinterpretować i opisać wynik?
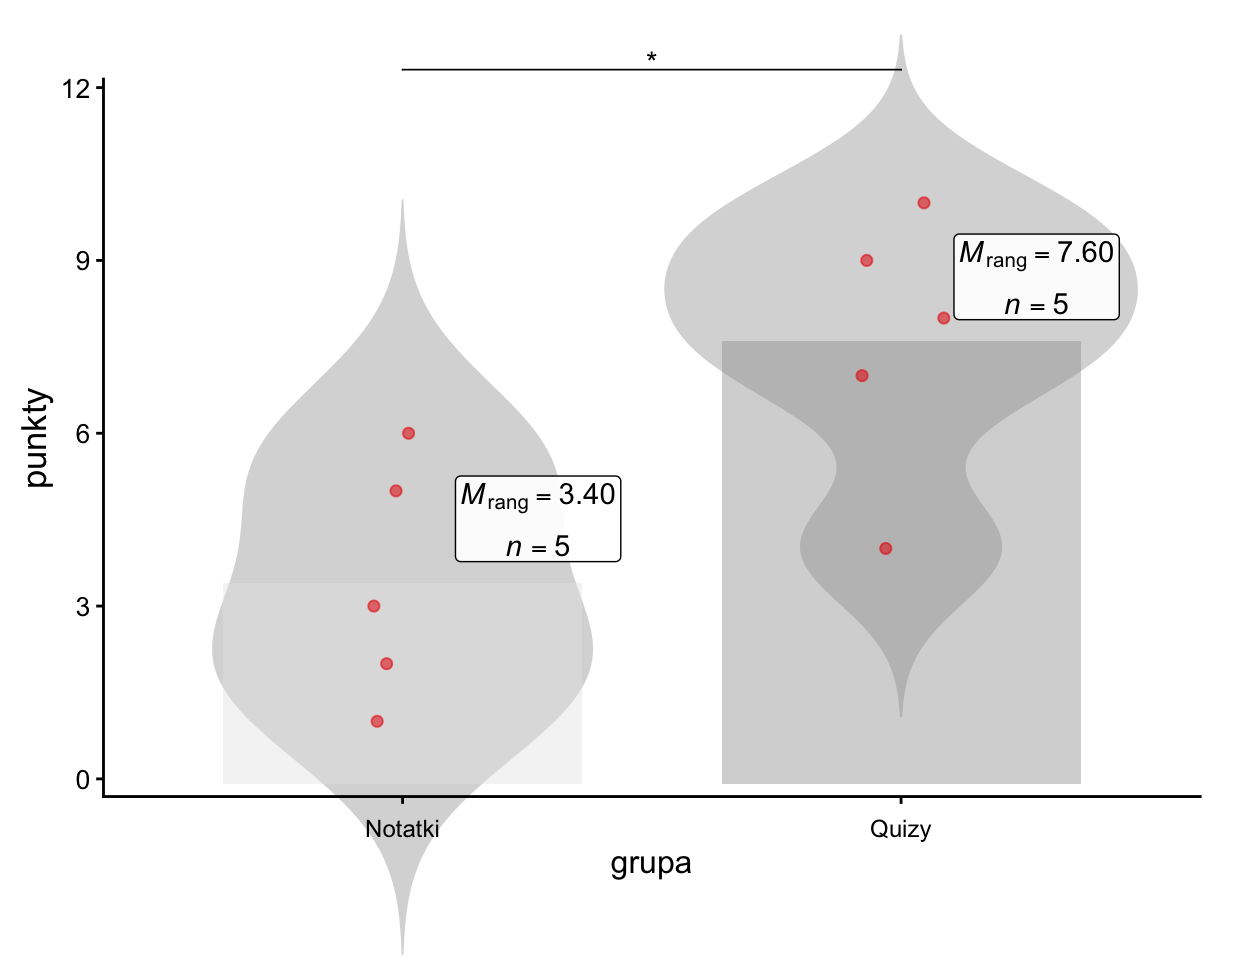
Studenci uczący się z quizów częściej mieli wyższe wyniki niż studenci uczący się z notatek. Test U nie jest jednak „testem median”. Mówi o tym, czy wyniki jednej grupy mają tendencję do bycia wyższymi. O różnicy median można mówić tylko wtedy, gdy rozkłady w obu grupach mają podobny kształt (Divine i in., 2018). W opisie podaj średnie rangi lub mediany, U, p i wielkość efektu.
Zapis w stylu APA: Studenci uczący się z quizów uzyskiwali wyższe wyniki (Mrang = 7,60; Me = 8) niż studenci uczący się z notatek (Mrang = 3,40; Me = 3), U = 2; p = 0,032; rrb = 0,84.
Przy większych grupach programy zamiast dokładnego p podają przybliżenie rozkładem normalnym (statystykę z). Dla naszych danych z = −2,19 i p = 0,028.
Jak policzyć test U w R?
notatki <- c(1, 2, 3, 5, 6)
quizy   <- c(4, 7, 8, 9, 10)

# 1) „ręcznie”: rangi, suma rang i U
rangi <- rank(c(notatki, quizy))
R1 <- sum(rangi[1:5])                 # suma rang grupy Notatki = 17
U1 <- R1 - 5 * (5 + 1) / 2            # 17 - 15 = 2
U1

# 2) gotową funkcją (R nazywa statystykę W, ale to jest U pierwszej grupy)
wilcox.test(notatki, quizy, exact = TRUE)

# 3) wielkość efektu: korelacja rangowo-dwuseryjna
effectsize::rank_biserial(quizy, notatki)
Wynik w konsoli R:
	Wilcoxon rank sum exact test

data:  notatki and quizy
W = 2, p-value = 0.03175
alternative hypothesis: true location shift is not equal to 0

r (rank biserial) |       95% CI
--------------------------------
0.84              | [0.44, 0.96]
R nazywa statystykę literą W, ale dla dwóch niezależnych grup jest to dokładnie U pierwszej grupy.
Test U czy test t – który wybrać?
Jeśli wyniki w obu grupach mają rozkład zbliżony do normalnego, test t ma nieco większą moc, czyli łatwiej wykrywa prawdziwą różnicę. Test U wygrywa, gdy rozkłady są mocno skośne, gdy pojawiają się wartości odstające albo gdy zmienna jest tylko porządkowa (np. ocena 1–5). Nie wybieraj testu dopiero po zobaczeniu, który daje „lepsze” p – zdecyduj na podstawie rodzaju danych i opisz tę decyzję w rozdziale metodologicznym.
Najczęstsze błędy
- Pisanie, że test U „porównuje mediany” – bez założenia o podobnym kształcie rozkładów to nieprawda.
- Podawanie średnich wyników zamiast średnich rang lub median.
- Użycie testu U dla tych samych osób zbadanych dwa razy – tu potrzebny jest test Wilcoxona.
- Pomijanie remisów: równe wyniki dostają średnią rangę (np. dwa wyniki na miejscach 4 i 5 dostają po 4,5), a dokładne p trzeba wtedy zastąpić przybliżeniem.
Bibliografia
- Mann, H. B., & Whitney, D. R. (1947). On a test of whether one of two random variables is stochastically larger than the other. The Annals of Mathematical Statistics, 18(1), 50–60. https://doi.org/10.1214/aoms/1177730491
- Wilcoxon, F. (1945). Individual comparisons by ranking methods. Biometrics Bulletin, 1(6), 80–83. https://doi.org/10.2307/3001968
- Divine, G. W., Norton, H. J., Barón, A. E., & Juarez-Colunga, E. (2018). The Wilcoxon–Mann–Whitney procedure fails as a test of medians. The American Statistician, 72(3), 278–286. https://doi.org/10.1080/00031305.2017.1305291
- Kerby, D. S. (2014). The simple difference formula: An approach to teaching nonparametric correlation. Comprehensive Psychology, 3, 11.IT.3.1. https://doi.org/10.2466/11.IT.3.1
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówTest t Studenta dla prób niezależnych
- Słownik wzorówTest Wilcoxona
- Słownik wzorówTest Kruskala-Wallisa
- Słownik wzorówMediana
- PoradnikTest U Manna-Whitneya – przykład
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
- Przykładowy raportTest t Studenta
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.