

Test Friedmana – wzór i przykład
Test Friedmana porównuje trzy lub więcej pomiarów u tych samych osób, gdy nie chcesz zakładać rozkładu normalnego – na przykład przy ocenach na skali 1–5 albo przy bardzo małej próbie. Typowe pytanie z pracy dyplomowej: czy samoocena wiedzy studentów zmienia się między pomiarem przed warsztatami, tuż po nich i miesiąc później?
W prostych słowachKażda osoba porównywana jest tylko sama ze sobą. U każdej ustawiasz jej pomiary od najniższego do najwyższego i nadajesz im rangi 1, 2, 3. Jeśli pomiary się nie różnią, każdy z nich powinien średnio dostawać rangę środkową. Test sprawdza, czy któryś pomiar zbyt często ląduje na górze albo na dole.
Kiedy stosować test Friedmana?
- te same osoby zmierzono trzy lub więcej razy albo każda oceniła kilka rzeczy (np. wykład, ćwiczenia i laboratorium);
- zmienna jest co najmniej porządkowa;
- rozkłady są wyraźnie nienormalne albo próba jest bardzo mała – wtedy jest bezpieczniejszą alternatywą dla ANOVA z powtarzanymi pomiarami.
Przy dwóch pomiarach użyj testu Wilcoxona. Gdy porównujesz różne osoby w trzech lub więcej grupach – testu Kruskala-Wallisa.
Wzór na statystykę testu Friedmana
- \(n\)
- liczba osób (wierszy)
- \(k\)
- liczba pomiarów (kolumn)
- \(R_j\)
- suma rang w j-tym pomiarze; rangi od 1 do k nadajesz osobno w wierszu każdej osoby
- \(\chi^2_F\)
- statystyka testu; przy większych próbach ma w przybliżeniu rozkład χ² z k − 1 stopniami swobody
- \(W\)
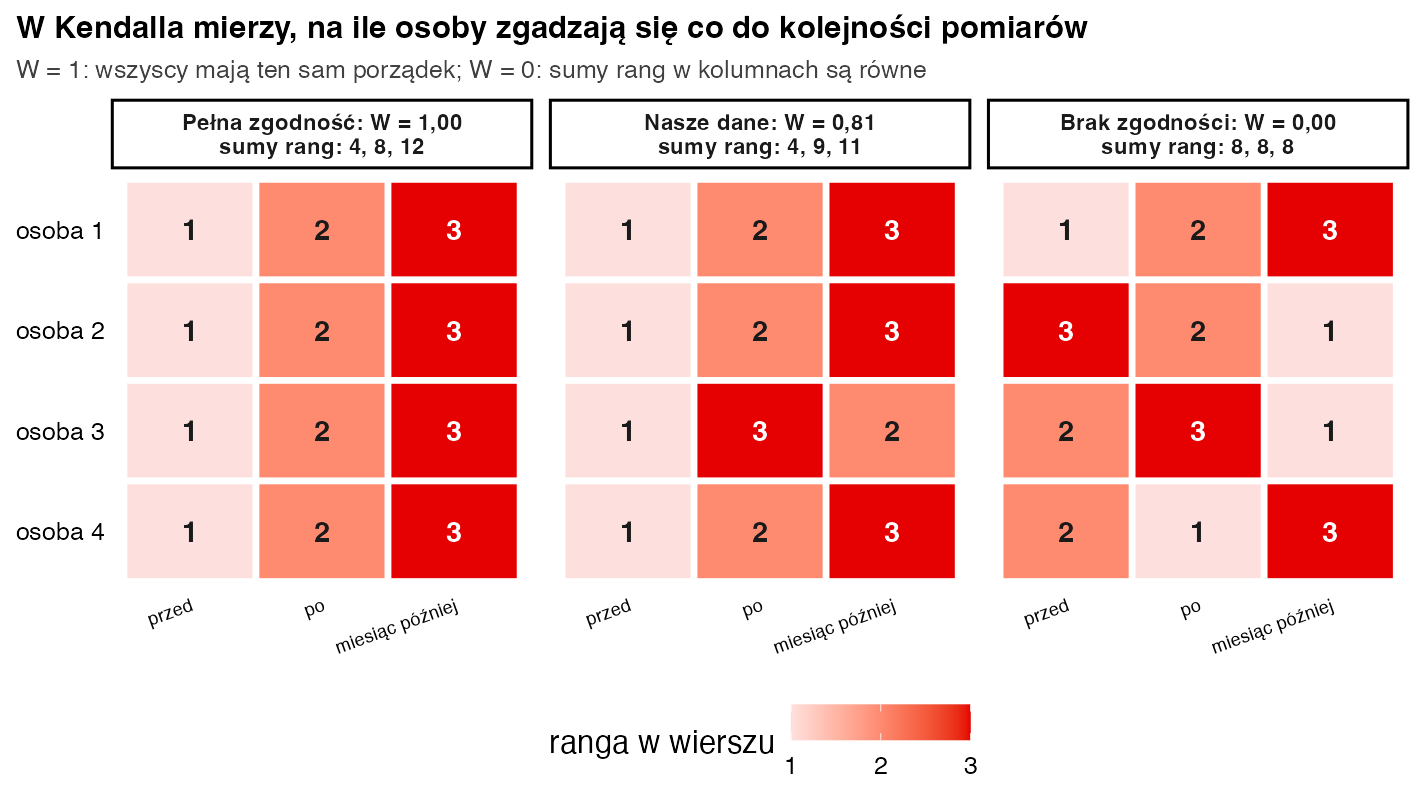
- współczynnik zgodności Kendalla: 0 – osoby zupełnie nie zgadzają się co do kolejności pomiarów, 1 – wszystkie mają tę samą kolejność
Gdy u jednej osoby dwa wyniki są równe, dostają średnią rangę (np. 1,5 i 1,5), a programy dodają poprawkę na remisy.
Przykład krok po kroku
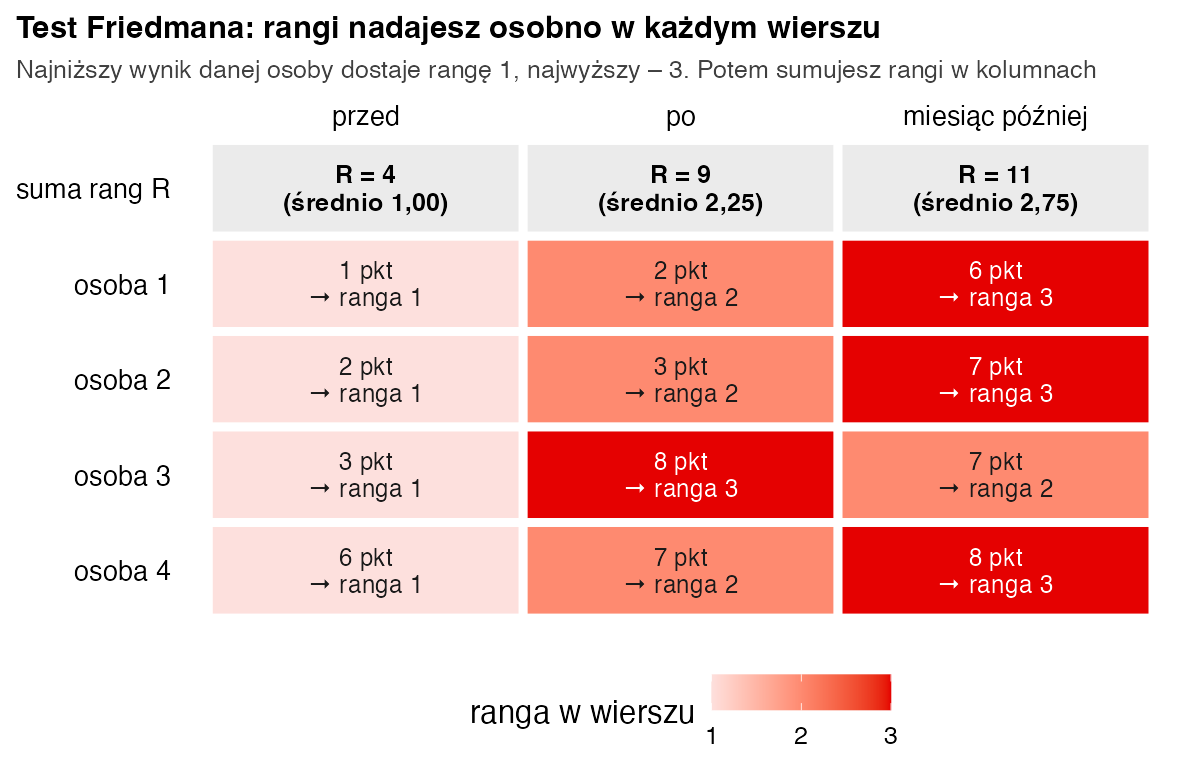
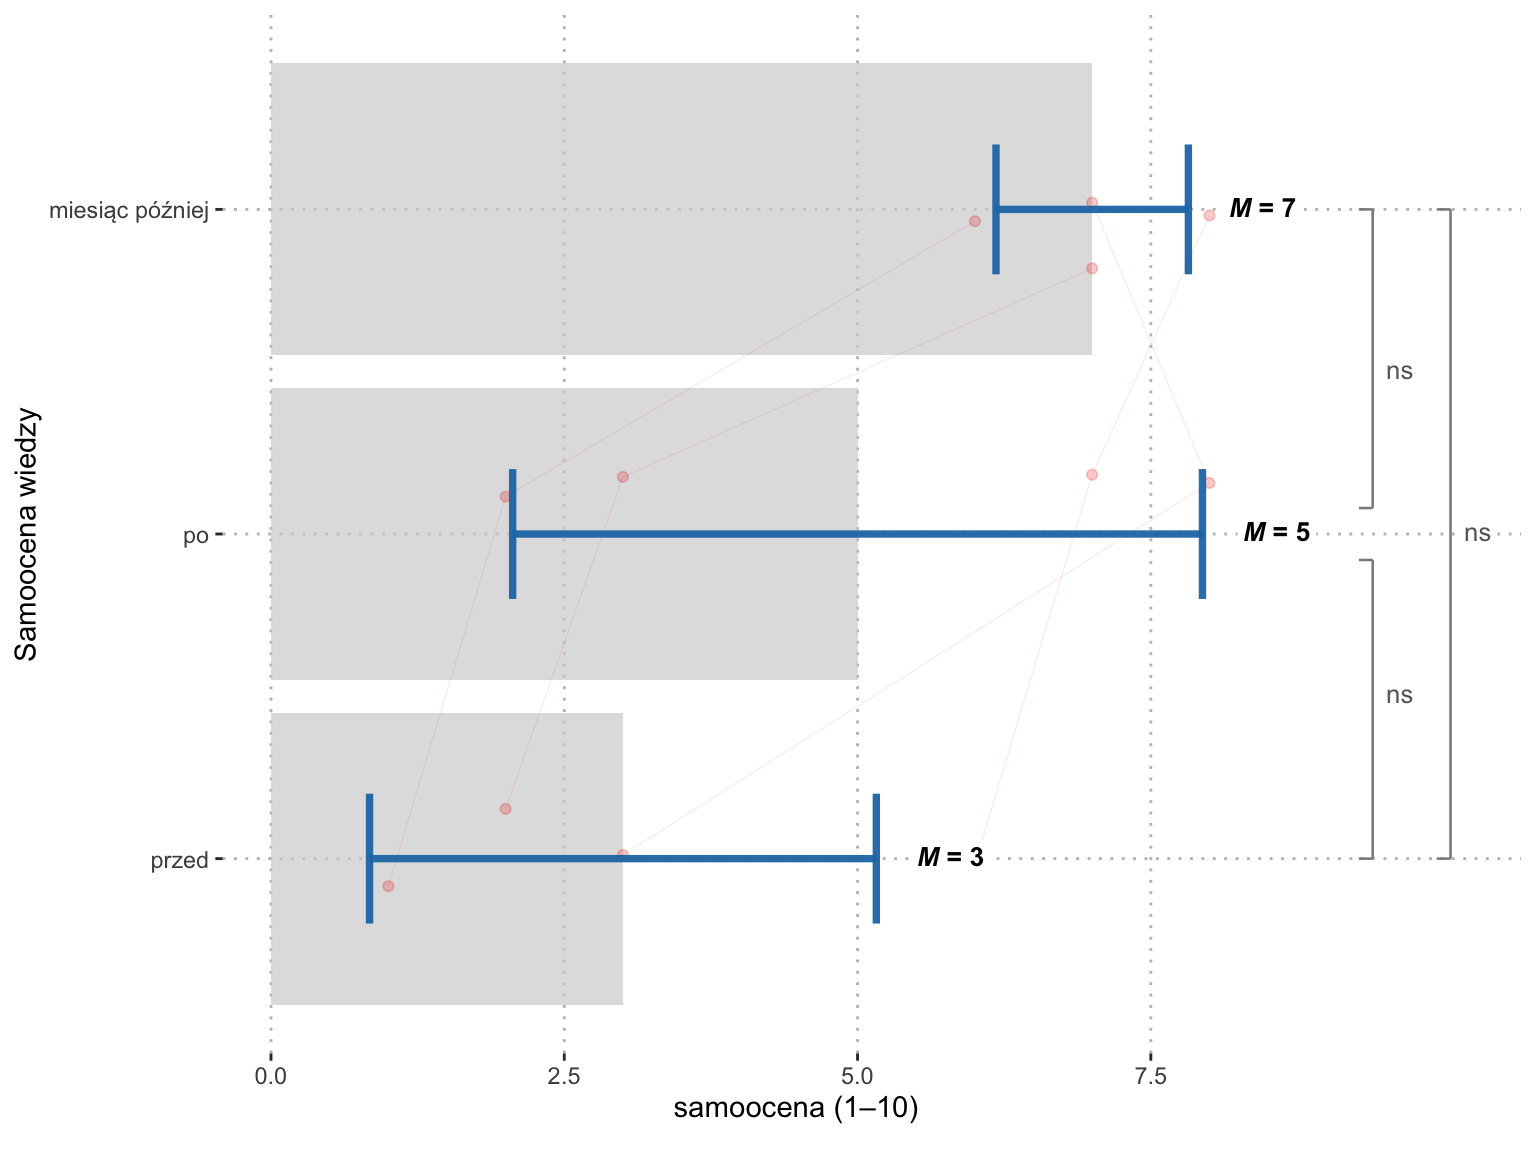
Te same dane co w haśle o ANOVA z powtarzanymi pomiarami: czworo studentów oceniło swoją wiedzę ze statystyki (1–10) przed warsztatami, zaraz po nich i miesiąc później.
| Osoba | Przed | Po | Miesiąc później | Rangi (przed, po, miesiąc) |
|---|---|---|---|---|
| 1 | 1 | 2 | 6 | 1, 2, 3 |
| 2 | 2 | 3 | 7 | 1, 2, 3 |
| 3 | 3 | 8 | 7 | 1, 3, 2 |
| 4 | 6 | 7 | 8 | 1, 2, 3 |
| suma rang Rj | 4 | 9 | 11 | 4 + 9 + 11 = 24 |
- Rangi. W każdym wierszu najniższy wynik dostaje 1, a najwyższy 3. Tylko osoba 3 miała najwyższy wynik tuż po warsztatach.
- Sumy rang. 4, 9 i 11. Kontrola: 4 + 9 + 11 = 24 = n · k(k + 1) / 2.
- Suma kwadratów. \(4^2 + 9^2 + 11^2 = 16 + 81 + 121 = 218\).
- Statystyka. \(\chi^2_F = \frac{12}{4 \cdot 3 \cdot 4} \cdot 218 - 3 \cdot 4 \cdot 4 = 54{,}5 - 48 = 6{,}50\); df = 2.
- Wartość p. Przybliżenie rozkładem χ² daje p = 0,039. Dokładne p: z 1296 możliwych układów rang 54 daje wynik co najmniej 6,50, więc p = 0,042.
- Zgodność. \(W = 6{,}5 / (4 \cdot 2) = 0{,}81\).
Jak zinterpretować i opisać wynik?
Pomiary różniły się istotnie: gdyby kolejność pomiarów była u każdej osoby przypadkowa, uporządkowanie co najmniej tak silne zdarzyłoby się w około 4% badań. W Kendalla = 0,81 oznacza wysoką zgodność osób co do kolejności pomiarów. To miara zgodności rang, a nie „procent wyjaśnionej zmienności”. Przy czterech osobach raportuj p dokładne. Test porównuje rangi w obrębie osób, a nie wprost mediany – opisuj więc średnie rangi albo mediany jako opis pomiarów.
Zapis w stylu APA: Samoocena wiedzy różniła się istotnie między pomiarami, χ²F(2) = 6,50; p = 0,042 (dokładne); W = 0,81. Średnie rangi wyniosły 1,00 przed warsztatami, 2,25 tuż po nich i 2,75 miesiąc później.
Jak policzyć test Friedmana w R?
# 4 osoby x 3 pomiary samooceny wiedzy (1–10): przed, po, miesiąc później
wyniki <- rbind(c(1, 2, 6), c(2, 3, 7), c(3, 8, 7), c(6, 7, 8))
n <- 4; k <- 3

# 1) „ręcznie”: rangi w obrębie osoby, sumy rang, statystyka i W Kendalla
rangi <- t(apply(wyniki, 1, rank))
R <- colSums(rangi)                                    # 4, 9, 11
Q <- 12 / (n * k * (k + 1)) * sum(R^2) - 3 * n * (k + 1)
c(chi2 = Q, p = pchisq(Q, k - 1, lower.tail = FALSE), W = Q / (n * (k - 1)))

# 2) gotową funkcją
friedman.test(wyniki)

# 3) p dokładne: wszystkie 6^4 = 1296 układów rang przy prawdziwej H0
perm  <- rbind(c(1, 2, 3), c(1, 3, 2), c(2, 1, 3), c(2, 3, 1), c(3, 1, 2), c(3, 2, 1))
Q_all <- apply(expand.grid(1:6, 1:6, 1:6, 1:6), 1,
               function(i) 12 / 48 * sum(colSums(perm[i, ])^2) - 48)
mean(Q_all >= Q - 1e-9)                                # 54 / 1296
Wynik w konsoli R:
      chi2          p          W
6.50000000 0.03877421 0.81250000

	Friedman rank sum test

data:  wyniki
Friedman chi-squared = 6.5, df = 2, p-value = 0.03877

[1] 0.04166667
Test Friedmana wyszedł istotny, a porównania par nie – co dalej?
To częste przy małych próbach. Test Friedmana wykorzystuje wszystkie pomiary naraz, a porównania par – tylko dwa. Przy czterech osobach najmniejsze możliwe dokładne p testu Wilcoxona wynosi 2 / 16 = 0,125, więc żadna para nie może być istotna, nawet bez korekty. Napisz uczciwie, że test ogólny wskazuje na zmianę, ale próba jest za mała, by wskazać konkretne pary. Przy większej próbie porównaj pary testem Wilcoxona z poprawką Bonferroniego lub Holma.
Najczęstsze błędy
- Nadawanie rang wszystkim wynikom razem zamiast osobno w wierszu każdej osoby.
- Test Friedmana dla różnych osób w grupach – tu potrzebny jest test Kruskala-Wallisa.
- Interpretacja W Kendalla jako procentu wyjaśnionej zmienności.
- Nazywanie go „testem median” i pisanie „przyjęto H0”, gdy p > 0,05.
- Przypisywanie autorstwa „Williamowi Friedmanowi” – test opracował ekonomista Milton Friedman (1937).
Bibliografia
- Friedman, M. (1937). The use of ranks to avoid the assumption of normality implicit in the analysis of variance. Journal of the American Statistical Association, 32(200), 675–701. https://doi.org/10.1080/01621459.1937.10503522
- Kendall, M. G., & Babington Smith, B. (1939). The problem of m rankings. The Annals of Mathematical Statistics, 10(3), 275–287.
- Tomczak, M., & Tomczak, E. (2014). The need to report effect size estimates revisited. An overview of some recommended measures of effect size. Trends in Sport Sciences, 21(1), 19–25.
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówANOVA z powtarzanymi pomiarami
- Słownik wzorówTest Wilcoxona
- Słownik wzorówTest Kruskala-Wallisa
- PoradnikTest Friedmana – przykład
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.