

Analiza wariancji z powtarzanymi pomiarami (ANOVA RM) – wzór i przykład
ANOVA z powtarzanymi pomiarami sprawdza, czy średni wynik tych samych osób zmienia się między trzema lub więcej pomiarami. Typowe pytanie z pracy dyplomowej: czy samoocena wiedzy studentów zmienia się od pomiaru przed warsztatami, przez pomiar tuż po nich, do pomiaru miesiąc później?
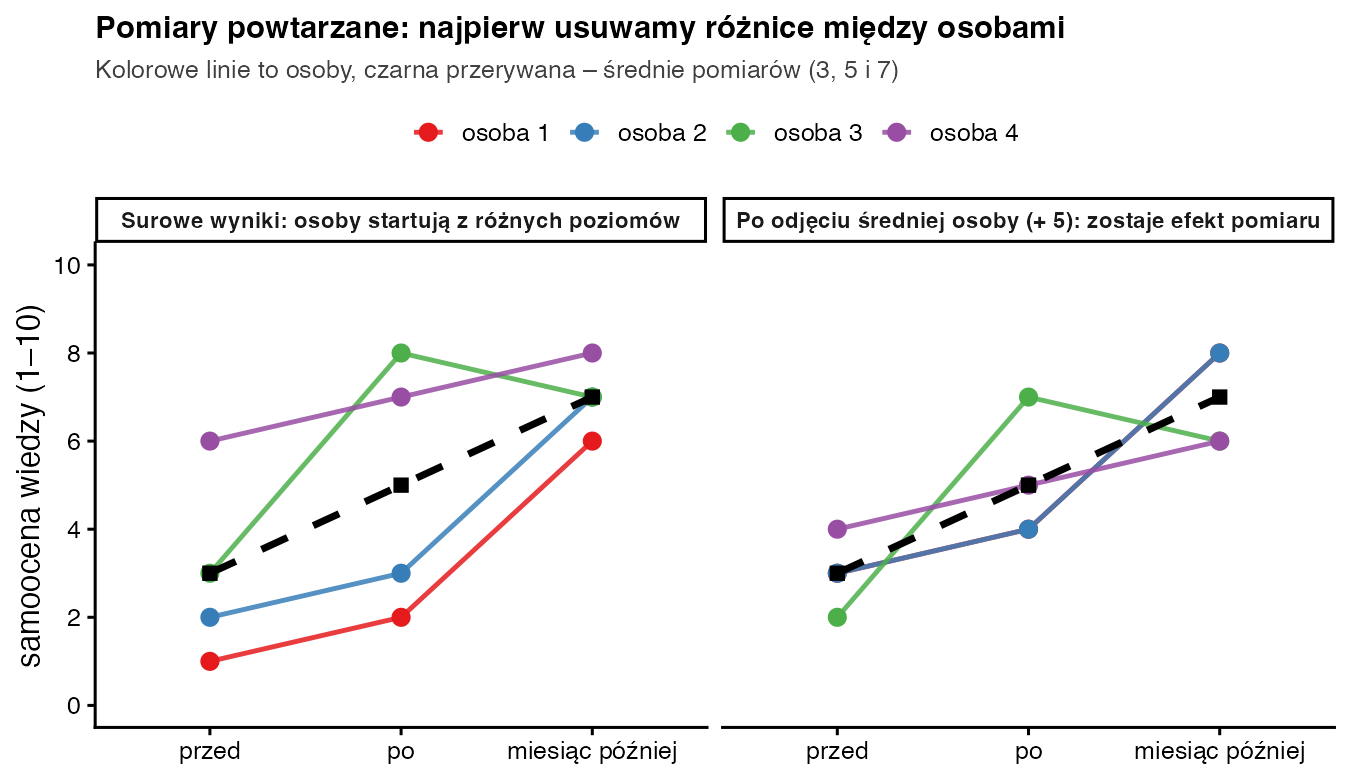
W prostych słowachJedni studenci zawsze oceniają się wysoko, inni nisko – to różnice między osobami. Skoro każdy jest swoją własną grupą kontrolną, te stałe różnice można z danych usunąć. Zostaje to, co nas interesuje: jak zmieniają się wyniki od pomiaru do pomiaru. Dzięki temu test zwykle wykrywa zmianę przy znacznie mniejszej liczbie osób niż ANOVA dla grup niezależnych.
Kiedy stosować ANOVA z powtarzanymi pomiarami?
- te same osoby zmierzono trzy lub więcej razy (albo każda osoba przeszła wszystkie warunki eksperymentu);
- zmienna zależna jest ilościowa, a jej rozkłady w pomiarach są zbliżone do normalnego;
- spełniona jest sferyczność: różnice między każdą parą pomiarów mają podobną wariancję – jeśli nie, stosujesz poprawkę Greenhouse’a-Geissera.
Przy dwóch pomiarach wynik jest identyczny jak w teście t dla prób zależnych (F = t²). Gdy dane są porządkowe albo mocno skośne, użyj testu Friedmana.
Wzór na F w ANOVA z powtarzanymi pomiarami
- \(n,\ k\)
- liczba osób i liczba pomiarów
- \(\bar{x}_j\)
- średnia w j-tym pomiarze (np. „po warsztatach”)
- \(\bar{x}_i\)
- średnia i-tej osoby ze wszystkich jej pomiarów
- \(\bar{x}\)
- średnia ogólna wszystkich wyników
- \(SS_{całk}\)
- suma kwadratów odchyleń wszystkich wyników od średniej ogólnej
- \(SS_{pom},\ SS_{os}\)
- zmienność między pomiarami (efekt) i między osobami (usuwana z błędu)
- \(SS_{błąd}\)
- reszta: na ile osoby zmieniają się w różny sposób
Przykład krok po kroku
Czworo studentów oceniło swoją wiedzę ze statystyki (skala 1–10) przed warsztatami, zaraz po nich i miesiąc później.
| Osoba | Przed | Po | Miesiąc później | Średnia osoby | Σ(x − 5)² |
|---|---|---|---|---|---|
| 1 | 1 | 2 | 6 | 3 | 16 + 9 + 1 = 26 |
| 2 | 2 | 3 | 7 | 4 | 9 + 4 + 4 = 17 |
| 3 | 3 | 8 | 7 | 6 | 4 + 9 + 4 = 17 |
| 4 | 6 | 7 | 8 | 7 | 1 + 4 + 9 = 14 |
| średnia pomiaru | 3 | 5 | 7 | 5 | SScałk = 74 |
- Zmienność całkowita. \(SS_{całk} = 26 + 17 + 17 + 14 = 74\).
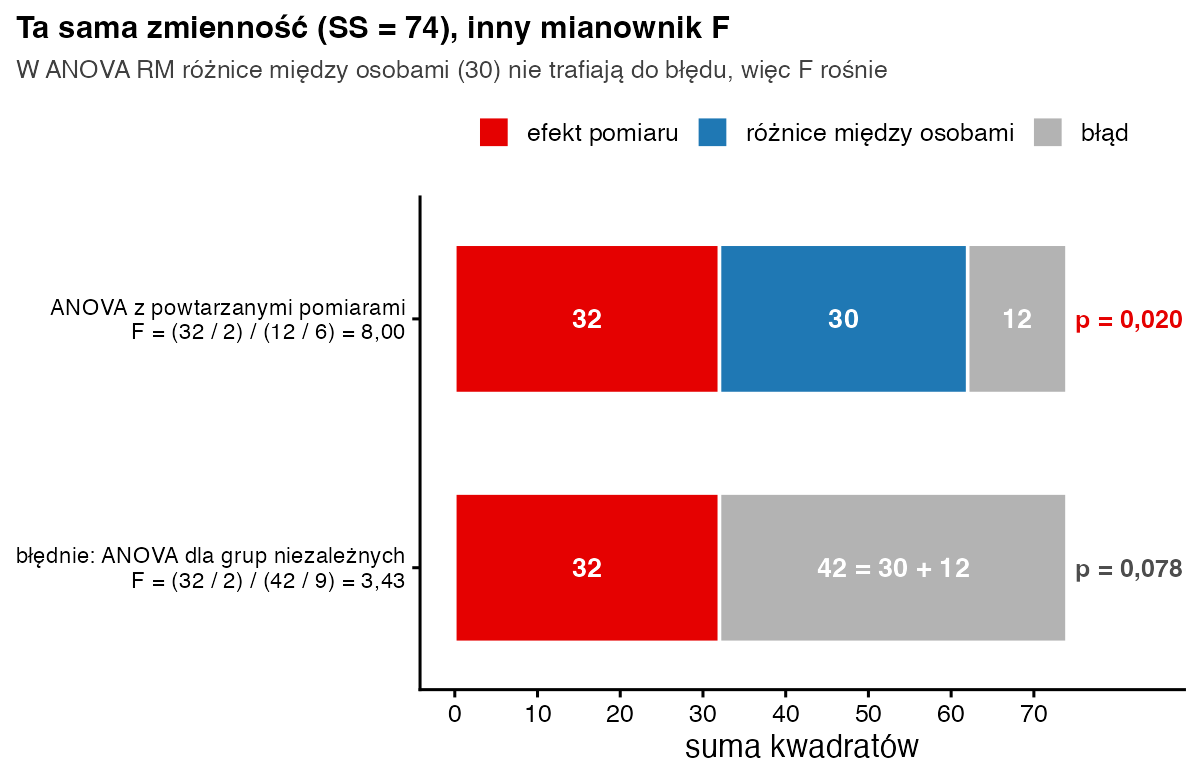
- Efekt pomiaru. \(SS_{pom} = 4 \cdot [(3 - 5)^2 + (5 - 5)^2 + (7 - 5)^2] = 4 \cdot 8 = 32\).
- Różnice między osobami. \(SS_{os} = 3 \cdot [(3 - 5)^2 + (4 - 5)^2 + (6 - 5)^2 + (7 - 5)^2] = 3 \cdot 10 = 30\).
- Błąd. \(SS_{błąd} = 74 - 32 - 30 = 12\).
- Statystyka F. df = 2 i (3 − 1)(4 − 1) = 6. F = (32 / 2) / (12 / 6) = 16 / 2 = 8,00; p = 0,020.
- Sferyczność. Wariancje różnic między pomiarami wynoszą 4, 2 i 6. Test Mauchly’ego: W = 0,67; p = 0,667. Poprawka Greenhouse’a-Geissera: ε = 0,75, czyli df = 1,5 i 4,5; p = 0,036.
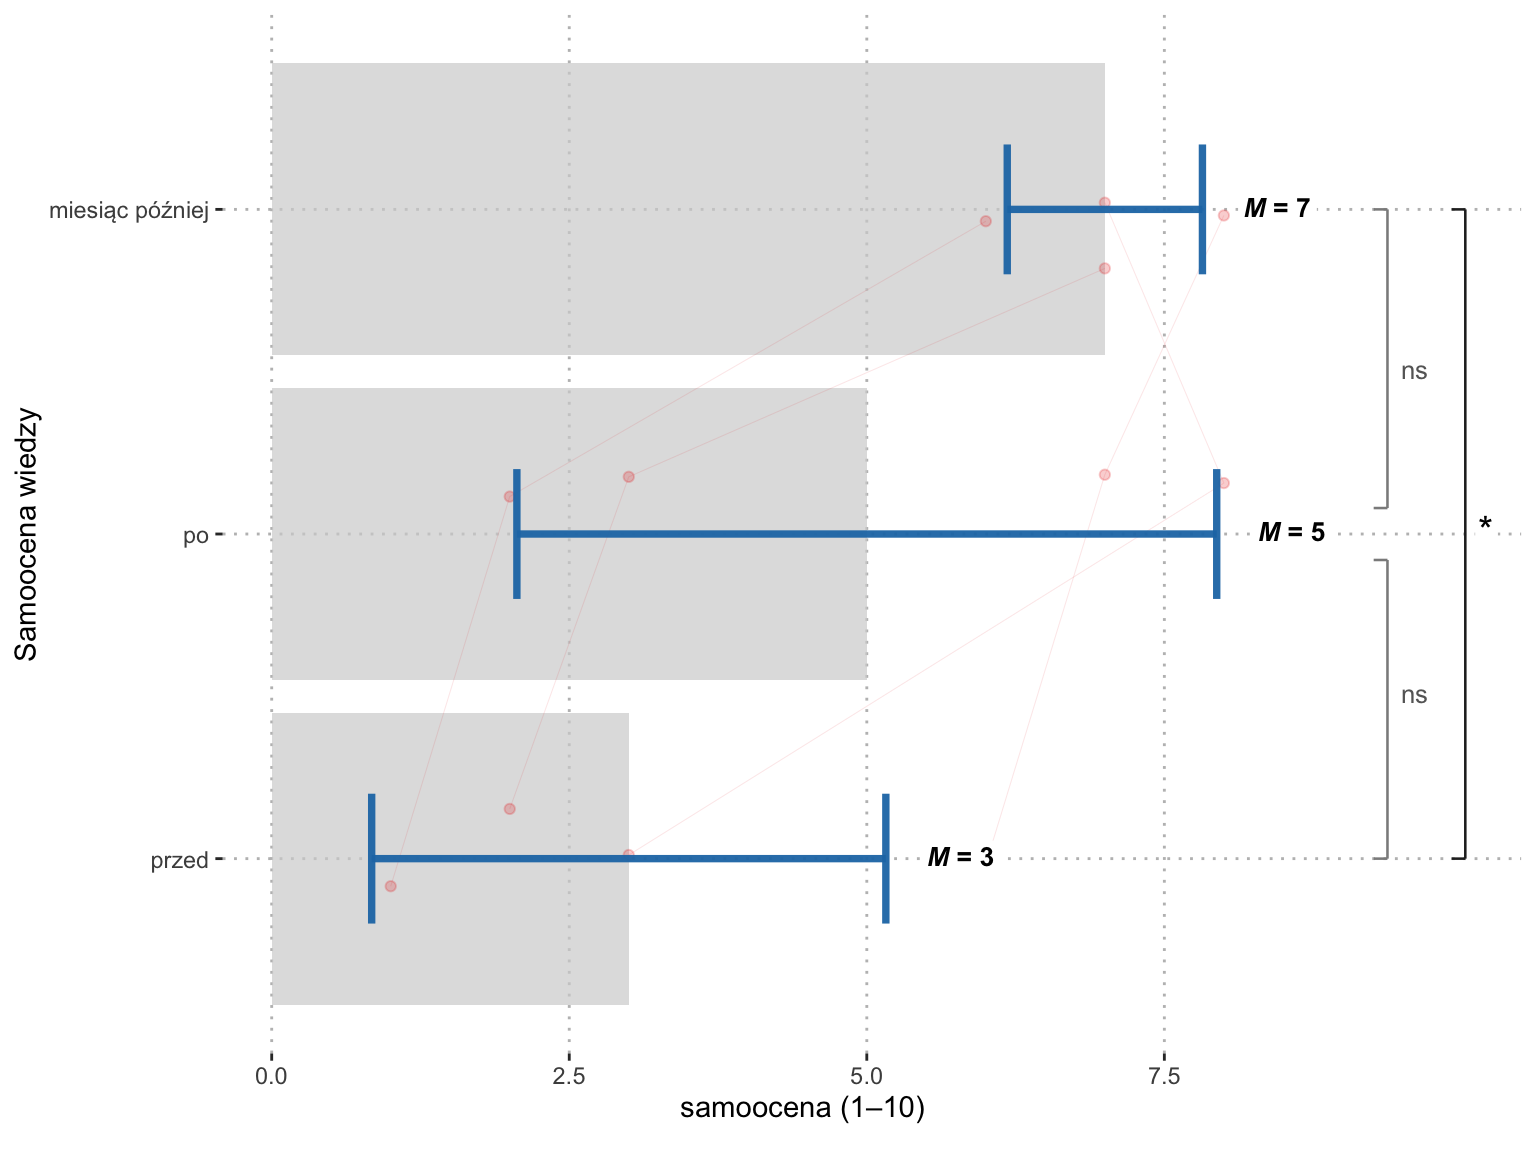
- Wielkość efektu i post hoc. Uogólnione eta kwadrat: η²G = 32 / 74 = 0,43. Testy t dla prób zależnych z poprawką Bonferroniego: istotna jest tylko różnica „przed – miesiąc później” (p = 0,033).
Jak zinterpretować i opisać wynik?
Średnia samoocena rosła z 3 przed warsztatami do 5 tuż po nich i 7 miesiąc później. Gdyby w populacji średnie we wszystkich pomiarach były równe, F co najmniej 8 otrzymalibyśmy w około 2% takich badań. η²G = 0,43 to według progów Cohena (1988) efekt duży; uogólnione η² pozwala porównywać efekty między różnymi planami badań (Bakeman, 2005). Brak grupy kontrolnej nie pozwala jednak stwierdzić, że wzrost wywołały same warsztaty – mógł to być np. efekt nauki do sesji.
Zapis w stylu APA: Samoocena wiedzy różniła się istotnie między pomiarami, F(2, 6) = 8,00; p = 0,020; η²G = 0,43. Po poprawce Greenhouse’a-Geissera (ε = 0,75) wynik pozostał istotny, F(1,5; 4,5) = 8,00; p = 0,036. Miesiąc po warsztatach samoocena była wyższa (M = 7,00; SD = 0,82) niż przed nimi (M = 3,00; SD = 2,16), p = 0,033 (Bonferroni).
Jak policzyć ANOVA z powtarzanymi pomiarami w R?
# 4 osoby x 3 pomiary samooceny wiedzy (1–10): przed, po, miesiąc później
wyniki <- rbind(c(1, 2, 6), c(2, 3, 7), c(3, 8, 7), c(6, 7, 8))
n <- 4; k <- 3; M <- mean(wyniki)

# 1) „ręcznie”: podział sum kwadratów i F
SS_pom <- n * sum((colMeans(wyniki) - M)^2)           # 32
SS_os  <- k * sum((rowMeans(wyniki) - M)^2)           # 30
SS_bl  <- sum((wyniki - M)^2) - SS_pom - SS_os        # 12
F <- (SS_pom / (k - 1)) / (SS_bl / ((k - 1) * (n - 1)))
c(F = F, p = pf(F, k - 1, (k - 1) * (n - 1), lower.tail = FALSE))

# 2) gotową funkcją: test Mauchly'ego i poprawka Greenhouse'a-Geissera
d <- data.frame(osoba = rep(1:4, 3), wynik = c(wyniki),
                pomiar = rep(c("przed", "po", "miesiac"), each = 4))
model <- afex::aov_ez("osoba", "wynik", d, within = "pomiar")
summary(model)$sphericity.tests                     # test Mauchly'ego
model                                                 # F z poprawką G-G i eta² uogólnione
Wynik w konsoli R:
        F         p
8.0000000 0.0202855
       Test statistic p-value
pomiar        0.66667 0.66667
Anova Table (Type 3 tests)

Response: wynik
  Effect         df  MSE      F  ges p.value
1 pomiar 1.50, 4.50 2.67 8.00 * .432    .036
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘+’ 0.1 ‘ ’ 1

Sphericity correction method: GG
Pakiet afex domyślnie stosuje poprawkę Greenhouse’a-Geissera: df = 1.50 i 4.50 to 2 · 0,75 i 6 · 0,75, a ges to uogólnione η²G.
Co to jest sferyczność i co zrobić, gdy jej brakuje?
Sferyczność oznacza, że różnice między każdą parą pomiarów mają podobną wariancję. Gdy jest naruszona, zwykłe p jest zaniżone. Test Mauchly’ego przy kilku osobach ma bardzo małą moc: u nas p = 0,667, choć wariancje różnic (4, 2 i 6) wyraźnie się różnią. Dlatego wielu metodologów zaleca, by zawsze patrzeć na ε. Poprawka Greenhouse’a-Geissera mnoży oba df przez ε i daje ostrożniejsze p. Przy dwóch pomiarach sferyczność jest zawsze spełniona.
Najczęstsze błędy
- ANOVA dla grup niezależnych na danych od tych samych osób – tutaj p = 0,078 zamiast 0,020.
- Pominięcie sferyczności albo poprawki przy trzech i więcej pomiarach.
- Porównania par testem Tukeya dla grup niezależnych zamiast testów t dla prób zależnych z korektą.
- Ciche usuwanie osób z brakującym pomiarem – opisz to albo użyj modelu mieszanego.
- Pisanie „przyjęto H0”, gdy p > 0,05, zamiast „brak podstaw do odrzucenia H0”.
Bibliografia
- Mauchly, J. W. (1940). Significance test for sphericity of a normal n-variate distribution. The Annals of Mathematical Statistics, 11(2), 204–209.
- Greenhouse, S. W., & Geisser, S. (1959). On methods in the analysis of profile data. Psychometrika, 24(2), 95–112.
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Bakeman, R. (2005). Recommended effect size statistics for repeated measures designs. Behavior Research Methods, 37(3), 379–384.
- Field, A., Miles, J., & Field, Z. (2012). Discovering statistics using R. SAGE.
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówTest Friedmana
- Słownik wzorówTest t Studenta dla prób zależnych
- Słownik wzorówDwuczynnikowa ANOVA z powtarzanymi pomiarami
- PoradnikANOVA – przykład
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
- Przykładowy raportAnaliza wariancji
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.