

Test Friedmana – przykład krok po kroku z interpretacją
Test Friedmana porównuje trzy lub więcej pomiarów u tych samych osób, gdy nie chcesz zakładać rozkładu normalnego. Pokazujemy cały przebieg: od rang w obrębie osoby, przez W Kendalla i porównania par, po akapit wyników i tabelę do pracy. Pytanie z pracy dyplomowej: czy samoocena wiedzy studentów zmienia się po warsztatach i czy wzrost utrzymuje się miesiąc później?
W skróciePytanie i hipotezy → dlaczego Friedman → rangi w wierszach i średnie rangi → test i W Kendalla → testy Wilcoxona z korektą Holma → opis w stylu APA, tabela i wykres. Wzór i rachunek na czterech osobach znajdziesz w haśle test Friedmana – wzór i przykład. Tu bierzemy te same cztery osoby i dokładamy kolejne cztery.
Krok 1. Pytanie badawcze i hipotezy
Ośmioro studentów oceniło swoją wiedzę ze statystyki w skali 1–10 trzy razy: przed warsztatami, zaraz po nich i miesiąc później. Te same osoby zmierzono trzykrotnie, więc pomiary są zależne.
- H0: rozkład samooceny jest w trzech pomiarach taki sam – u każdej osoby każda kolejność pomiarów jest równie prawdopodobna;
- H1: co najmniej jeden pomiar systematycznie wypada wyżej lub niżej od pozostałych; α = 0,05.
Krok 2. Dlaczego test Friedmana?
Samoocena z jednego pytania to zmienna porządkowa, a osiem osób to za mało, by sensownie ocenić rozkład różnic. Test Friedmana wymaga tylko, by osoby były od siebie niezależne, a zmienna – co najmniej porządkowa. Nie zakłada normalności ani sferyczności – w przeciwieństwie do ANOVA z powtarzanymi pomiarami. Przy dwóch pomiarach wybrałbyś test Wilcoxona, a przy różnych osobach w trzech grupach – test Kruskala-Wallisa. Pozostałe odpowiedniki testów parametrycznych zebraliśmy we wpisie o testach nieparametrycznych.
Krok 3. Dane, rangi i statystyki opisowe
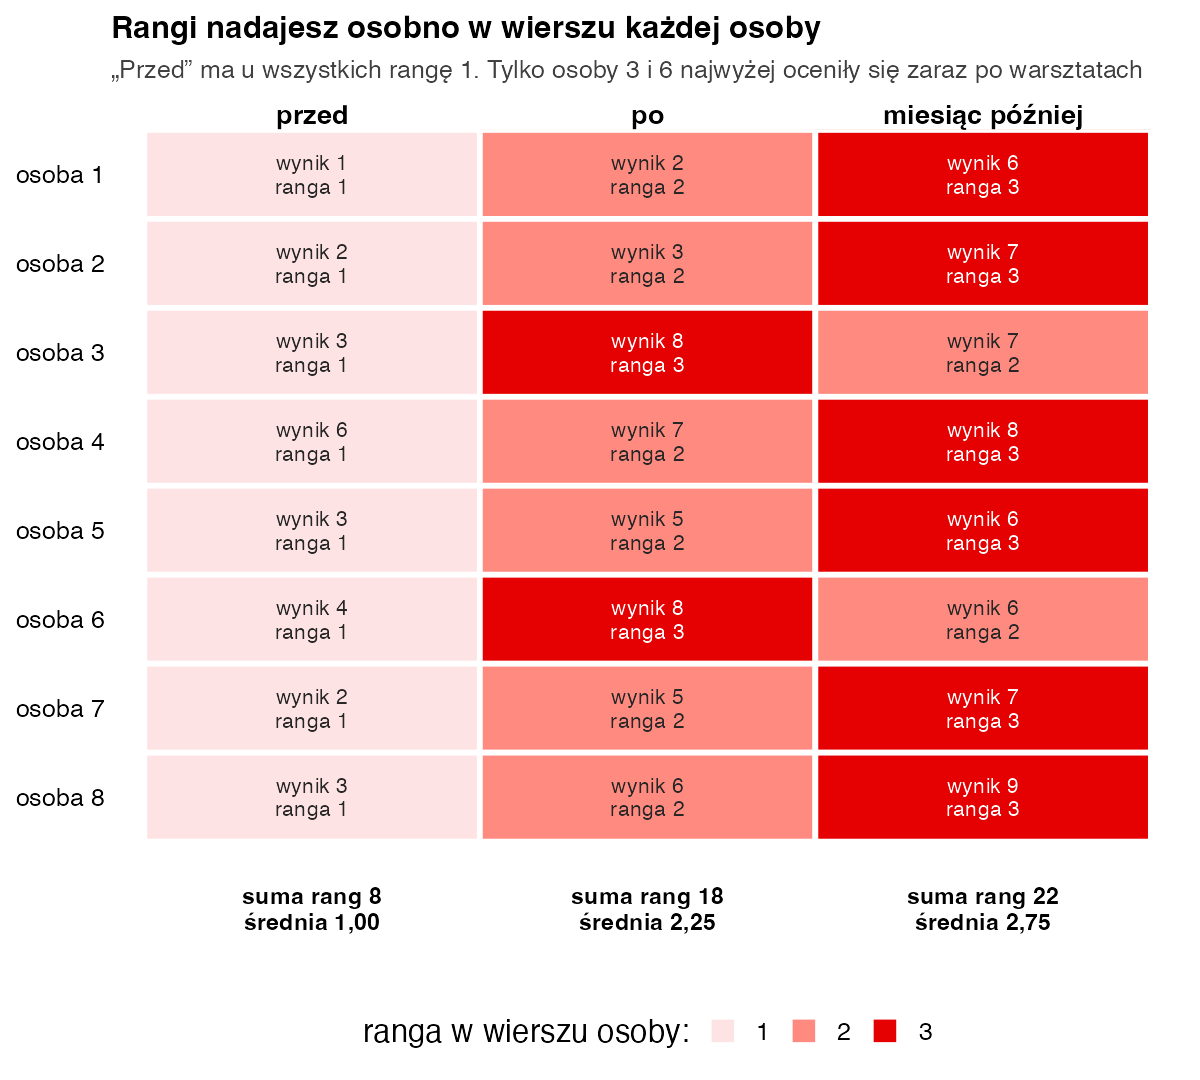
Każda osoba porównywana jest tylko sama ze sobą: w jej wierszu najniższy wynik dostaje rangę 1, a najwyższy – 3 (rys. 1). Potem sumujesz rangi w kolumnach.
| Pomiar | Wyniki osób 1–8 | Me | M (SD) | Suma rang | Średnia ranga |
|---|---|---|---|---|---|
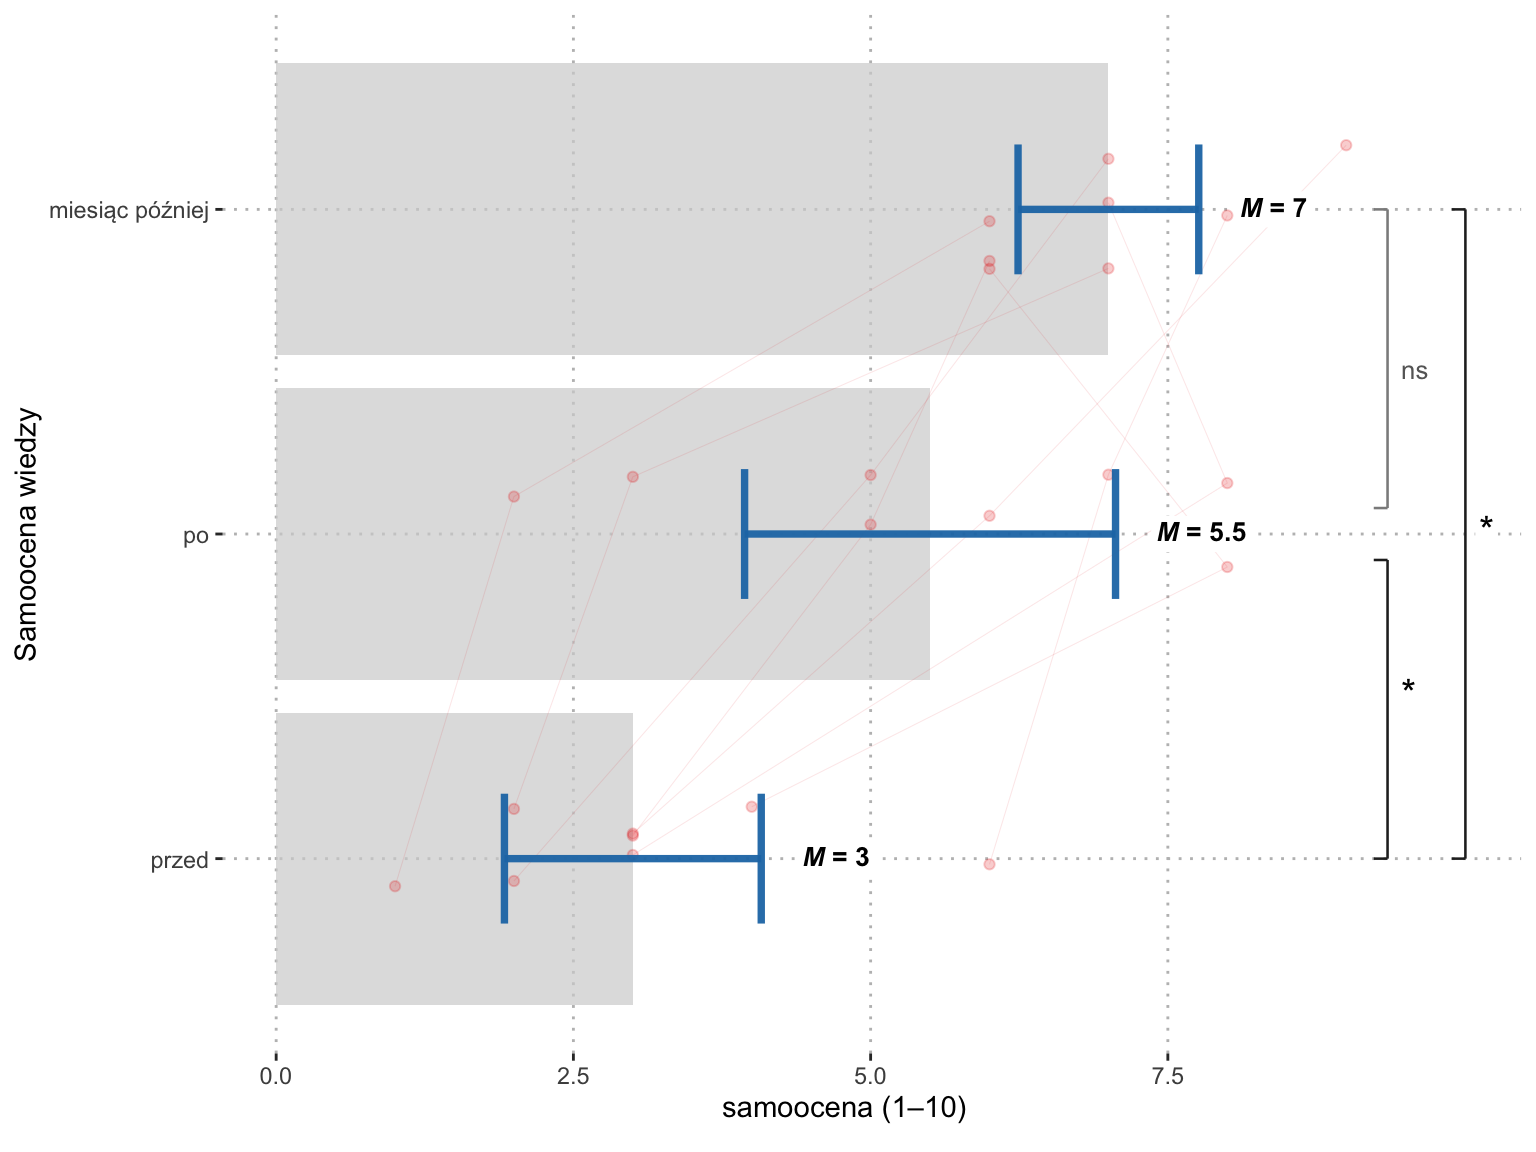
| przed | 1, 2, 3, 6, 3, 4, 2, 3 | 3,0 | 3,00 (1,51) | 8 | 1,00 |
| po | 2, 3, 8, 7, 5, 8, 5, 6 | 5,5 | 5,50 (2,20) | 18 | 2,25 |
| miesiąc później | 6, 7, 7, 8, 6, 6, 7, 9 | 7,0 | 7,00 (1,07) | 22 | 2,75 |
Krok 4. Test Friedmana i W Kendalla
- Statystyka: χ²F = 12 / (8 · 3 · 4) · (8² + 18² + 22²) − 3 · 8 · 4 = 0,125 · 872 − 96 = 13,00; df = 2; p = 0,002. Odrzucamy H0.
- Wielkość efektu: W Kendalla = 13 / (8 · 2) = 0,81. To miara zgodności osób co do kolejności pomiarów, od 0 (brak zgodności) do 1 (wszyscy mają ten sam porządek). Nie jest to procent wyjaśnionej zmienności.
- Co dalej: istotny test ogólny mówi tylko, że pomiary się różnią. Które – pokażą porównania par.
Krok 5. Post hoc: testy Wilcoxona z korektą Holma
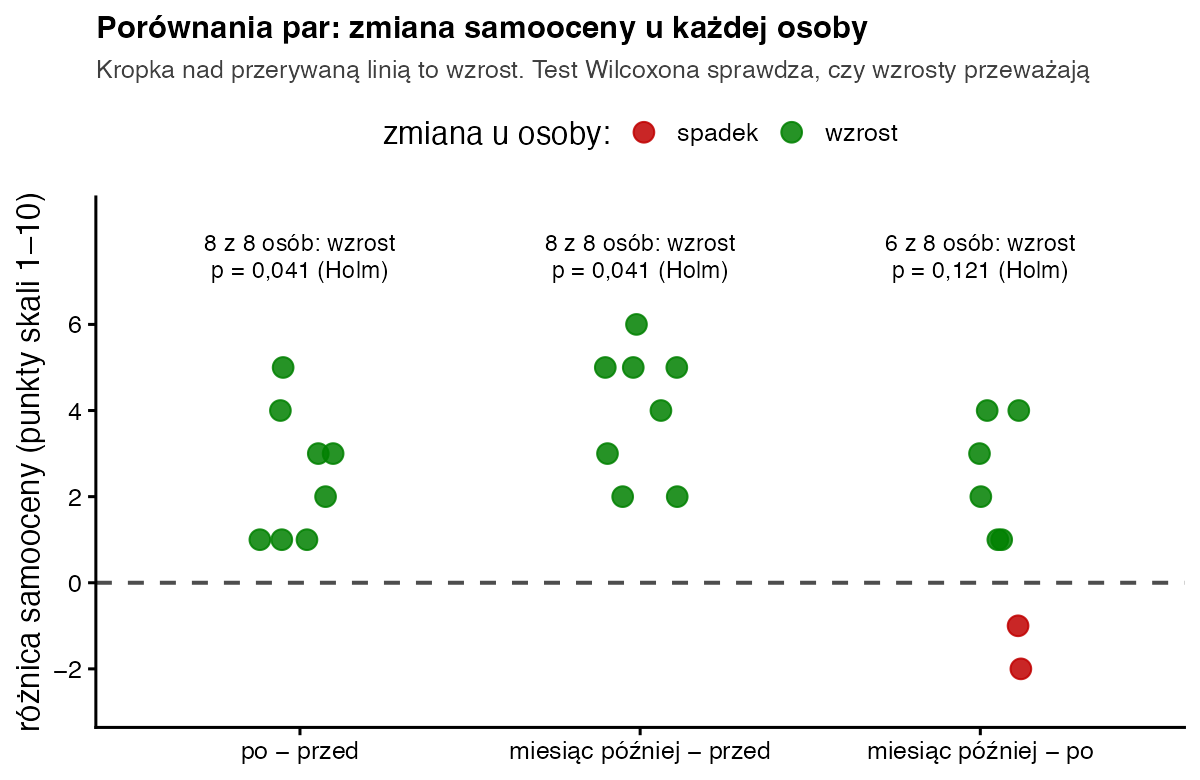
Porównujemy każdą parę pomiarów testem Wilcoxona dla par. Trzy testy to trzy okazje do fałszywego alarmu, więc stosujemy korektę Holma (1979): najmniejsze p mnożymy przez 3, następne przez 2, a ostatnie przez 1, pilnując, by skorygowane p nie malało. Logikę takich poprawek opisuje hasło poprawka Bonferroniego. Wzrost samooceny zaraz po warsztatach (p = 0,041) i miesiąc później (p = 0,041) jest istotny. To zarazem najmniejsze p, jakie da się tu uzyskać, bo wzrost miało 8 z 8 osób. Przy siedmiu osobach nawet same wzrosty dałyby po korekcie p > 0,06 – w małej próbie porównania par mają niewielki zapas. Między pomiarem „po” i „miesiąc później” różnica nie jest istotna (p = 0,121): wzrosło 6 z 8 osób, ale przy tak małej próbie to za mało, by wykluczyć przypadek.
Krok 6. Jak opisać wynik w pracy?
Zapis w stylu APA: Samoocena wiedzy różniła się istotnie między pomiarami, χ²F(2) = 13,00; p = 0,002; W = 0,81. Testy Wilcoxona z korektą Holma wykazały, że samoocena zaraz po warsztatach (Me = 5,5) i miesiąc później (Me = 7,0) była wyższa niż przed nimi (Me = 3,0), w obu przypadkach p = 0,041. Różnica między pomiarem po warsztatach a pomiarem miesiąc później nie była istotna (p = 0,121).
| Pomiar | Me | Średnia ranga | χ²F(2) | p | W Kendalla |
|---|---|---|---|---|---|
| przed | 3,0 | 1,00 | 13,00 | 0,002 | 0,81 |
| po | 5,5 | 2,25 | |||
| miesiąc później | 7,0 | 2,75 |
W nocie podaj n = 8 i informację o porównaniach par (test Wilcoxona, korekta Holma). W tekście odwołaj się do wykresu jednym zdaniem.
Cała analiza w R
# Dane: samoocena wiedzy ze statystyki (1–10), 8 osób, trzy pomiary
dane <- data.frame(osoba = factor(rep(1:8, times = 3)),
                   pomiar = factor(rep(c("przed", "po", "miesiac"), each = 8),
                                   levels = c("przed", "po", "miesiac")),
                   wynik = c(1, 2, 3, 6, 3, 4, 2, 3,     # przed warsztatami
                             2, 3, 8, 7, 5, 8, 5, 6,     # zaraz po warsztatach
                             6, 7, 7, 8, 6, 6, 7, 9))    # miesiąc później

# 1) opis: mediany pomiarów i średnie rangi nadane w obrębie każdej osoby
tapply(dane$wynik, dane$pomiar, median)
rangi <- ave(dane$wynik, dane$osoba, FUN = rank)
tapply(rangi, dane$pomiar, mean)

# 2) test Friedmana i W Kendalla = chi2 / (n * (k - 1))
fr <- friedman.test(wynik ~ pomiar | osoba, data = dane)
fr
unname(fr$statistic / (8 * (3 - 1)))

# 3) post hoc: testy Wilcoxona dla par z korektą Holma
pairwise.wilcox.test(dane$wynik, dane$pomiar, paired = TRUE,
                     p.adjust.method = "holm", exact = FALSE)
Wynik w konsoli R:
  przed      po miesiac
    3.0     5.5     7.0
  przed      po miesiac
   1.00    2.25    2.75

	Friedman rank sum test

data:  wynik and pomiar and osoba
Friedman chi-squared = 13, df = 2, p-value = 0.001503

[1] 0.8125

	Pairwise comparisons using Wilcoxon signed rank test with continuity correction

data:  dane$wynik and dane$pomiar

        przed po
po      0.041 -
miesiac 0.041 0.121

P value adjustment method: holm
Pytania promotora i recenzenta
Test Friedmana czy ANOVA z powtarzanymi pomiarami?
ANOVA wybierz, gdy zmienna jest ilościowa (np. wynik testu wiedzy z wielu zadań), a różnice między pomiarami mają rozkład zbliżony do normalnego. Na naszych danych daje ten sam wniosek: F(2, 14) = 20,79; p < 0,001. Friedman jest bezpieczniejszy przy jednym pytaniu i małej próbie.
Czy kolejność pomiarów nie zaburza wyniku?
Tu kolejność jest częścią pytania – badamy zmianę w czasie. Gdy jednak te same osoby oceniają trzy metody nauki, losuj kolejność metod, bo inaczej zmęczenie lub wprawa mieszają się z efektem metody.
Bibliografia
- Friedman, M. (1937). The use of ranks to avoid the assumption of normality implicit in the analysis of variance. Journal of the American Statistical Association, 32(200), 675–701. https://doi.org/10.1080/01621459.1937.10503522
- Kendall, M. G., & Babington Smith, B. (1939). The problem of m rankings. The Annals of Mathematical Statistics, 10(3), 275–287.
- Wilcoxon, F. (1945). Individual comparisons by ranking methods. Biometrics Bulletin, 1(6), 80–83. https://doi.org/10.2307/3001968
- Holm, S. (1979). A simple sequentially rejective multiple test procedure. Scandinavian Journal of Statistics, 6(2), 65–70.
- Tomczak, M., & Tomczak, E. (2014). The need to report effect size estimates revisited. An overview of some recommended measures of effect size. Trends in Sport Sciences, 21(1), 19–25.
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówTest Friedmana
- Słownik wzorówANOVA z powtarzanymi pomiarami
- Słownik wzorówTest Wilcoxona
- PoradnikTesty nieparametryczne
- PoradnikTesty parametryczne
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.