

Test Kruskala-Wallisa – wzór i przykład
Test Kruskala-Wallisa porównuje trzy lub więcej niezależnych grup, gdy nie chcesz zakładać rozkładu normalnego – na przykład przy ocenach na skali 1–5 albo w bardzo małych grupach. Zamiast średnich porównuje rangi. Typowe pytanie z pracy dyplomowej: czy studenci z trzech grup ćwiczeniowych różnią się wynikami kolokwium?
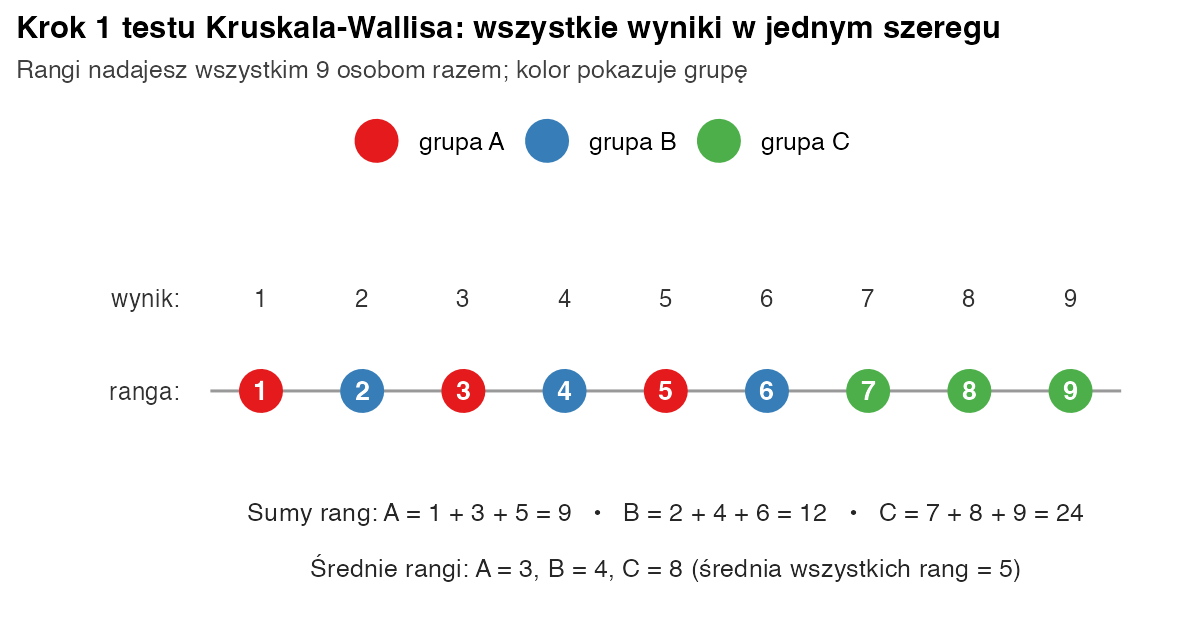
W prostych słowachUstaw wszystkie wyniki w jednym szeregu i ponumeruj je od najmniejszego. Jeśli grupy się nie różnią, ich rangi powinny być wymieszane, a średnie rangi – podobne. Statystyka H mierzy, jak bardzo średnie rangi grup odstają od średniej rangi wszystkich osób. To rozszerzenie testu U Manna-Whitneya na więcej grup.
Kiedy stosować test Kruskala-Wallisa?
- porównujesz trzy lub więcej grup różnych osób;
- zmienna jest co najmniej porządkowa;
- rozkłady są wyraźnie skośne, mają wartości odstające albo grupy są bardzo małe – wtedy test jest bezpieczniejszą alternatywą dla jednoczynnikowej ANOVA.
Przy dwóch grupach użyj testu U Manna-Whitneya. Gdy te same osoby badasz kilka razy – testu Friedmana.
Wzór na statystykę H
- \(R_j\)
- suma rang w grupie j (rangi nadajesz wszystkim osobom razem)
- \(n_j\)
- liczba osób w grupie j
- \(N\)
- liczba wszystkich osób
- \(k\)
- liczba grup
- \(\eta^2_H\)
- wielkość efektu: jaka część zmienności rang wiąże się z grupą
Gdy pojawiają się remisy, równe wyniki dostają średnią rangę, a H dzieli się przez \(1 - \sum (t^3 - t)/(N^3 - N)\), gdzie t to liczba osób z tym samym wynikiem (liczysz osobno dla każdego powtarzającego się wyniku). Programy robią to automatycznie.
Przykład krok po kroku
Te same dane co w haśle o ANOVA: punkty z kolokwium w trzech grupach ćwiczeniowych. Grupa A: 1, 3, 5. Grupa B: 2, 4, 6. Grupa C: 7, 8, 9. Wyniki to liczby od 1 do 9 bez powtórzeń, więc ich rangi są równe samym wynikom.
| Grupa | Rangi | Suma rang Rj | Średnia ranga | Rj² / nj |
|---|---|---|---|---|
| A | 1, 3, 5 | 9 | 3 | 81 / 3 = 27 |
| B | 2, 4, 6 | 12 | 4 | 144 / 3 = 48 |
| C | 7, 8, 9 | 24 | 8 | 576 / 3 = 192 |
| razem | 1–9 | 45 | 5 | 267 |
- Rangi. Ustaw wszystkie 9 wyników od najmniejszego do największego i ponumeruj je od 1 do 9.
- Sumy rang. A: 9, B: 12, C: 24. Kontrola: 9 + 12 + 24 = 45, czyli suma liczb od 1 do 9.
- Statystyka H. \(H = \frac{12}{9 \cdot 10} \cdot 267 - 3 \cdot 10 = 35{,}6 - 30 = 5{,}60\); df = 2.
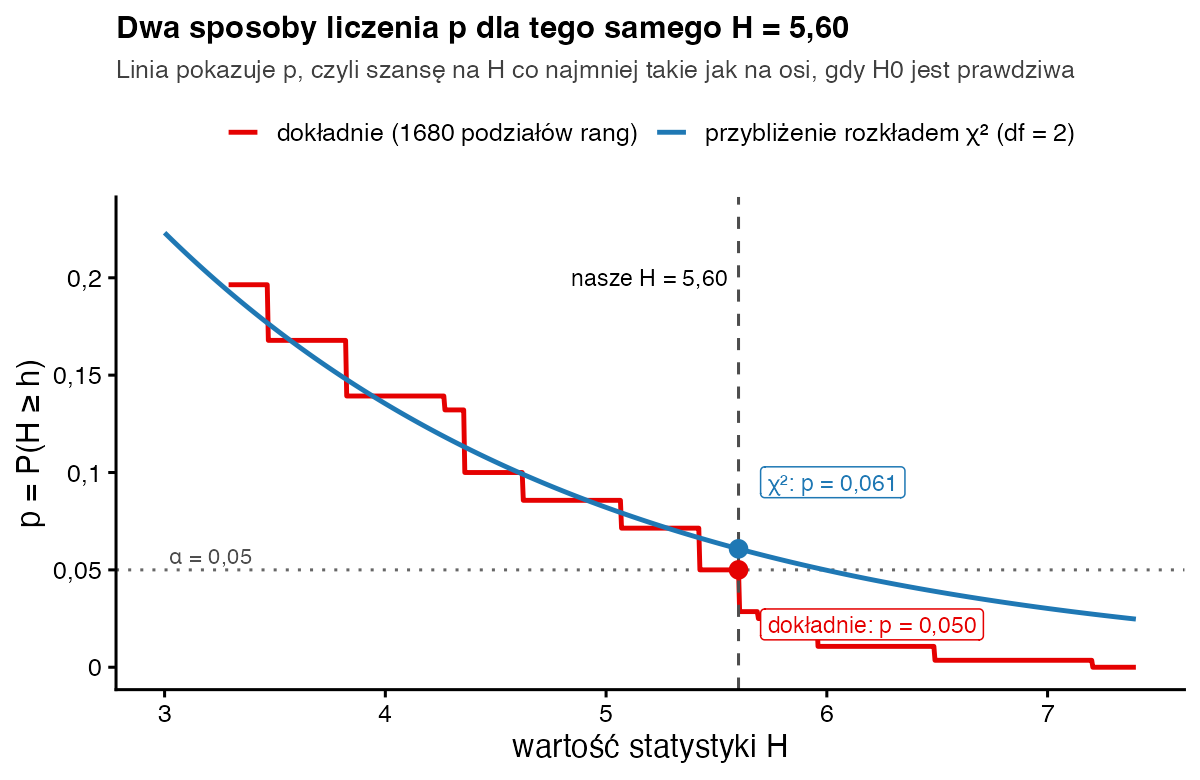
- Wartość p z przybliżenia. Rozkład χ² z 2 stopniami swobody daje p = 0,061.
- Wartość p dokładna. Rangi 1–9 można podzielić na trzy grupy po trzy na 1680 sposobów. H ≥ 5,60 daje 84 z nich, więc p = 84 / 1680 = 0,050.
- Wielkość efektu. \(\eta^2_H = (5{,}6 - 3 + 1) / (9 - 3) = 0{,}60\).
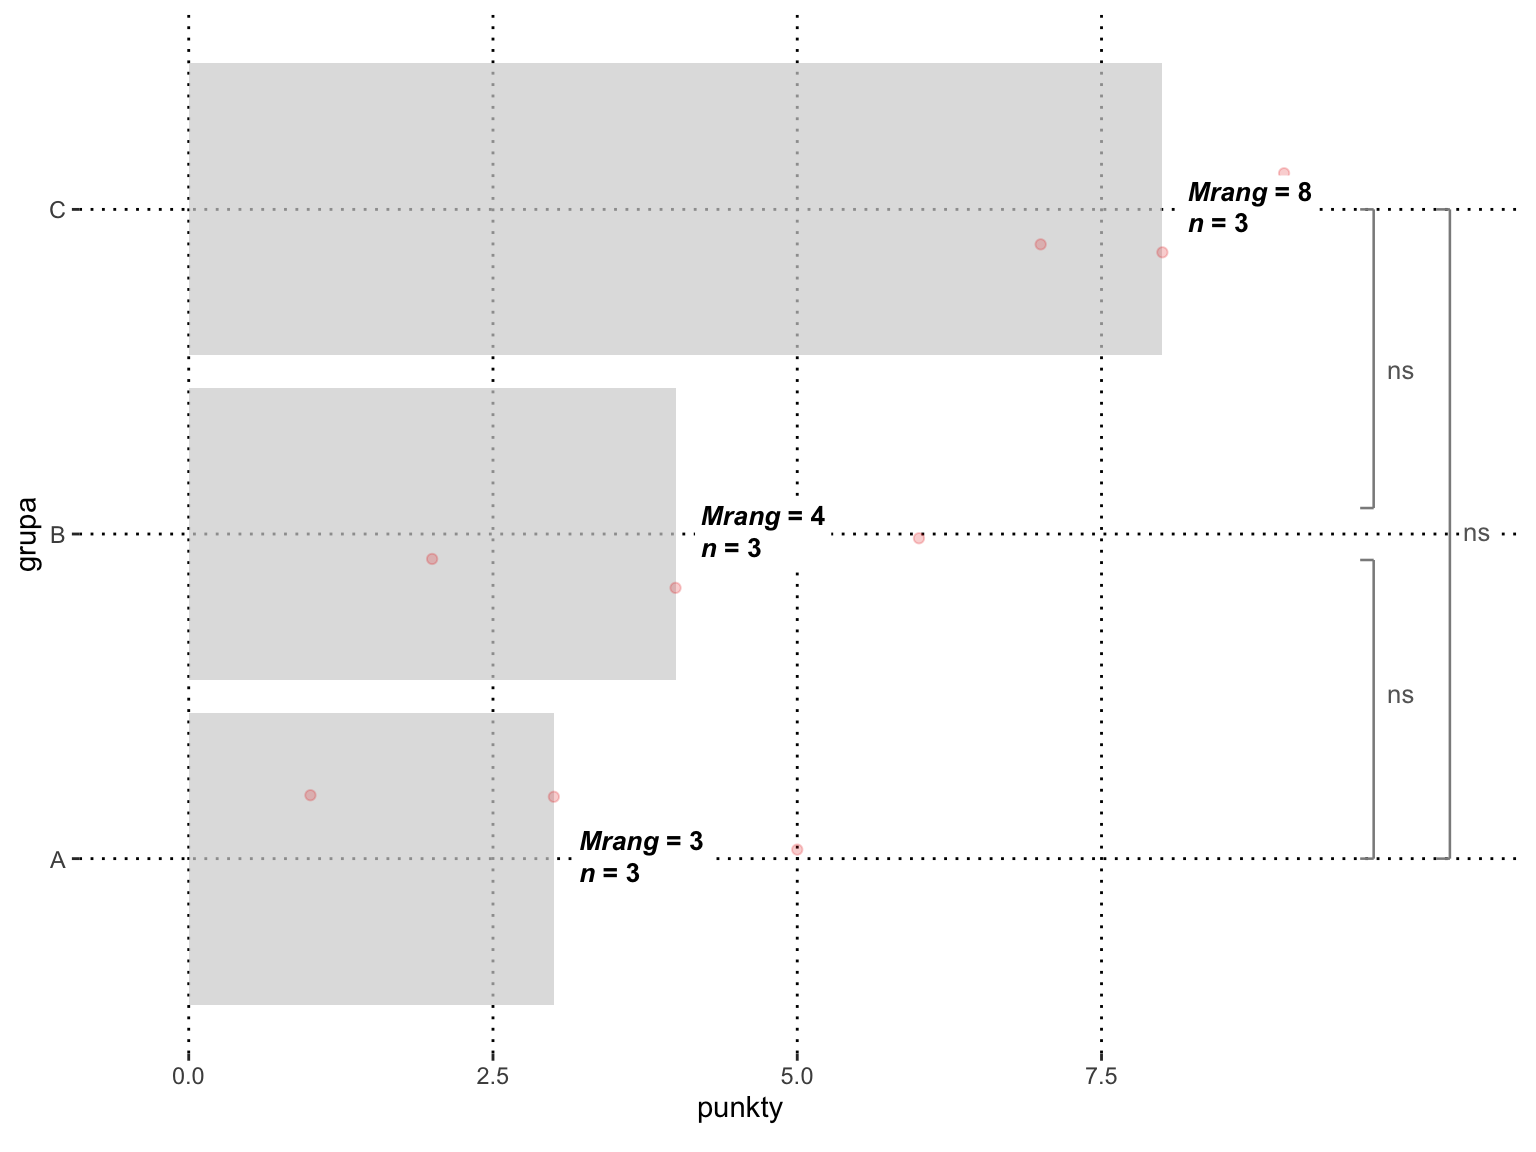
- Post hoc. Test Dunna z korektą Holma: A–C p = 0,076; B–C p = 0,147; A–B p = 0,655. Żadna para nie jest istotna.
Jak zinterpretować i opisać wynik?
Na tych samych danych ANOVA dała p = 0,027, a test Kruskala-Wallisa – p = 0,050 (dokładne) lub 0,061 (przybliżone). To lekcja o mocy. Test rangowy nie widzi, że wyniki grupy C są wyraźnie oddalone od reszty – dla niego 7 jest tylko „o jedno miejsce” wyżej niż 6. Przy tak małych grupach raportuj p dokładne i napisz to wprost. Tutaj wynik leży dokładnie na granicy α = 0,05, a żadna para w post hoc nie jest istotna. Opisz go więc ostrożnie: nie jest to ani mocny dowód różnicy, ani dowód jej braku.
Zapis w stylu APA: Grupy ćwiczeniowe różniły się liczbą punktów na granicy istotności statystycznej, H(2) = 5,60; p = 0,050 (dokładne); η²H = 0,60. Najwyższą średnią rangę miała grupa C (Mrang = 8), a niższe – grupy B (4) i A (3). Test post hoc Dunna z korektą Holma nie wykazał istotnych różnic między parami grup (wszystkie p ≥ 0,076).
Jak policzyć test Kruskala-Wallisa w R?
punkty <- c(1, 3, 5,  2, 4, 6,  7, 8, 9)
grupa  <- factor(rep(c("A", "B", "C"), each = 3))

# 1) „ręcznie”: rangi, sumy rang, H i wielkość efektu
R <- tapply(rank(punkty), grupa, sum)                 # 9, 12, 24
N <- 9; k <- 3
H <- 12 / (N * (N + 1)) * sum(R^2 / 3) - 3 * (N + 1)
c(H = H, eta2_H = (H - k + 1) / (N - k))              # 5.6 i 0.6

# 2) gotową funkcją (p z przybliżenia rozkładem chi-kwadrat)
kruskal.test(punkty ~ grupa)

# 3) p dokładne: wszystkie 1680 podziałów rang 1–9 na trzy grupy po 3
H_all <- c()
for (a in combn(9, 3, simplify = FALSE)) for (b in combn(setdiff(1:9, a), 3, simplify = FALSE)) {
  S <- c(sum(a), sum(b), 45 - sum(a) - sum(b)); H_all <- c(H_all, 12 / 90 * sum(S^2 / 3) - 30) }
mean(H_all >= H - 1e-9)                               # 84 / 1680 = 0.05

# 4) post hoc: test Dunna z korektą Holma
rstatix::dunn_test(data.frame(punkty, grupa), punkty ~ grupa, p.adjust.method = "holm")
Wynik w konsoli R:
     H eta2_H
   5.6    0.6

	Kruskal-Wallis rank sum test

data:  punkty by grupa
Kruskal-Wallis chi-squared = 5.6, df = 2, p-value = 0.06081

[1] 0.05
# A tibble: 3 × 9
  .y.    group1 group2    n1    n2 statistic      p  p.adj p.adj.signif
* <chr>  <chr>  <chr>  <int> <int>     <dbl>  <dbl>  <dbl> <chr>
1 punkty A      B          3     3     0.447 0.655  0.655  ns
2 punkty A      C          3     3     2.24  0.0253 0.0760 ns
3 punkty B      C          3     3     1.79  0.0736 0.147  ns
kruskal.test() podaje p z przybliżenia χ². Przy kilkunastu osobach w grupie obie wartości są już bardzo bliskie.
Czy test Kruskala-Wallisa porównuje mediany?
Nie wprost. Test sprawdza, czy wyniki w którejś grupie mają tendencję do bycia wyższymi niż w innych. O różnicy median możesz mówić tylko wtedy, gdy rozkłady we wszystkich grupach mają podobny kształt i rozrzut. Dlatego w opisie podawaj średnie rangi (albo mediany jako opis grup), H, df, p i wielkość efektu. Jeśli wynik jest istotny, sprawdź pary testem Dunna z korektą, np. Holma albo Bonferroniego.
Najczęstsze błędy
- Nazywanie testu „testem median” bez założenia o podobnym kształcie rozkładów.
- Podawanie średnich wyników zamiast średnich rang lub median.
- Seria testów U Manna-Whitneya bez korekty zamiast testu Dunna z korektą.
- Raportowanie p z przybliżenia χ² przy grupach liczących po kilka osób bez żadnej wzmianki.
- Użycie testu dla tych samych osób zbadanych kilka razy – tu potrzebny jest test Friedmana.
Bibliografia
- Kruskal, W. H., & Wallis, W. A. (1952). Use of ranks in one-criterion variance analysis. Journal of the American Statistical Association, 47(260), 583–621. https://doi.org/10.1080/01621459.1952.10483441
- Dunn, O. J. (1964). Multiple comparisons using rank sums. Technometrics, 6(3), 241–252. https://doi.org/10.1080/00401706.1964.10490181
- Tomczak, M., & Tomczak, E. (2014). The need to report effect size estimates revisited. An overview of some recommended measures of effect size. Trends in Sport Sciences, 21(1), 19–25.
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówJednoczynnikowa ANOVA
- Słownik wzorówTest U Manna-Whitneya
- Słownik wzorówTest Friedmana
- PoradnikTesty nieparametryczne
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
- Przykładowy raportTest Kruskala-Wallisa
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.