

Testy nieparametryczne – kiedy je stosować i jak raportować wyniki
Test nieparametryczny nie zakłada, że wyniki mają określony rozkład, np. normalny. Najczęściej pracuje na rangach, czyli miejscach wyników w szeregu od najmniejszego do największego. Typowe pytanie z pracy dyplomowej: czy przy ocenach 1–5 albo przy kilku skrajnych wynikach mogę użyć testu t, czy lepiej testu U Manna-Whitneya?
W prostych słowachTest rangowy nie pyta, o ile punktów różnią się średnie. Pyta, czy wyniki jednej grupy częściej stoją wyżej w szeregu. Dlatego jeden bardzo wysoki wynik nie rozsadza analizy – jest po prostu ostatni w kolejce. Ceną jest to, że przy danych zbliżonych do normalnych test rangowy nieco słabiej wykrywa różnice.
Czym jest test nieparametryczny i jakie ma założenia?
„Nieparametryczny” znaczy: niezakładający konkretnego kształtu rozkładu. Nie znaczy: bez założeń. Obserwacje nadal muszą być niezależne (albo poprawnie sparowane), zmienna – co najmniej porządkowa, a test Wilcoxona dla par zakłada symetryczny rozkład różnic. Nieparametryczny jest test, a nie dane – nie ma „danych nieparametrycznych”.
Kiedy wybrać test nieparametryczny?
- zmienna jest porządkowa: pojedyncze pytanie Likerta 1–5, miejsce w rankingu, ocena;
- grupy są małe, a rozkład wyraźnie skośny albo z prawdziwymi wynikami odstającymi, których nie wolno usunąć;
- analizujesz liczebności kategorii (np. tak/nie w różnych grupach) – wtedy test chi-kwadrat.
Sam mały rozmiar próby nie jest powodem. Jeśli dane wyglądają normalnie, test parametryczny działa także w małych grupach – porównanie znajdziesz we wpisie o testach parametrycznych.
Odpowiedniki testów parametrycznych – tabela decyzyjna
| Układ badania | Test parametryczny | Test nieparametryczny | Co sprawdza test nieparametryczny | Wielkość efektu |
|---|---|---|---|---|
| dwie grupy różnych osób | test t | U Manna-Whitneya (przykład) | czy wyniki jednej grupy mają tendencję do bycia wyższymi | korelacja rangowo-dwuseryjna rrb |
| te same osoby, dwa pomiary | test t dla prób zależnych | Wilcoxona dla par | czy wzrosty przeważają nad spadkami (z uwzględnieniem ich wielkości) | rrb dla par |
| trzy grupy i więcej | ANOVA | Kruskala-Wallisa (raport) | czy średnie rangi grup się różnią | η²H |
| te same osoby, trzy pomiary i więcej | ANOVA z powtarzanymi pomiarami | Friedmana (przykład) | czy któryś pomiar u tych samych osób systematycznie wypada wyżej | W Kendalla |
| związek dwóch zmiennych | korelacja Pearsona | korelacja Spearmana (przykład) | czy rankingi obu zmiennych są zgodne (związek monotoniczny) | rs |
| dwie zmienne jakościowe | – | chi-kwadrat (przykład) | czy cechy są od siebie niezależne | φ lub V Cramera |
Co naprawdę testują testy rangowe?
Test U i test Kruskala-Wallisa nie są „testami median”. Sprawdzają, czy wyniki z jednej grupy mają tendencję do przyjmowania wyższych wartości niż z drugiej. Mogą dać istotny wynik przy identycznych medianach, jeśli rozkłady różnią się kształtem lub rozrzutem (Hart, 2001; Divine i in., 2018). O różnicy median pisz tylko wtedy, gdy rozkłady w grupach mają podobny kształt i różnią się jedynie położeniem. W opisie podawaj mediany lub średnie rangi, statystykę testu, p i wielkość efektu.
Czy test nieparametryczny jest lepszy przy małej próbie?
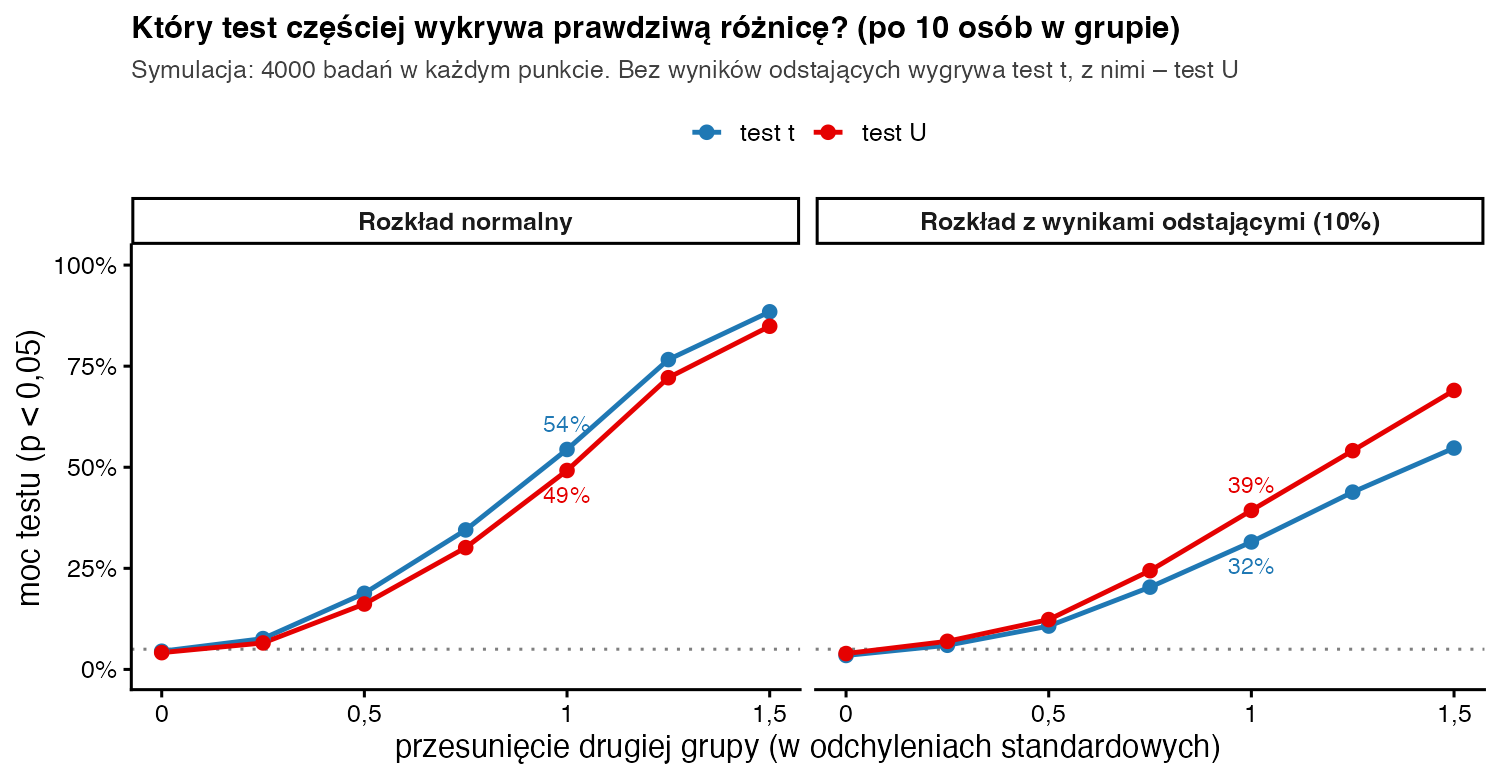
Nie. Gdy rozkłady są normalne, test U ma około 95% efektywności testu t – potrzebuje trochę więcej osób, by wykryć tę samą różnicę. Przy żadnym rozkładzie nie spada poniżej ok. 86% (Hodges i Lehmann, 1956). W bardzo małych grupach bywa bezradny: przy 3 + 3 osobach najmniejsze możliwe p wynosi 0,10, więc istotności nie da się uzyskać. Przewagę zyskuje przy wynikach odstających.
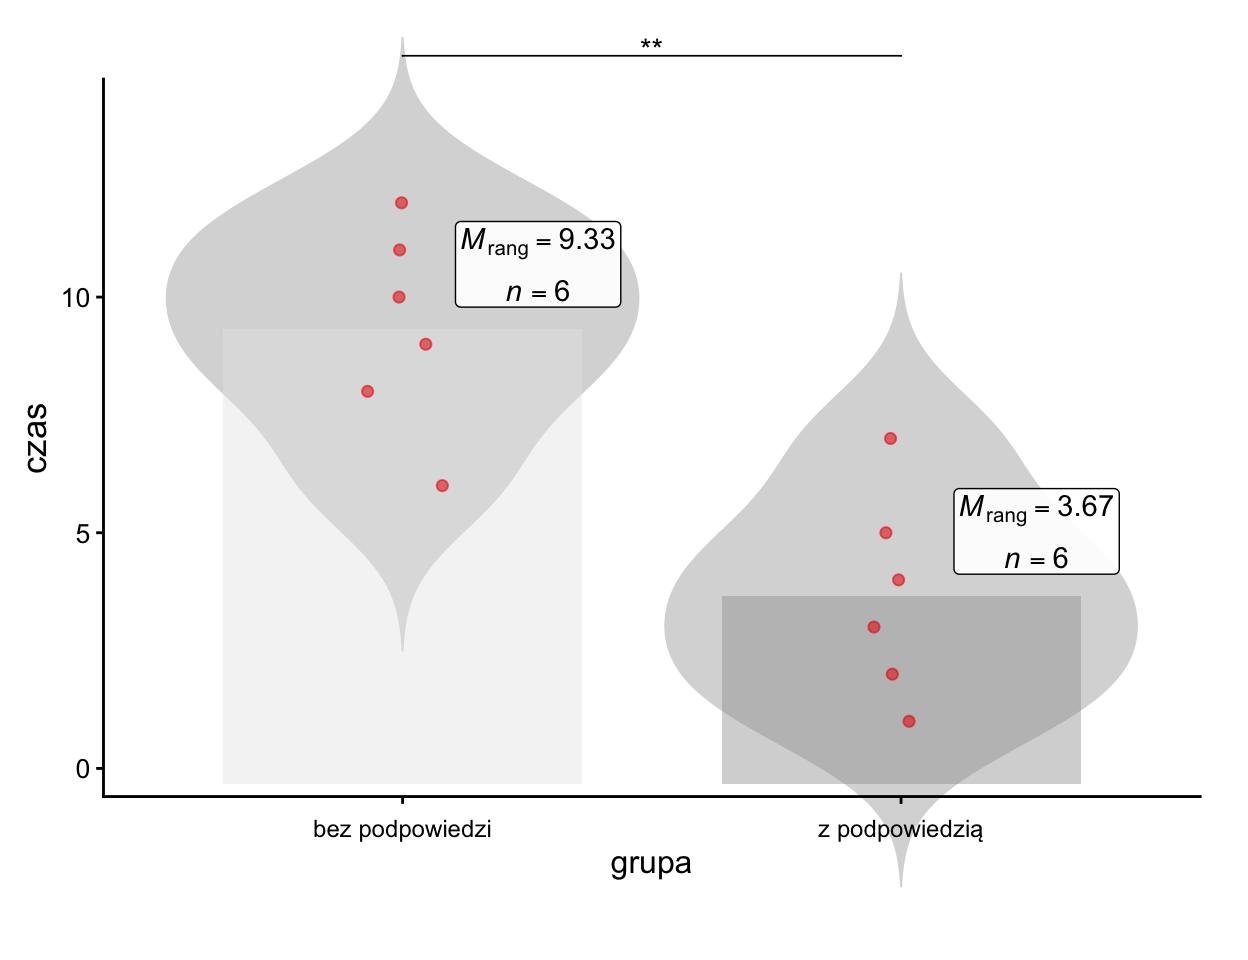
Przykład: czas rozwiązania zadania w grupie z podpowiedzią (2, 3, 4, 5, 6, 8 minut) i bez niej (7, 9, 10, 11, 12, 40 minut). Jedna osoba utknęła na 40 minut. Test t Welcha daje t(5,30) = 1,97; p = 0,103 – skrajny wynik zawyża rozrzut. Test U daje U = 1; p = 0,004, bo dla rang 40 minut to po prostu miejsce dwunaste.
Zapis w stylu APA: Osoby z podpowiedzią rozwiązywały zadanie szybciej (Me = 4,5 min; Mrang = 3,67) niż osoby bez podpowiedzi (Me = 10,5 min; Mrang = 9,33), U = 1; p = 0,004; rrb = 0,94.
Test Kruskala-Wallisa – przykład
Test Kruskala-Wallisa to uogólnienie testu U na trzy i więcej grup niezależnych. Porównasz nim np. poziom energii przy trzech dietach albo punkty w trzech grupach ćwiczeniowych. Weźmy grupy A (1, 3, 5), B (2, 4, 6) i C (7, 8, 9). ANOVA daje F(2, 6) = 7,00; p = 0,027, a test Kruskala-Wallisa H(2) = 5,60; p = 0,061 (dokładne p = 0,050 – na samej granicy); η²H = 0,60. Te same dane, a test rangowy przy trzech osobach w grupie ma za mało informacji. Nawet istotny wynik mówi tylko, że jakieś grupy się różnią. Które – pokaże test post hoc Dunna z korektą Holma (Dunn, 1964). Tu, zgodnie z wynikiem ogólnym, żadna para nie okazała się istotna. Rachunek krok po kroku znajdziesz w haśle test Kruskala-Wallisa, a pełny opis wyników – w przykładowym raporcie SZTOS.
Jak opisać wynik testu nieparametrycznego w pracy?
Podaj miarę położenia w grupach (medianę lub średnią rangę), statystykę testu, p i wielkość efektu – jak w zapisie APA powyżej. Oznaczenia statystyk: test U – U (przy dużych grupach także z), test Wilcoxona – T, test Kruskala-Wallisa – H(df), test Friedmana – χ²F(df), korelacja Spearmana – rs(df). W rozdziale o metodzie napisz też, dlaczego wybór padł na test nieparametryczny, np. „ze względu na porządkowy charakter zmiennej”.
Jak wykonać testy nieparametryczne w R?
# 1) dwie grupy: czas rozwiązania zadania (min); jedna osoba utknęła na 40 minut
z_podp   <- c(2, 3, 4, 5, 6, 8)
bez_podp <- c(7, 9, 10, 11, 12, 40)
shapiro.test(bez_podp)$p.value                 # rozkład daleki od normalnego
t.test(bez_podp, z_podp)$p.value               # test t Welcha
wilcox.test(z_podp, bez_podp)                  # test U (R nazywa U literą W)
effectsize::rank_biserial(bez_podp, z_podp)    # wielkość efektu r_rb

# 2) trzy grupy ćwiczeniowe: ANOVA a test Kruskala-Wallisa
punkty <- c(1, 3, 5,  2, 4, 6,  7, 8, 9)
grupa  <- factor(rep(c("A", "B", "C"), each = 3))
round(unlist(summary(aov(punkty ~ grupa))[[1]][1, c("F value", "Pr(>F)")]), 3)   # ANOVA
kruskal.test(punkty ~ grupa)
unname(rstatix::kruskal_effsize(data.frame(punkty, grupa), punkty ~ grupa)$effsize)   # eta2[H]
Wynik w konsoli R:
[1] 0.001128651
[1] 0.1025306

	Wilcoxon rank sum exact test

data:  z_podp and bez_podp
W = 1, p-value = 0.004329
alternative hypothesis: true location shift is not equal to 0

r (rank biserial) |       95% CI
--------------------------------
0.94              | [0.80, 0.99]
F value  Pr(>F)
  7.000   0.027

	Kruskal-Wallis rank sum test

data:  punkty by grupa
Kruskal-Wallis chi-squared = 5.6, df = 2, p-value = 0.06081

[1] 0.6
W teście U funkcja wilcox.test() nazywa statystykę literą W, ale przy takiej kolejności grup jest to dokładnie U. Przy remisach R zamiast dokładnego p podaje przybliżenie.
Najczęstsze błędy
- Pisanie, że test U lub Kruskala-Wallisa „porównuje mediany”.
- Wybór testu nieparametrycznego tylko dlatego, że próba jest mała.
- Podawanie średnich i odchyleń standardowych zamiast median lub średnich rang.
- Brak testu post hoc po istotnym wyniku testu Kruskala-Wallisa lub Friedmana.
- Pomijanie wielkości efektu (rrb, η²H, W Kendalla).
Bibliografia
- Mann, H. B., & Whitney, D. R. (1947). On a test of whether one of two random variables is stochastically larger than the other. The Annals of Mathematical Statistics, 18(1), 50–60. https://doi.org/10.1214/aoms/1177730491
- Kruskal, W. H., & Wallis, W. A. (1952). Use of ranks in one-criterion variance analysis. Journal of the American Statistical Association, 47(260), 583–621. https://doi.org/10.1080/01621459.1952.10483441
- Hodges, J. L., & Lehmann, E. L. (1956). The efficiency of some nonparametric competitors of the t-test. The Annals of Mathematical Statistics, 27(2), 324–335. https://doi.org/10.1214/aoms/1177728261
- Dunn, O. J. (1964). Multiple comparisons using rank sums. Technometrics, 6(3), 241–252. https://doi.org/10.1080/00401706.1964.10490181
- Hart, A. (2001). Mann-Whitney test is not just a test of medians: Differences in spread can be important. BMJ, 323(7309), 391–393. https://doi.org/10.1136/bmj.323.7309.391
- Divine, G. W., Norton, H. J., Barón, A. E., & Juarez-Colunga, E. (2018). The Wilcoxon–Mann–Whitney procedure fails as a test of medians. The American Statistician, 72(3), 278–286. https://doi.org/10.1080/00031305.2017.1305291
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówTest U Manna-Whitneya
- Słownik wzorówTest Wilcoxona
- Słownik wzorówTest Kruskala-Wallisa
- Słownik wzorówTest Friedmana
- PoradnikTesty parametryczne
- Przykładowy raportTest Kruskala-Wallisa
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.