

d Cohena – wzór, interpretacja i przykład
d Cohena to miara wielkości efektu: mówi, o ile odchyleń standardowych różnią się dwie średnie. Typowe pytanie z pracy dyplomowej (często zadawane przez recenzenta): „różnica jest istotna, ale czy jest duża?” – i właśnie na to odpowiada d.
W prostych słowachWartość p mówi, czy różnica może być przypadkiem. d mówi, jak duża jest ta różnica. d = 1 oznacza, że średnie dzieli jedno typowe odchylenie wyników, czyli tyle, ile zwykle różnią się od siebie osoby w tej samej grupie. Dzięki temu porównasz efekty z różnych badań, nawet gdy używano w nich innych skal.
Kiedy stosować d Cohena?
- porównujesz dwie średnie: po teście t dla prób niezależnych, dla prób zależnych albo dla jednej próby;
- chcesz pokazać, jak duża jest różnica, a nie tylko, że jest istotna;
- planujesz liczebność próby – d jest punktem wyjścia analizy mocy.
Przy trzech i więcej grupach zwykle podaje się eta kwadrat, a w tabelach krzyżowych – współczynnik phi lub V Cramera.
Wzór na d Cohena
- \(\bar{x}_1,\ \bar{x}_2\)
- średnie w grupie 1 i w grupie 2
- \(s_1^2,\ s_2^2\)
- wariancje w grupach
- \(s_p\)
- połączone (zbiorcze) odchylenie standardowe obu grup – „linijka”, którą mierzysz różnicę
- \(n_1,\ n_2\)
- liczba osób w każdej grupie
- \(g\)
- g Hedgesa – d pomniejszone tak, żeby w małych próbach nie zawyżało efektu (Hedges, 1981)
Dla prób zależnych nie ma jednego „d”. Najczęściej spotkasz \(d_z = \bar{d} / s_d\) (średnia różnic podzielona przez SD różnic) oraz \(d_{av}\) – średnia różnic podzielona przez średnią z SD obu pomiarów (Lakens, 2013). Dają różne wartości, więc w pracy zawsze napisz, którą wersję podajesz.
Przykład krok po kroku
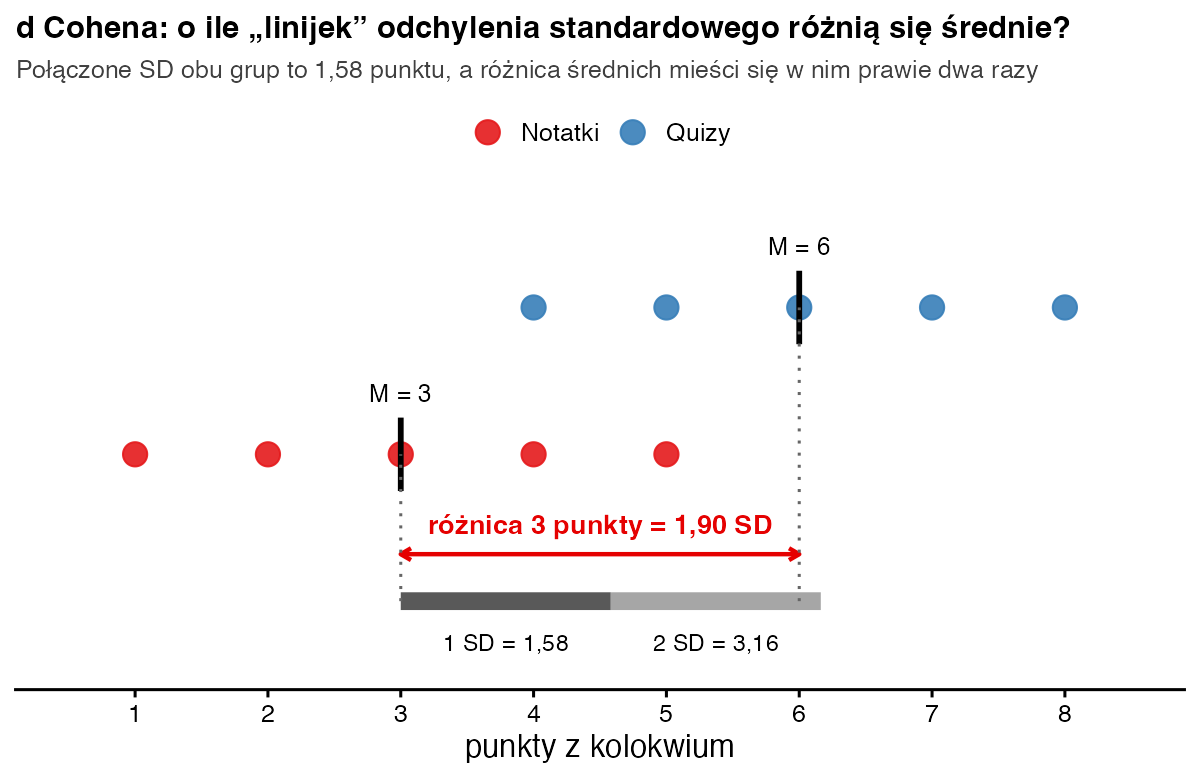
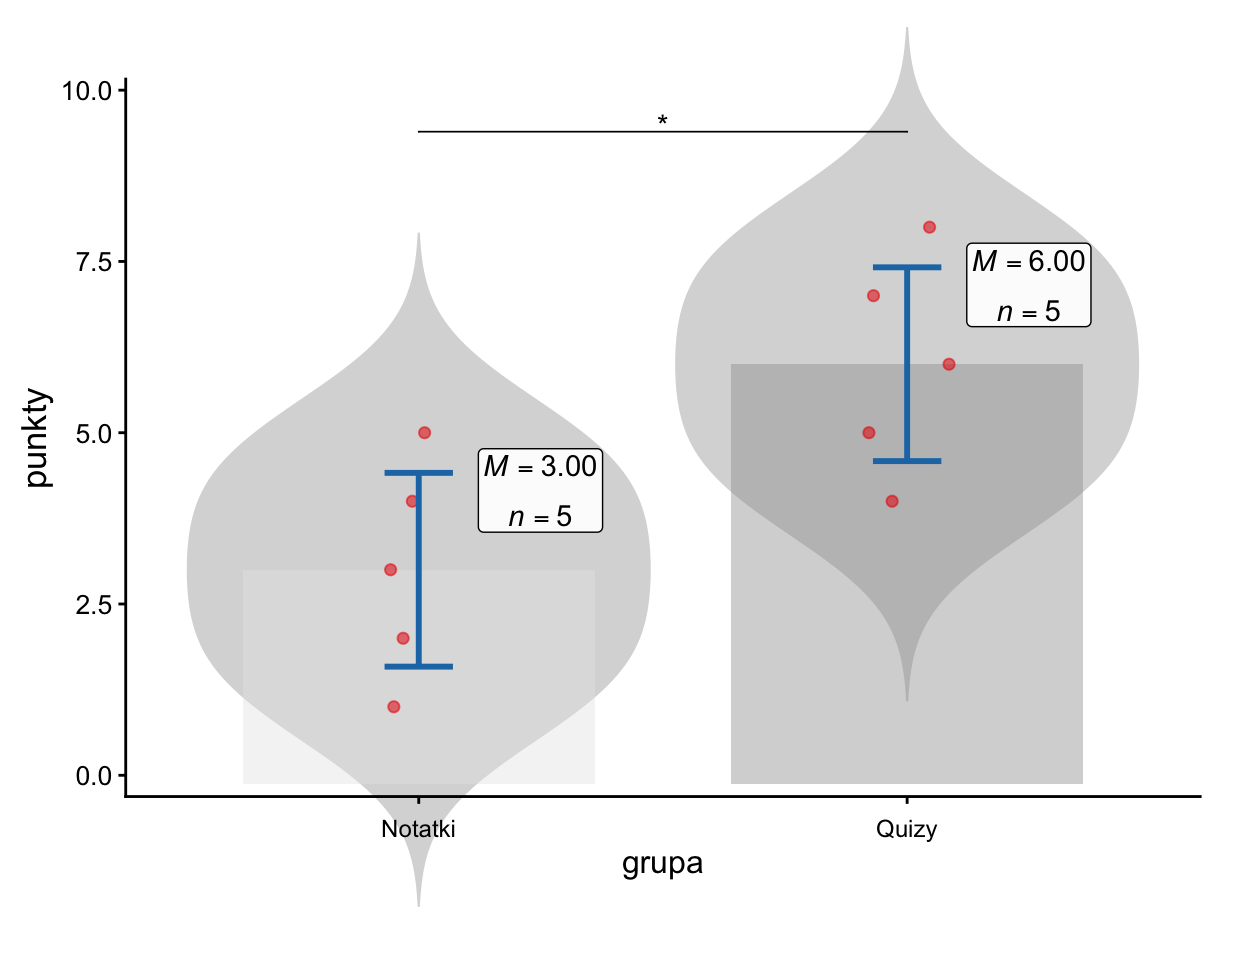
Bierzemy dane z hasła o teście t dla prób niezależnych: pięcioro studentów uczyło się z notatek (1, 2, 3, 4, 5 punktów), a pięcioro z quizów (4, 5, 6, 7, 8 punktów).
| Grupa | n | M | Σ(x − M)² | s² |
|---|---|---|---|---|
| Notatki | 5 | 3 | 10 | 2,5 |
| Quizy | 5 | 6 | 10 | 2,5 |
| Razem | 10 | różnica: 3 | 20 | \(s_p^2\) = 2,5 |
- Różnica średnich. 6 − 3 = 3 punkty.
- Połączone SD. \(s_p = \sqrt{(4 \cdot 2{,}5 + 4 \cdot 2{,}5) / 8} = \sqrt{2{,}5} \approx 1{,}58\).
- d Cohena. d = 3 / 1,58 ≈ 1,90. Kontrola przez wynik testu t: \(d = t\sqrt{1/n_1 + 1/n_2} = 3 \cdot \sqrt{0{,}4} \approx 1{,}90\).
- g Hedgesa. \(g = 1{,}897 \cdot (1 - 3/31) \approx 1{,}71\) (d bierzemy przed zaokrągleniem). Przy 10 osobach korekta zmniejsza efekt o mniej więcej 10%.
- Próby zależne. W danych z hasła o teście t dla prób zależnych średnia zmiana wynosi 3, SD różnic \(\sqrt{5} \approx 2{,}24\), a SD pomiarów 1,58 i 2,74. Stąd \(d_z = 3/2{,}24 \approx 1{,}34\), ale \(d_{av} = 3/2{,}16 \approx 1{,}39\).
Jak zinterpretować i opisać wynik?
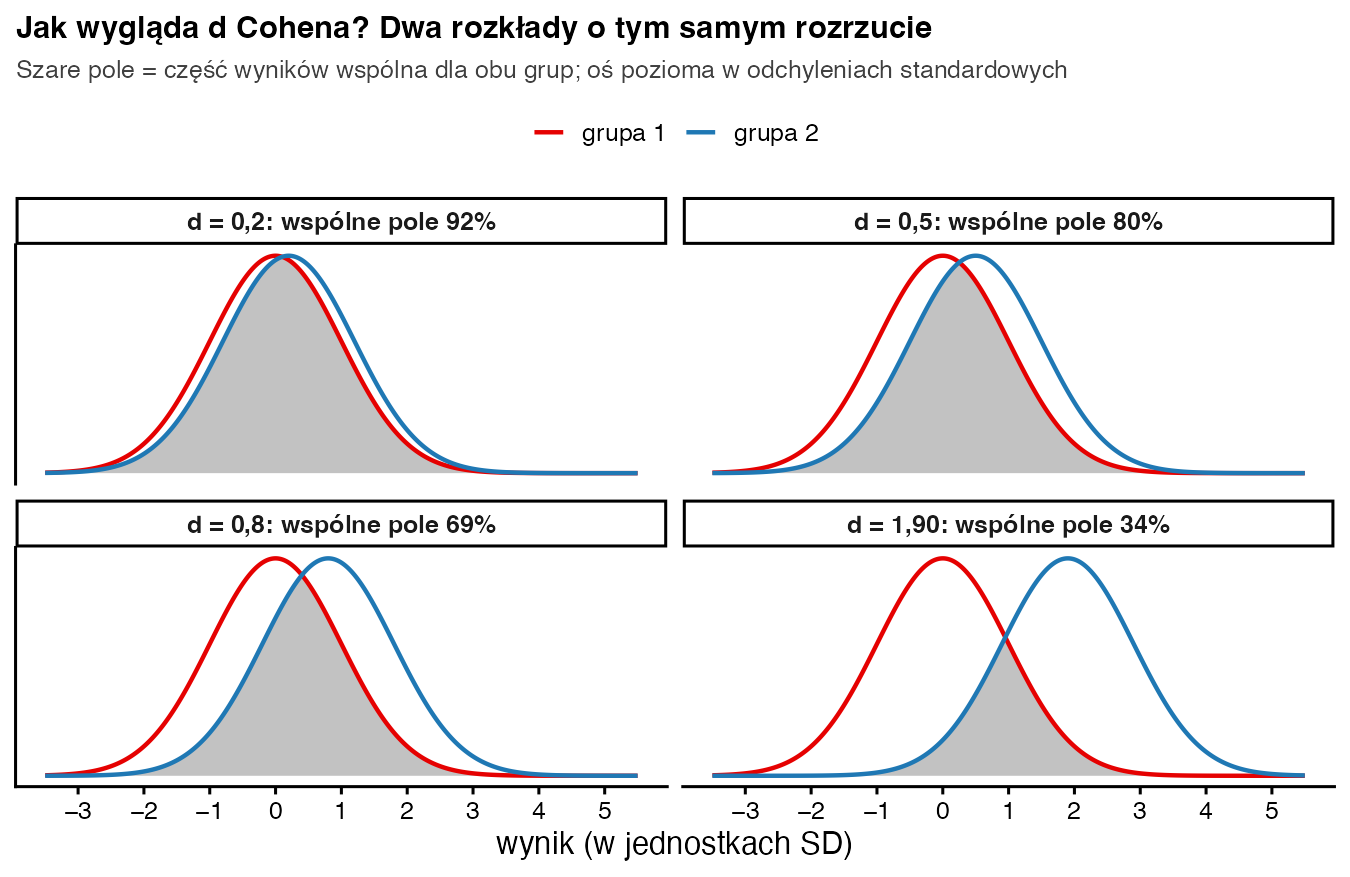
Według konwencji Cohena (1988) d około 0,2 to efekt mały, 0,5 – średni, a 0,8 – duży. Sam Cohen proponował te progi tylko na wypadek, gdy brakuje lepszych odniesień z danej dziedziny. Nasze d = 1,90 jest więc efektem dużym, wyraźnie powyżej progu 0,8. Przy pięciu osobach w grupie 95% przedział ufności dla d jest jednak bardzo szeroki: od 0,32 do 3,40. Dane pasują zarówno do efektu małego, jak i ogromnego.
Zapis w stylu APA: Studenci uczący się z quizów uzyskali istotnie więcej punktów (M = 6,00; SD = 1,58) niż studenci uczący się z notatek (M = 3,00; SD = 1,58), t(8) = 3,00; p = 0,017; d = 1,90; 95% CI [0,32; 3,40].
Jak policzyć d Cohena w R?
notatki <- c(1, 2, 3, 4, 5)
quizy   <- c(4, 5, 6, 7, 8)

# 1) „ręcznie”, dokładnie według wzoru
n1 <- length(quizy); n2 <- length(notatki)
s_p <- sqrt(((n1 - 1) * var(quizy) + (n2 - 1) * var(notatki)) / (n1 + n2 - 2))
d <- (mean(quizy) - mean(notatki)) / s_p
d                                        # 1.90
d * (1 - 3 / (4 * (n1 + n2) - 9))        # g Hedgesa: 1.71

# 2) pakiet effectsize: d i g z 95% przedziałem ufności
effectsize::cohens_d(quizy, notatki)
effectsize::hedges_g(quizy, notatki)

# 3) próby zależne: d_z (dane z hasła o teście t dla prób zależnych)
przed <- c(5, 3, 6, 4, 2); po <- c(7, 3, 9, 10, 6)
mean(po - przed) / sd(po - przed)        # d_z = 1.34
Wynik w konsoli R:
[1] 1.897367
[1] 1.71375
Cohen's d |       95% CI
------------------------
1.90      | [0.32, 3.40]

- Estimated using pooled SD.

Hedges' g |       95% CI
------------------------
1.71      | [0.29, 3.07]

- Estimated using pooled SD.

[1] 1.341641
Funkcje z pakietu effectsize od razu podają 95% przedział ufności. Dla prób zależnych pakiet ma funkcję repeated_measures_d() z kilkoma wersjami d – sprawdź w dokumentacji, którą liczy domyślnie.
Jaka wartość d Cohena jest „dobra”?
Nie ma jednej odpowiedzi. Progi 0,2, 0,5 i 0,8 to punkt wyjścia, a nie sztywna reguła. To samo d = 0,3 w jednej dziedzinie bywa sukcesem, a w innej – rozczarowaniem. Dlatego porównaj swój wynik z efektami z podobnych badań i podaj przedział ufności. Pamiętaj też, że małe d może mieć duże znaczenie praktyczne, jeśli dotyczy wielu osób albo taniej zmiany.
Najczęstsze błędy
- Mylenie d z istotnością: duże d nie gwarantuje p < 0,05 w małej próbie, a małe d bywa istotne w bardzo dużej.
- Traktowanie progów 0,2, 0,5 i 0,8 jak sztywnych granic.
- Liczenie d z SD tylko jednej grupy bez informacji o tym – to już inna miara (delta Glassa).
- Podawanie „d” dla prób zależnych bez wskazania wersji (dz, dav).
- Brak przedziału ufności dla d przy małej próbie.
Bibliografia
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Hedges, L. V. (1981). Distribution theory for Glass's estimator of effect size and related estimators. Journal of Educational Statistics, 6(2), 107–128. https://doi.org/10.3102/10769986006002107
- Lakens, D. (2013). Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs. Frontiers in Psychology, 4, 863. https://doi.org/10.3389/fpsyg.2013.00863
- Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówTest t Studenta dla prób niezależnych
- Słownik wzorówEta kwadrat (η²)
- Słownik wzorówIstotność statystyczna i wartość p
- PoradnikTest t Studenta – przykład
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
- Przykładowy raportTest t Studenta
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.