

Korelacja rang Spearmana – wzór i przykład
Współczynnik korelacji rang Spearmana (\(r_s\), często zapisywany jako ρ) mówi, na ile dwie zmienne układają się w ten sam porządek: czy osoby wysoko w jednym rankingu są też wysoko w drugim. Typowe pytanie z pracy dyplomowej: czy studenci, którzy wyżej oceniają zajęcia (skala 1–5), mają też wyższe oceny z egzaminu?
W prostych słowachZamiast surowych wyników bierzesz miejsca w szeregu: najmniejszy wynik dostaje rangę 1, następny 2 i tak dalej. Potem sprawdzasz, czy kolejność osób w obu zmiennych się zgadza. Pełna zgodność daje 1, odwrotna kolejność daje −1. Dzięki rangom jedna skrajna osoba ma znacznie mniejszy wpływ na wynik.
Kiedy stosować korelację Spearmana?
- zmienne są porządkowe (oceny 1–5, miejsca w rankingu, pojedyncze pytania ankiety) albo ilościowe;
- spodziewasz się związku monotonicznego („im więcej jednego, tym więcej drugiego”), niekoniecznie liniowego;
- w danych są obserwacje odstające albo rozkłady są mocno skośne.
Gdy obie zmienne są ilościowe, związek jest liniowy i nie ma wartości odstających, wybierz korelację Pearsona. Przy bardzo małej próbie i wielu remisach dobrą alternatywą jest tau Kendalla. Więcej o metodach opartych na rangach przeczytasz w artykule o testach nieparametrycznych.
Wzór na współczynnik korelacji Spearmana
- \(r_s\)
- współczynnik korelacji rang Spearmana, od −1 do 1
- \(d_i\)
- różnica rang i-tej osoby: ranga w zmiennej x minus ranga w zmiennej y
- \(n\)
- liczba osób (par wyników)
- remisy
- równe wyniki dostają średnią rangę (np. dwa wyniki na miejscach 2 i 3 dostają po 2,5); wtedy wzór z \(d_i^2\) jest tylko przybliżeniem i liczysz r Pearsona na rangach
Przykład krok po kroku
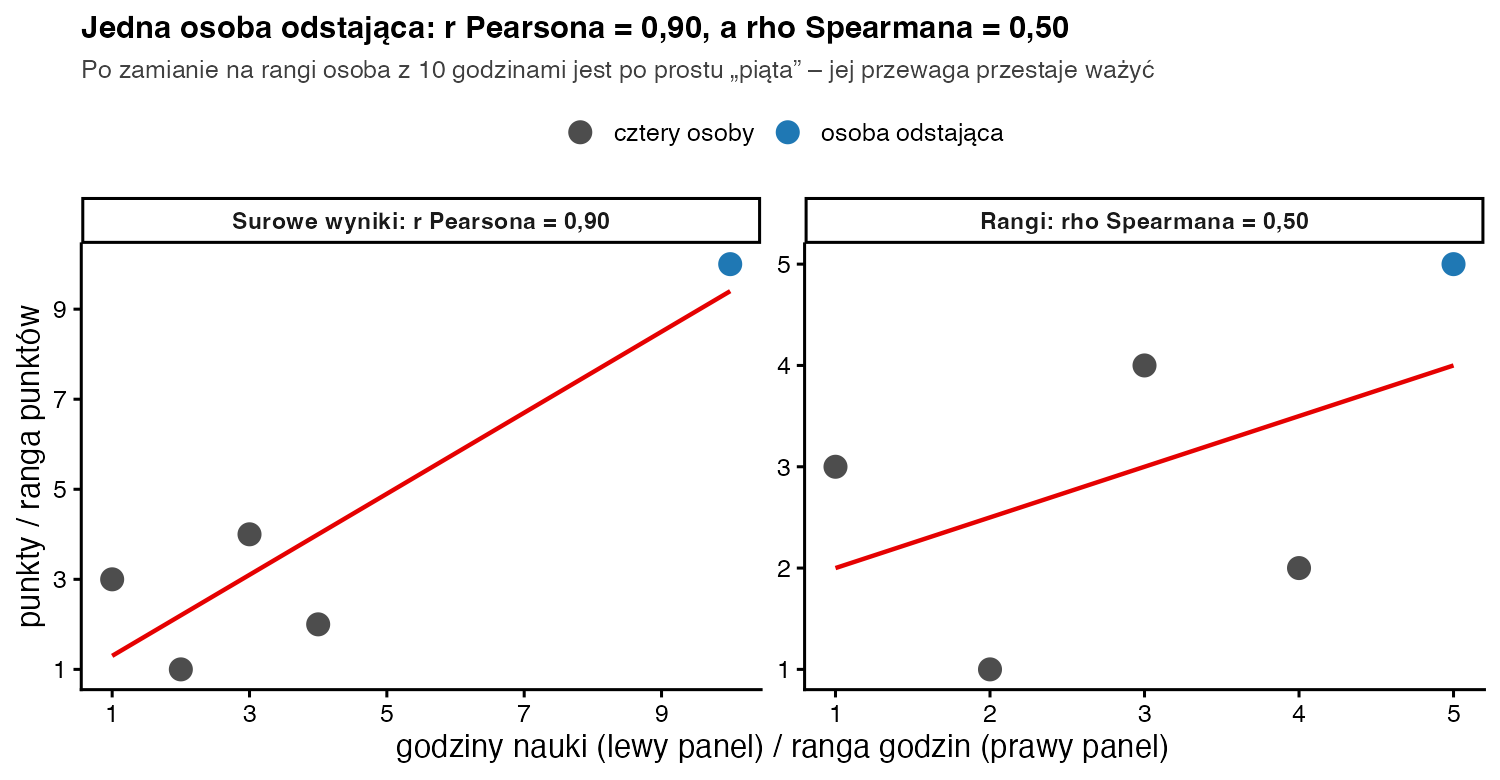
Pięcioro studentów zapisało, ile godzin uczyło się do kolokwium i ile punktów zdobyło. Czworo uczyło się od 1 do 4 godzin, a jedna osoba – aż 10 godzin, i zdobyła 10 punktów.
| Osoba | Godziny x | Punkty y | Ranga x | Ranga y | d | d² |
|---|---|---|---|---|---|---|
| 1 | 1 | 3 | 1 | 3 | −2 | 4 |
| 2 | 2 | 1 | 2 | 1 | 1 | 1 |
| 3 | 3 | 4 | 3 | 4 | −1 | 1 |
| 4 | 4 | 2 | 4 | 2 | 2 | 4 |
| 5 | 10 | 10 | 5 | 5 | 0 | 0 |
| Σ = 15 | Σ = 15 | 0 | 10 |
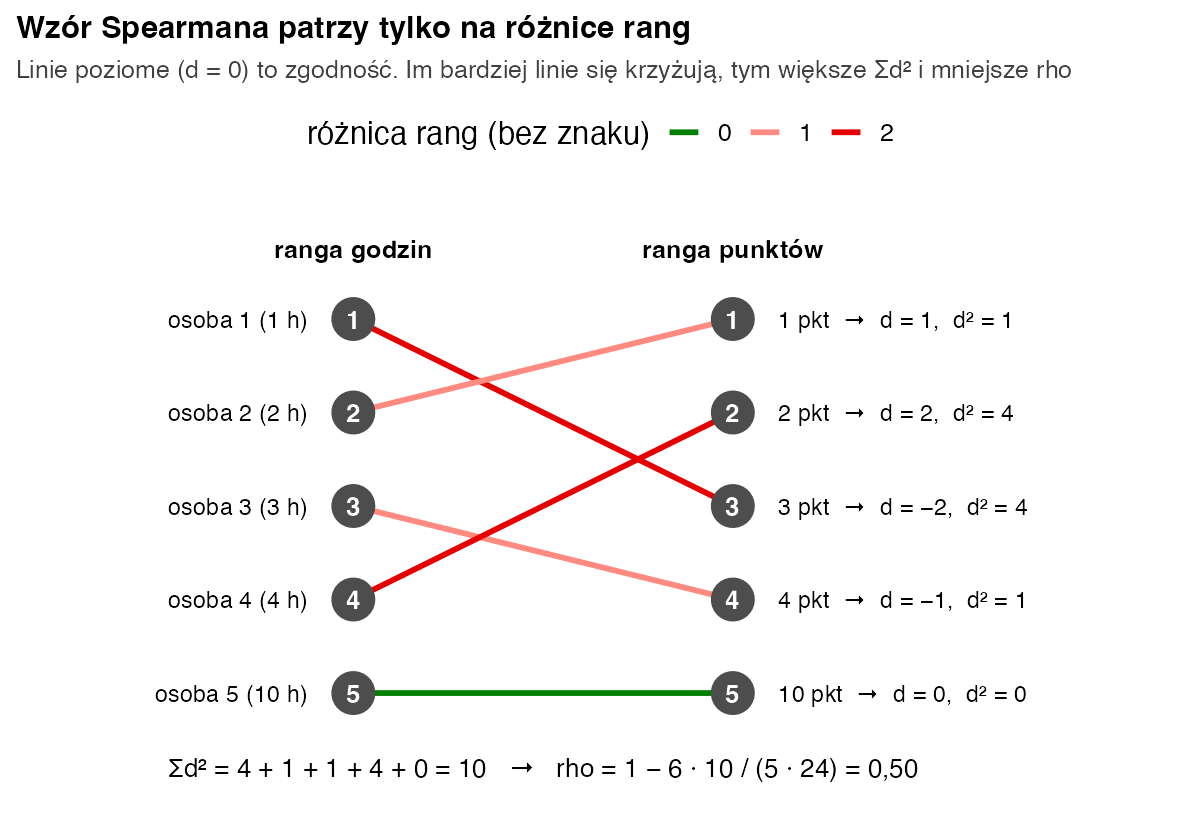
- Rangi. W każdej zmiennej osobno nadaj rangi od 1 (najmniej) do 5 (najwięcej). Remisów nie ma, więc wolno użyć krótkiego wzoru.
- Różnice rang. d = ranga x − ranga y. Kontrola: różnice sumują się do zera.
- Suma kwadratów różnic. Σd² = 4 + 1 + 1 + 4 + 0 = 10.
- Współczynnik. \(r_s = 1 - 6 \cdot 10 / (5 \cdot 24) = 1 - 60/120 = 0{,}50\).
- Istotność. Przy n = 5 dokładna wartość p wynosi 0,450 – wynik nieistotny.
- Porównanie z Pearsonem. Na surowych wynikach r = 0,90 i p = 0,037. Różnicę robi osoba z 10 godzinami: bez niej oba współczynniki wynoszą dokładnie 0.
Jak zinterpretować i opisać wynik?
\(r_s\) czytasz podobnie jak r: znak to kierunek, a wartość bez znaku to siła związku monotonicznego. Umownie stosuje się te same progi co dla r: 0,1 – związek słaby, 0,3 – umiarkowany, 0,5 – silny (Cohen, 1988). Wartość p mówi, jak często przy braku związku w populacji dostalibyśmy \(r_s\) co najmniej tak odległe od zera. Tu p = 0,450, więc brak podstaw do odrzucenia H0. Pięć osób to jednak za mało, żeby wykluczyć związek.
Zapis w stylu APA: Liczba godzin nauki była dodatnio, ale nieistotnie skorelowana z liczbą punktów z kolokwium, rs(3) = 0,50; p = 0,450. Współczynnik Pearsona dla tych danych (r = 0,90) wynikał z jednej obserwacji odstającej.
Jak policzyć korelację Spearmana w R?
godziny <- c(1, 2, 3, 4, 10)
punkty  <- c(3, 1, 4, 2, 10)

# 1) „ręcznie”: rangi, różnice rang i wzór (dane bez remisów)
d <- rank(godziny) - rank(punkty)
d
1 - 6 * sum(d^2) / (5 * (5^2 - 1))           # 0.5

# 2) definicja: korelacja Pearsona policzona na rangach (działa też przy remisach)
cor(rank(godziny), rank(punkty))

# 3) gotową funkcją (przy n < 10 i braku remisów R liczy dokładne p)
cor.test(godziny, punkty, method = "spearman")

# 4) dla porównania: Pearson na surowych wynikach
cor(godziny, punkty)
Wynik w konsoli R:
[1] -2  1 -1  2  0
[1] 0.5
[1] 0.5

	Spearman's rank correlation rho

data:  godziny and punkty
S = 10, p-value = 0.45
alternative hypothesis: true rho is not equal to 0
sample estimates:
rho
0.5

[1] 0.9
Statystyka S = 10 w wydruku to właśnie Σd². Przy remisach R zgłosi, że nie może policzyć dokładnego p, i poda przybliżenie. Opis wyników na większej próbie znajdziesz we wpisie korelacja Spearmana – przykład.
Spearman czy Pearson – którą korelację wybrać?
Zacznij od wykresu rozrzutu. Jeśli punkty układają się wzdłuż prostej i nie ma wartości odstających, wybierz Pearsona – ma wtedy nieco większą moc. Jeśli zmienne są porządkowe, związek jest „rosnący, ale zakrzywiony” albo pojedyncze osoby mocno odstają, wybierz Spearmana. Gdy dane nie mają takich problemów, oba współczynniki są zbliżone: dla danych z hasła o korelacji Pearsona oba wynoszą 0,80. Decyzję podejmij przed liczeniem, a nie po porównaniu wartości p.
Najczęstsze błędy
- Używanie wzoru z Σd² przy remisach (typowych dla skal 1–5) zamiast korelacji Pearsona na rangach.
- Pisanie „brak związku”, gdy \(r_s\) ≈ 0. Poprawnie: brak związku monotonicznego – zależność w kształcie litery U może dać zero.
- Wybieranie Pearsona albo Spearmana po tym, który daje „lepsze” p.
- Wnioskowanie o przyczynie na podstawie samej korelacji.
- Traktowanie Spearmana jak testu bez założeń – nadal wymaga niezależnych obserwacji.
Bibliografia
- Spearman, C. (1904). The proof and measurement of association between two things. The American Journal of Psychology, 15(1), 72–101. https://doi.org/10.2307/1412159
- de Winter, J. C. F., Gosling, S. D., & Potter, J. (2016). Comparing the Pearson and Spearman correlation coefficients across distributions and sample sizes: A tutorial using simulations and empirical data. Psychological Methods, 21(3), 273–290.
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówKorelacja Pearsona
- Słownik wzorówTau Kendalla
- Słownik wzorówTest U Manna-Whitneya
- PoradnikKorelacja Spearmana – przykład
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
- Przykładowy raportAnaliza korelacji
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.