

Współczynnik korelacji r Pearsona – wzór i przykład
Korelacja Pearsona mówi, na ile dwie zmienne ilościowe układają się wzdłuż prostej linii. Przykładowe pytanie z pracy dyplomowej: czy studenci, którzy uczą się dłużej, zdobywają więcej punktów z kolokwium?
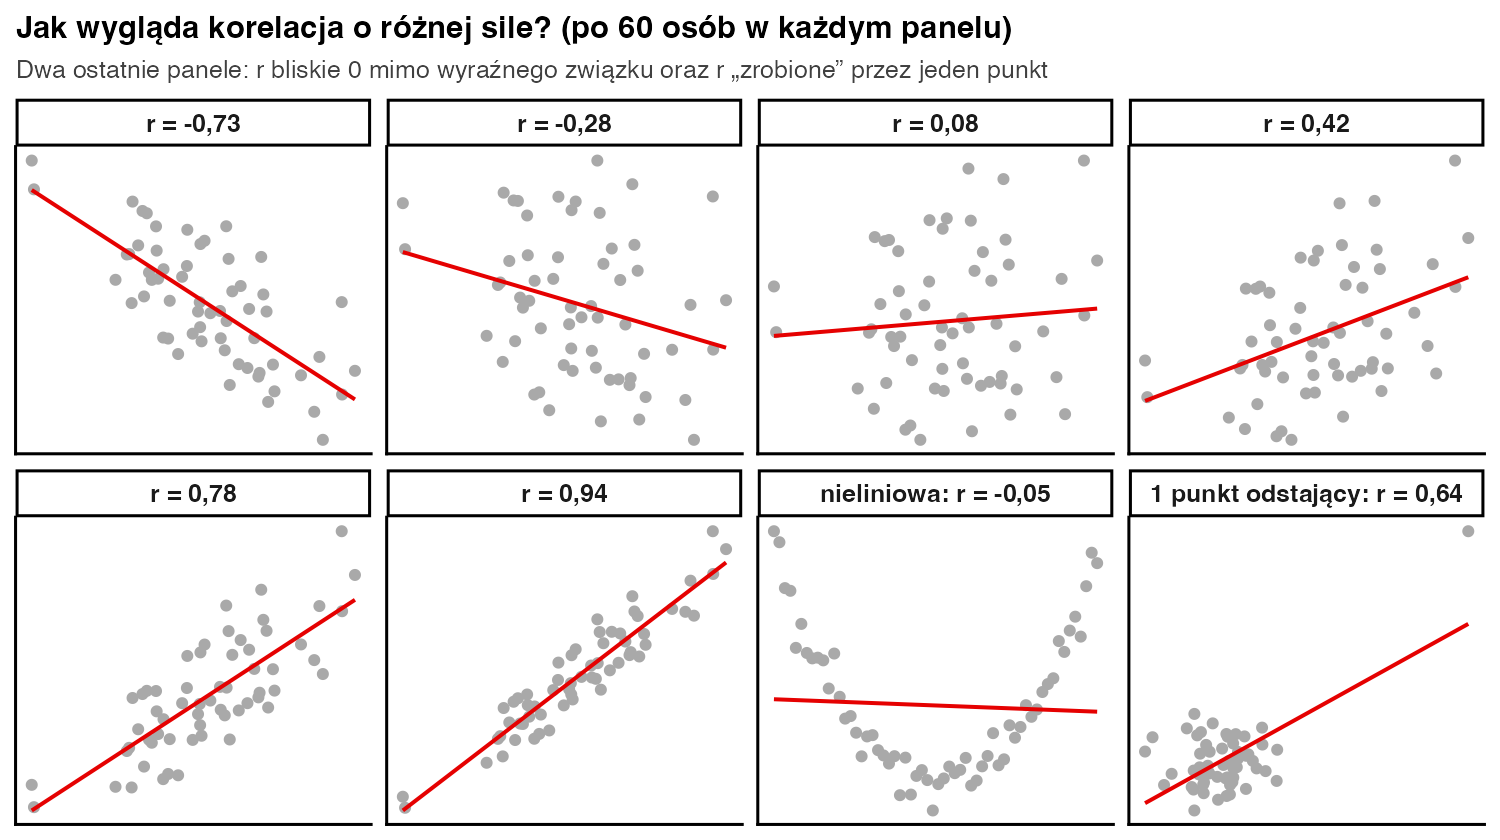
W prostych słowachr przyjmuje wartości od −1 do 1. Znak mówi o kierunku: plus – „im więcej jednego, tym więcej drugiego”, minus – „im więcej jednego, tym mniej drugiego”. Wartość bez znaku mówi o sile: im bliżej 1, tym ciaśniej punkty leżą przy prostej. r = 0 oznacza brak związku liniowego, ale nie zawsze brak jakiegokolwiek związku.
Kiedy stosować korelację Pearsona?
- obie zmienne są ilościowe (godziny, punkty, wiek, wynik skali);
- związek jest w przybliżeniu liniowy – sprawdź to zawsze na wykresie rozrzutu;
- nie ma silnych obserwacji odstających, a do testu istotności rozkłady obu zmiennych są zbliżone do normalnego.
Gdy masz dane porządkowe (np. pojedyncze pytania na skali 1–5), obserwacje odstające albo związek tylko „rosnący”, a nie liniowy, wybierz korelację Spearmana lub tau Kendalla.
Wzór na współczynnik korelacji Pearsona
- \(x_i,\ y_i\)
- wyniki i-tej osoby w obu zmiennych (np. godziny nauki i punkty)
- \(\bar{x},\ \bar{y}\)
- średnie obu zmiennych
- licznik
- suma iloczynów odchyleń: jest duża i dodatnia, gdy wysokie x idą w parze z wysokim y
- mianownik
- „skaluje” wynik tak, żeby zawsze wypadł między −1 a 1
- \(t,\ df\)
- statystyka testu istotności korelacji i jej stopnie swobody
Przykład krok po kroku
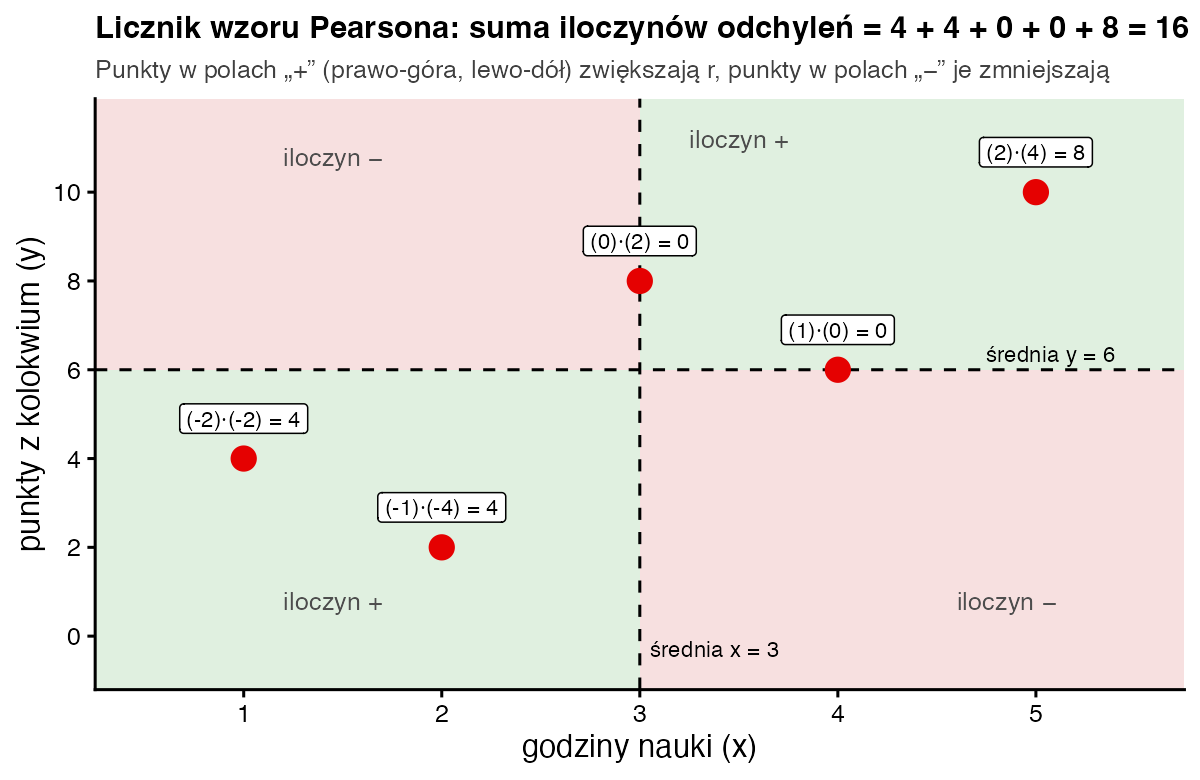
Pięcioro studentów zapisało, ile godzin uczyło się do kolokwium (x) i ile punktów zdobyło (y). Średnio uczyli się 3 godziny i zdobyli 6 punktów.
| x | y | x − 3 | y − 6 | (x − 3)(y − 6) | (x − 3)² | (y − 6)² |
|---|---|---|---|---|---|---|
| 1 | 4 | −2 | −2 | 4 | 4 | 4 |
| 2 | 2 | −1 | −4 | 4 | 1 | 16 |
| 3 | 8 | 0 | 2 | 0 | 0 | 4 |
| 4 | 6 | 1 | 0 | 0 | 1 | 0 |
| 5 | 10 | 2 | 4 | 8 | 4 | 16 |
| Σ = 15 | Σ = 30 | 0 | 0 | 16 | 10 | 40 |
- Średnie. \(\bar{x} = 15/5 = 3\), \(\bar{y} = 30/5 = 6\).
- Licznik. Suma iloczynów odchyleń: 4 + 4 + 0 + 0 + 8 = 16.
- Mianownik. \(\sqrt{10 \cdot 40} = \sqrt{400} = 20\).
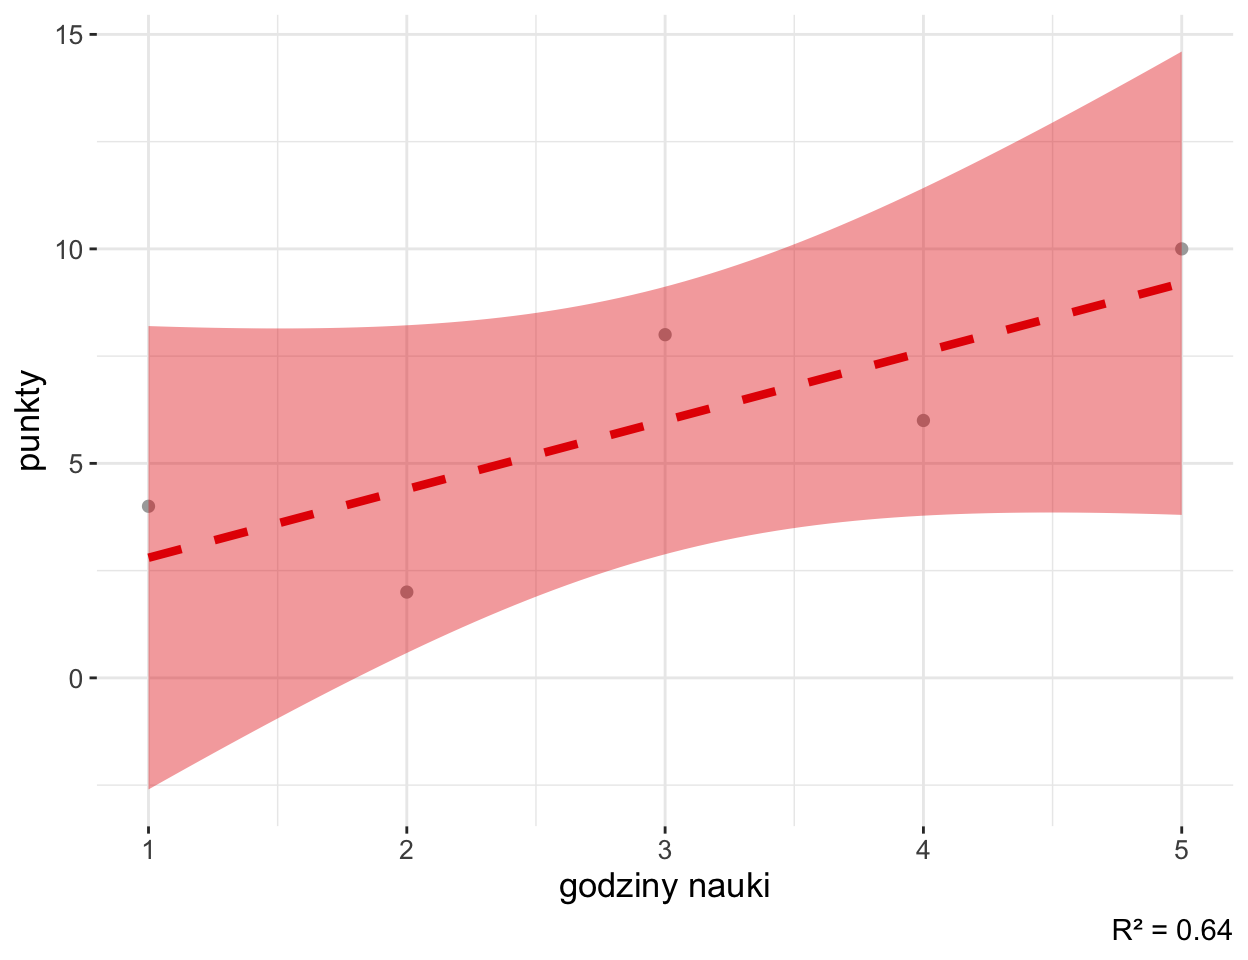
- Korelacja. r = 16 / 20 = 0,80 – silny związek dodatni. r² = 0,64, czyli 64% zmienności punktów „idzie w parze” z liczbą godzin nauki.
- Istotność. \(t = 0{,}8 \cdot \sqrt{3} / \sqrt{0{,}36} = 2{,}31\), df = 3, p = 0,104. Wynik nie jest istotny statystycznie.
Ostatni krok to ważna lekcja. Związek jest silny, ale pięć osób to za mało, żeby wykluczyć przypadek. Ta sama korelacja r = 0,80 u ośmiu osób dałaby już p = 0,017.
Jak zinterpretować i opisać wynik?
Według popularnej konwencji wartości |r| około 0,1 to związek słaby, 0,3 – umiarkowany, a 0,5 i więcej – silny (Cohen, 1988). Zawsze podawaj też przedział ufności. Tutaj wynosi on od −0,28 do 0,99, więc dane pasują zarówno do braku związku, jak i do związku bardzo silnego. Korelacja nie dowodzi też przyczynowości. Być może to zdolniejsze osoby i uczą się dłużej, i lepiej piszą kolokwium.
Zapis w stylu APA: Liczba godzin nauki była dodatnio skorelowana z liczbą punktów z kolokwium, r(3) = 0,80; 95% CI [−0,28; 0,99]; p = 0,104. Przy tak małej próbie związek nie okazał się istotny statystycznie.
Jak policzyć korelację Pearsona w R?
godziny <- c(1, 2, 3, 4, 5)
punkty  <- c(4, 2, 8, 6, 10)

# 1) „ręcznie”, dokładnie według wzoru
dx <- godziny - mean(godziny)
dy <- punkty - mean(punkty)
sum(dx * dy) / sqrt(sum(dx^2) * sum(dy^2))   # 0.8

# 2) gotowymi funkcjami
cor(godziny, punkty)
cor.test(godziny, punkty)
Wynik w konsoli R:
	Pearson's product-moment correlation

data:  godziny and punkty
t = 2.3094, df = 3, p-value = 0.1041
alternative hypothesis: true correlation is not equal to 0
95 percent confidence interval:
 -0.2796400  0.9861962
sample estimates:
cor
0.8
Chcesz od razu przejść do regresji liniowej? Współczynnik nachylenia prostej to \(b = 16/10 = 1{,}6\) punktu na każdą dodatkową godzinę nauki.
Korelacja a regresja – czym się różnią?
Korelacja odpowiada na pytanie „jak silnie dwie zmienne idą w parze?” i traktuje je symetrycznie: r między godzinami a punktami jest takie samo jak między punktami a godzinami. Regresja odpowiada na pytanie „o ile średnio zmieni się y, gdy x wzrośnie o jednostkę?” i wyróżnia zmienną wyjaśnianą. W prostym modelu z jednym predyktorem oba podejścia są ze sobą powiązane: kwadrat korelacji to R² modelu regresji.
Najczęstsze błędy
- Liczenie r bez spojrzenia na wykres rozrzutu – identyczne r mogą opisywać zupełnie różne dane.
- Pisanie „brak związku”, gdy r ≈ 0. Poprawnie: „brak związku liniowego”.
- Wnioskowanie o przyczynie („nauka powoduje lepsze wyniki”) na podstawie samej korelacji.
- Liczenie Pearsona dla pojedynczych pytań na skali 1–5 zamiast Spearmana.
- Podawanie samego p bez wartości r i przedziału ufności.
Bibliografia
- Pearson, K. (1895). Notes on regression and inheritance in the case of two parents. Proceedings of the Royal Society of London, 58, 240–242. https://doi.org/10.1098/rspl.1895.0041
- Anscombe, F. J. (1973). Graphs in statistical analysis. The American Statistician, 27(1), 17–21. https://doi.org/10.1080/00031305.1973.10478966
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Field, A., Miles, J., & Field, Z. (2012). Discovering statistics using R. SAGE.
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówKorelacja Spearmana
- Słownik wzorówRegresja liniowa
- Słownik wzorówTau Kendalla
- Słownik wzorówOdchylenie standardowe
- PoradnikKorelacja Pearsona – przykład
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
- Przykładowy raportAnaliza korelacji
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.