

Test t dla jednej próby – wzór i przykład
Test t dla jednej próby sprawdza, czy średnia w Twojej grupie różni się od z góry ustalonej wartości: normy, zalecenia albo środka skali. Typowe pytanie z pracy dyplomowej: czy studenci przed kolokwium śpią średnio mniej niż zalecane 7 godzin?
W prostych słowachOdejmujesz wartość odniesienia od średniej z próby i sprawdzasz, ile to „błędów standardowych”. Błąd standardowy mówi, o ile średnia mogłaby się zmienić, gdybyś zbadał inne osoby. Jeśli różnica jest kilka razy większa od tego błędu, trudno uznać ją za przypadek.
Kiedy stosować test t dla jednej próby?
- masz jedną grupę i jedną zmienną ilościową (godziny, punkty, wynik skali);
- wartość odniesienia \(\mu_0\) ustalasz przed badaniem: norma testu, zalecenie (7 h snu), środek skali (3 na skali 1–5);
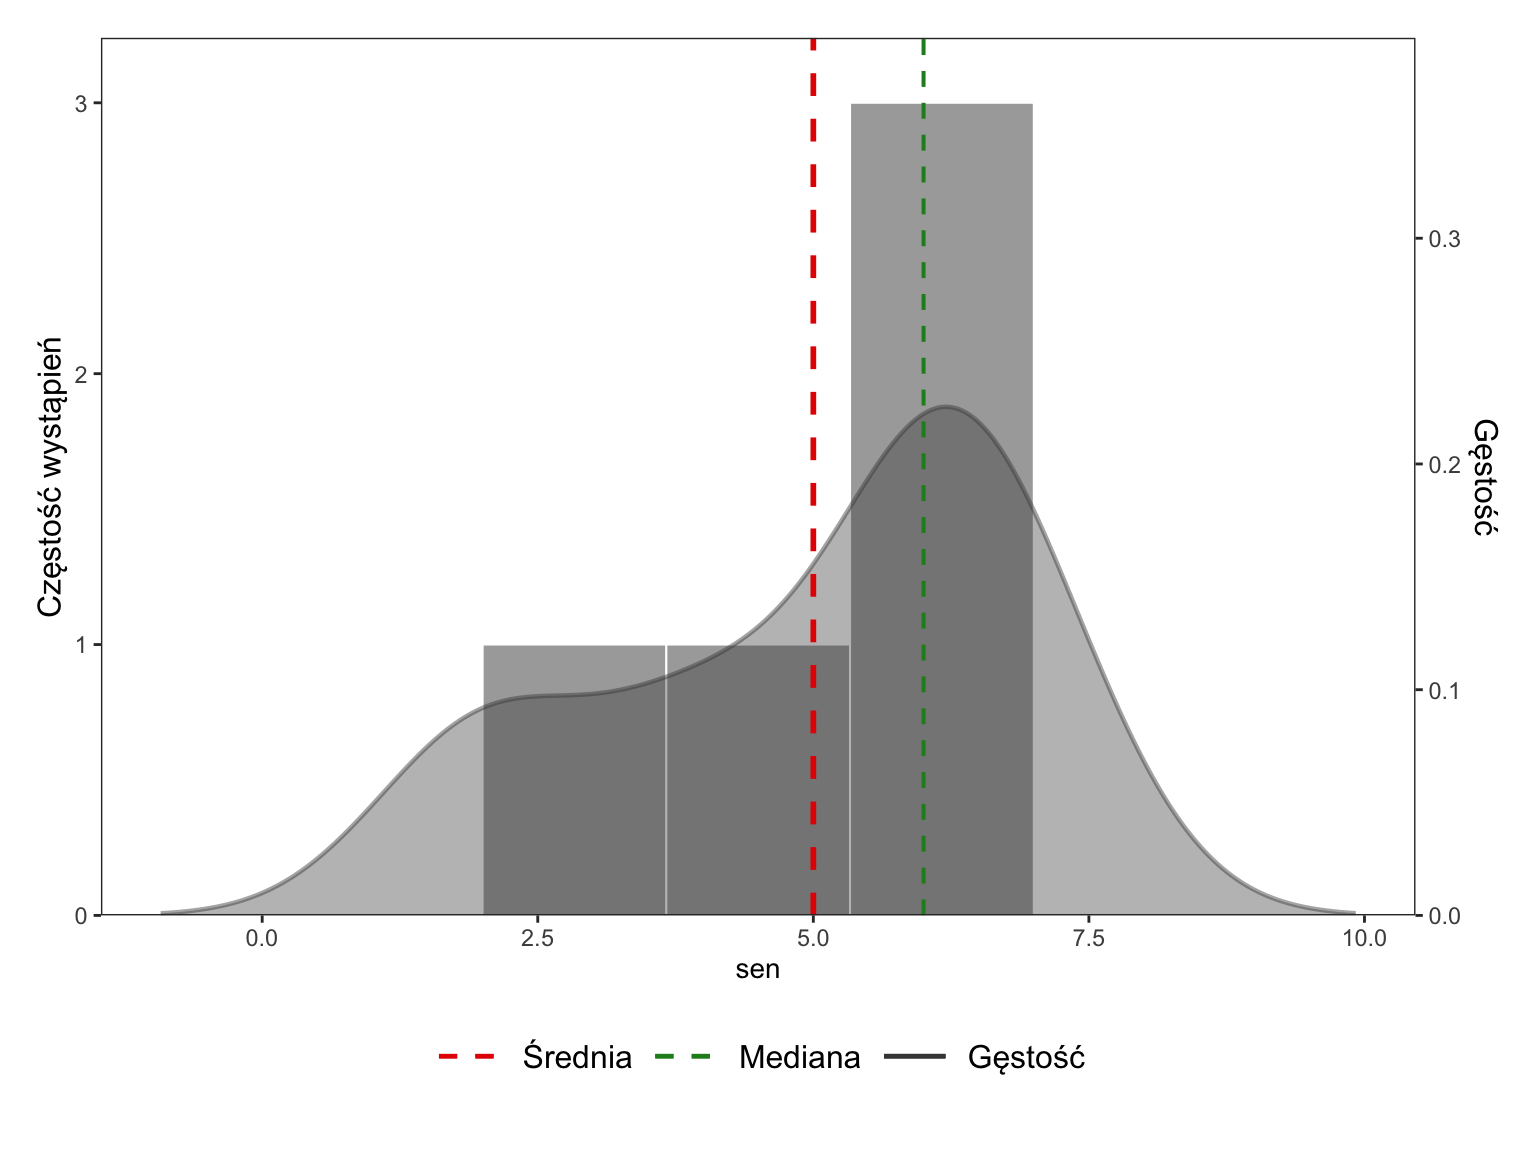
- wyniki są niezależne, a ich rozkład jest zbliżony do normalnego – przy małej próbie sprawdź to na wykresie lub testem Shapiro-Wilka.
Dwie grupy różnych osób porównasz testem t dla prób niezależnych, a dwa pomiary tych samych osób – testem t dla prób zależnych. Przy wyraźnie skośnych wynikach rozważ wersję testu Wilcoxona dla jednej próby.
Wzór na test t dla jednej próby
- \(\bar{x}\)
- średnia w próbie
- \(\mu_0\)
- wartość odniesienia z hipotezy zerowej (tu 7 h)
- \(s\)
- odchylenie standardowe w próbie
- \(n\)
- liczba osób
- \(s / \sqrt{n}\)
- błąd standardowy średniej (SE)
- \(df\)
- stopnie swobody – potrzebne, żeby odczytać wartość p
- \(d\)
- d Cohena: różnica wyrażona w odchyleniach standardowych
Przykład krok po kroku
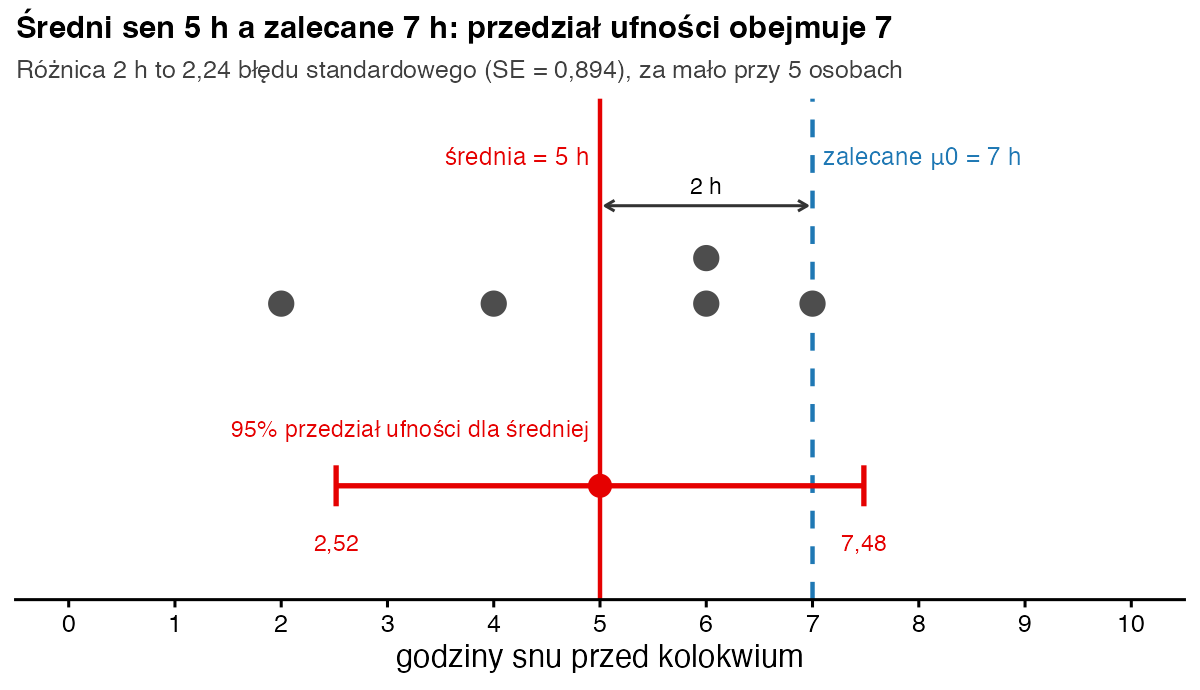
Pięcioro studentów zapisało, ile godzin spało w noc przed kolokwium: 6, 2, 7, 4 i 6. Wartość odniesienia to zalecane 7 godzin.
| Sen x (h) | x − 5 | (x − 5)² |
|---|---|---|
| 6 | 1 | 1 |
| 2 | −3 | 9 |
| 7 | 2 | 4 |
| 4 | −1 | 1 |
| 6 | 1 | 1 |
| Σ = 25 | 0 | 16 |
- Średnia. \(\bar{x} = 25 / 5 = 5\) h.
- Odchylenie standardowe. \(s = \sqrt{16 / 4} = 2\) h.
- Błąd standardowy. \(SE = 2 / \sqrt{5} \approx 0{,}894\).
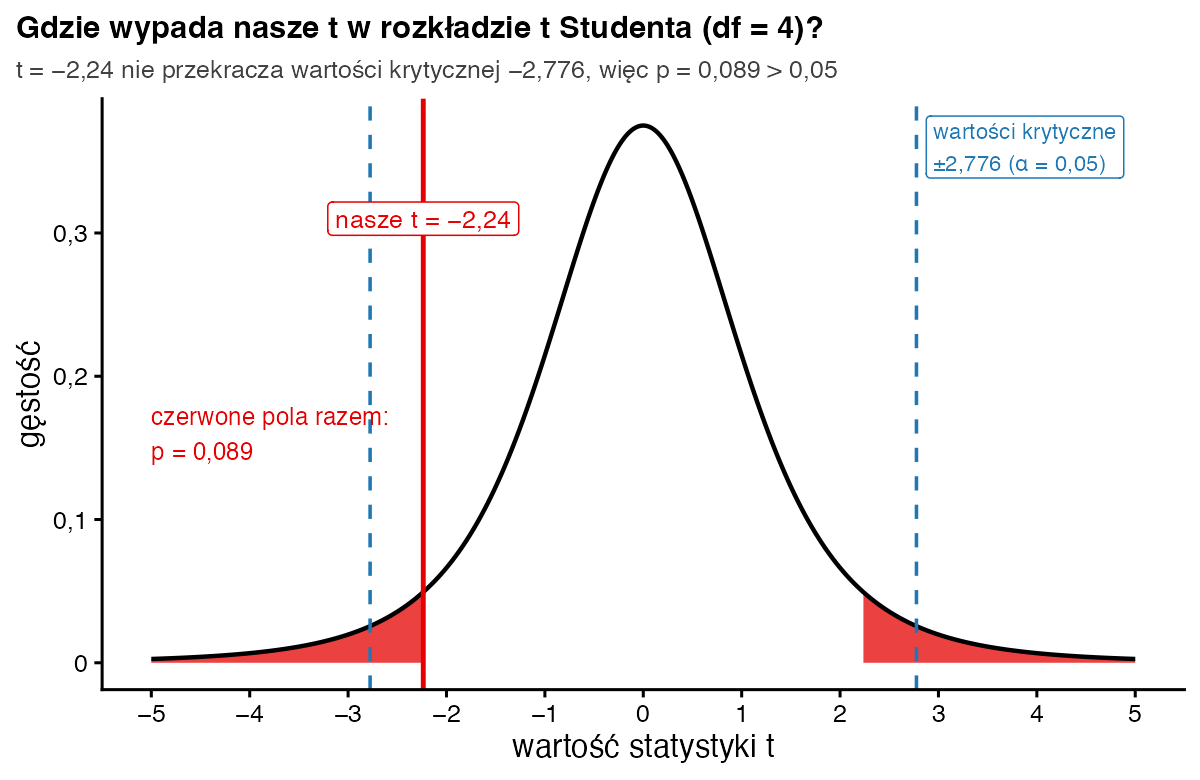
- Statystyka t. \(t = (5 - 7) / 0{,}894 \approx -2{,}24\); df = 5 − 1 = 4.
- Wartość p. Program podaje p = 0,089 (test dwustronny). Wartość krytyczna dla df = 4 to ±2,776, a |−2,24| jest od niej mniejsze – wynik nie jest istotny statystycznie.
- Przedział ufności. \(5 \pm 2{,}776 \cdot 0{,}894\), czyli od 2,52 do 7,48 h. Przedział obejmuje 7 h.
- Wielkość efektu. d = (5 − 7) / 2 = −1,00.
Jak zinterpretować i opisać wynik?
Studenci spali średnio o 2 godziny krócej niż zalecane. Według konwencji Cohena (1988) |d| ≥ 0,8 to efekt duży, więc d = −1,00 opisuje dużą różnicę. Mimo to p = 0,089, czyli brak podstaw do odrzucenia hipotezy zerowej. Nie dowodzi to, że studenci śpią „tyle, ile trzeba”. Przedział ufności od 2,5 do 7,5 h pasuje zarówno do poważnego niedoboru snu, jak i do braku różnicy. Pięć osób to po prostu za mało, żeby wykryć nawet duży efekt – o tym mówi moc testu.
Zapis w stylu APA: Studenci spali przed kolokwium średnio 5,00 h (SD = 2,00), czyli mniej niż zalecane 7 h, jednak różnica nie była istotna statystycznie, t(4) = −2,24; p = 0,089; d = −1,00; 95% CI [2,52; 7,48].
Jak policzyć test t dla jednej próby w R?
sen <- c(6, 2, 7, 4, 6)    # godziny snu przed kolokwium
mu0 <- 7                   # zalecana liczba godzin

# 1) „ręcznie”, dokładnie według wzoru
se <- sd(sen) / sqrt(length(sen))           # 0.894
t <- (mean(sen) - mu0) / se
t                                           # -2.24
2 * pt(-abs(t), df = length(sen) - 1)       # p = 0.089

# 2) gotową funkcją (dodatkowo 95% przedział ufności)
t.test(sen, mu = mu0)

# 3) wielkość efektu d Cohena
effectsize::cohens_d(sen, mu = mu0)
Wynik w konsoli R:
[1] -2.236068
[1] 0.08900934

	One Sample t-test

data:  sen
t = -2.2361, df = 4, p-value = 0.08901
alternative hypothesis: true mean is not equal to 7
95 percent confidence interval:
 2.516672 7.483328
sample estimates:
mean of x
        5

Cohen's d |        95% CI
-------------------------
-1        | [-2.07, 0.14]

- Deviation from a difference of 7.
Argument mu to wartość odniesienia. Bez niego R porówna średnią z zerem, co rzadko ma sens.
Test jednostronny czy dwustronny?
Pytanie brzmiało „czy studenci śpią mniej niż 7 h?”, więc kusi test jednostronny. Dla naszych danych daje on p = 0,045, czyli wynik „istotny”. Taki test jest jednak uczciwy tylko wtedy, gdy kierunek hipotezy zapisałeś przed zebraniem danych i wynik w przeciwną stronę nie miałby dla Ciebie znaczenia. Zmiana testu na jednostronny dopiero wtedy, gdy dwustronny „nie wyszedł”, to błąd, który recenzenci szybko zauważają.
Najczęstsze błędy
- Wybór wartości odniesienia μ0 po obejrzeniu danych.
- Przejście na test jednostronny tylko po to, żeby uzyskać p < 0,05.
- Pisanie „brak różnicy” albo „przyjęto H0”, gdy p > 0,05.
- Użycie testu dla jednej próby do porównania dwóch grup – to inny test.
- Podawanie samego p bez średniej, SD, przedziału ufności i d.
Bibliografia
- Student. (1908). The probable error of a mean. Biometrika, 6(1), 1–25. https://doi.org/10.1093/biomet/6.1.1
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Field, A., Miles, J., & Field, Z. (2012). Discovering statistics using R. SAGE.
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówTest t Studenta dla prób niezależnych
- Słownik wzorówPrzedział ufności dla średniej
- Słownik wzorówBłąd standardowy średniej
- PoradnikTest t Studenta – przykład
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
- Przykładowy raportTest t Studenta
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.