

Statystyka opisowa – wzory w pigułce
Statystyka opisowa streszcza dane kilkoma liczbami: gdzie leży typowy wynik, jak bardzo wyniki się różnią i jaki kształt ma ich rozkład. Typowe zadanie w pracy dyplomowej: przygotować tabelę ze średnią, odchyleniem standardowym i medianą dla każdej zmiennej.
W prostych słowachŚrednia, mediana i moda mówią, gdzie jest „środek” danych. Rozstęp, wariancja, odchylenie standardowe i kwartyle – jak daleko od środka leżą wyniki. Skośność i kurtoza opisują kształt rozkładu. Poniżej znajdziesz wszystkie wzory i jeden przykład, w którym liczymy je na tych samych pięciu liczbach.
Kiedy które miary?
- zmienna ilościowa o rozkładzie zbliżonym do symetrycznego – średnia i odchylenie standardowe;
- rozkład skośny albo wyniki odstające – mediana i rozstęp międzykwartylowy;
- zmienna nominalna (np. kierunek studiów) – moda i procenty;
- precyzja średniej – błąd standardowy albo 95% przedział ufności.
Wzory na miary tendencji centralnej
- \(\bar{x}\)
- średnia arytmetyczna – suma wyników podzielona przez ich liczbę n
- \(Me\)
- mediana – środkowy wynik po uporządkowaniu; przy parzystym n to średnia dwóch środkowych
- \(Mo\)
- moda (dominanta) – wartość, która występuje najczęściej
Wzory na miary rozproszenia i precyzji
- \(R\)
- rozstęp – odległość między największym a najmniejszym wynikiem
- \(s^2\)
- wariancja – przeciętny kwadrat odległości od średniej; dzielimy przez n − 1, bo szacujemy wariancję populacji
- \(s\)
- odchylenie standardowe – typowa odległość wyniku od średniej, w jednostkach danych
- \(SE\)
- błąd standardowy średniej – mówi, jak dokładnie znamy średnią, a nie jak różnią się osoby
- \(Q_1,\ Q_3\)
- kwartyle – poniżej Q1 leży 25% wyników, poniżej Q3 – 75%; IQR obejmuje środkową połowę
- \(t_{0{,}975;\,n-1}\)
- wartość krytyczna rozkładu t do 95% przedziału ufności; przy małych próbach wyraźnie większa niż 1,96
Wzory na miary kształtu rozkładu
- \(G_1\)
- skośność – ujemna przy długim lewym ogonie, dodatnia przy długim prawym
- \(G_2\)
- kurtoza nadwyżkowa – 0 jak w rozkładzie normalnym, dodatnia przy ciężkich ogonach
Stosujemy wersje G1 i G2, czyli te same co SPSS, Excel i SZTOS. Inne programy mogą podawać inne odmiany wzoru, więc zawsze sprawdź, którą liczą.
Przykład: wszystkie miary dla jednego zbioru
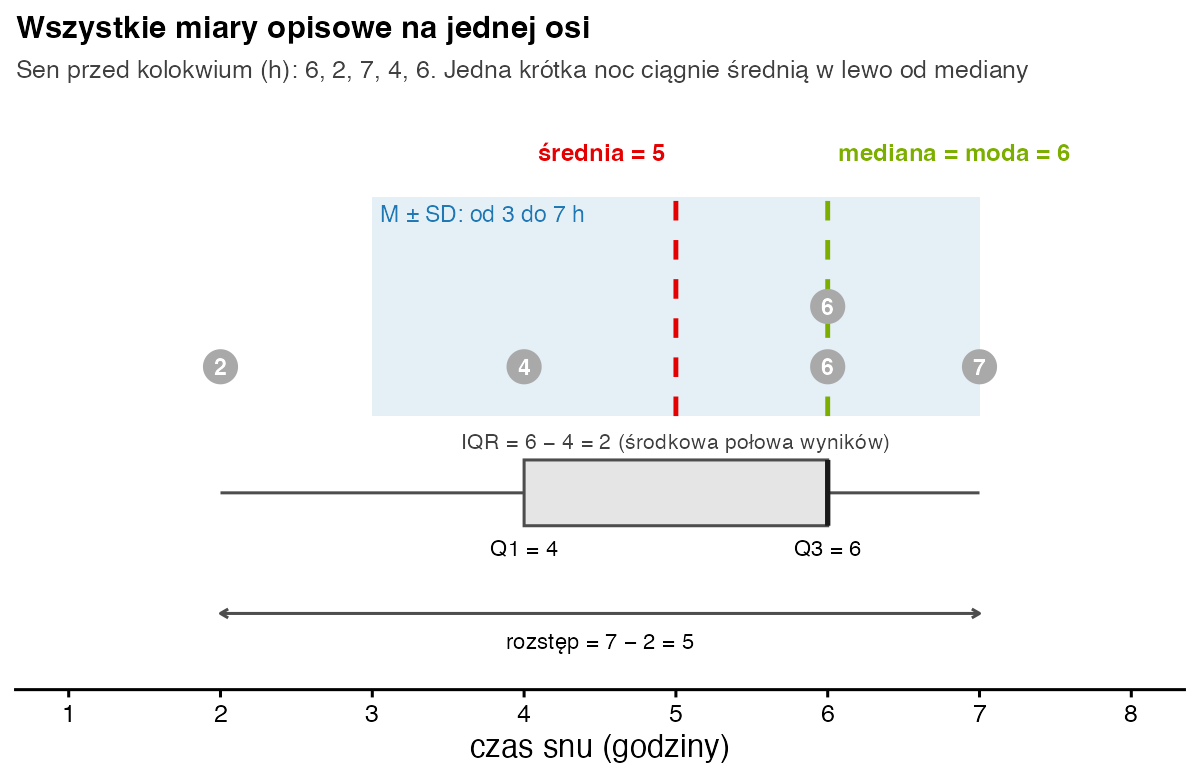
Pięcioro studentów zapisało, ile godzin spało przed kolokwium: 6, 2, 7, 4 i 6. Po uporządkowaniu: 2, 4, 6, 6, 7.
| Miara | Obliczenie | Wynik |
|---|---|---|
| średnia | (6 + 2 + 7 + 4 + 6) / 5 = 25 / 5 | 5 |
| mediana | trzeci z pięciu uporządkowanych wyników | 6 |
| moda | 6 występuje dwa razy | 6 |
| rozstęp | 7 − 2 | 5 |
| wariancja | (1 + 9 + 4 + 1 + 1) / 4 = 16 / 4 | 4 |
| odchylenie standardowe | √4 | 2 |
| błąd standardowy | 2 / √5 | 0,89 |
| kwartyle Q1 i Q3 (R, Excel) | 2. i 4. wynik w szeregu | 4 i 6 (IQR = 2) |
| kwartyle Q1 i Q3 (SPSS) | pozycje 1,5 i 4,5 | 3 i 6,5 |
| tercyle (R, Excel) | kwantyle rzędu 1/3 i 2/3 | 4,67 i 6 |
| 95% przedział ufności | 5 ± 2,776 · 0,894 | [2,52; 7,48] |
| skośność G1 | 5 / (4 · 3) · (−2,25) | −0,94 |
| kurtoza G2 | 1,25 · 6,25 − 8 | −0,19 |
Zwróć uwagę na dwie pułapki. Przedział ufności przy pięciu osobach liczysz z rozkładu t (2,776 dla 4 stopni swobody), a nie z wartością 1,96 – ta wystarcza dopiero przy dużych próbach. Z 1,96 przedział byłby za wąski: [3,25; 6,75]. Kwartyle i tercyle różne programy liczą różnymi metodami, więc zawsze podawaj, której użyłeś. Skośność i kurtozę przy pięciu wynikach traktuj jako ćwiczenie; krok po kroku liczymy je w hasłach szczegółowych.
Jak opisać statystyki opisowe w pracy?
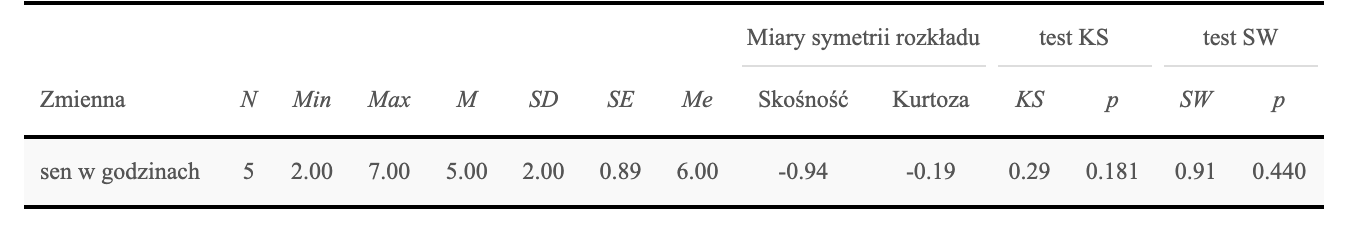
W tabeli podawaj zwykle liczebność, średnią, odchylenie standardowe, medianę oraz minimum i maksimum. Błąd standardowy dodaj tylko wtedy, gdy mówisz o precyzji średniej. Wyniki zaokrąglaj do dwóch miejsc po przecinku i pamiętaj o jednostkach.
Zapis w stylu APA: Studenci spali przed kolokwium średnio 5,00 h (SD = 2,00; Me = 6,00; zakres: 2–7 h), 95% CI [2,52; 7,48].
Jak policzyć wszystkie miary naraz w R?
sen <- c(6, 2, 7, 4, 6)
n <- length(sen)

# 1) „ręcznie”: miary według wzorów
round(c(M = mean(sen), Me = median(sen),
        Mo = as.numeric(names(which.max(table(sen)))),
        R = max(sen) - min(sen), s2 = var(sen), SD = sd(sen),
        SE = sd(sen) / sqrt(n)), 2)
quantile(sen, c(.25, .75))              # kwartyle (typ 7: R, Excel)
quantile(sen, c(.25, .75), type = 6)    # kwartyle jak w SPSS
round(quantile(sen, c(1/3, 2/3)), 2)    # tercyle (typ 7)
round(mean(sen) + c(-1, 1) * qt(.975, n - 1) * sd(sen) / sqrt(n), 2)  # 95% CI

# 2) wszystko naraz; type = 2: skośność G1 i kurtoza G2 jak w SPSS
psych::describe(sen, type = 2)
Wynik w konsoli R:
   M   Me   Mo    R   s2   SD   SE
5.00 6.00 6.00 5.00 4.00 2.00 0.89
25% 75%
  4   6
25% 75%
3.0 6.5
33.33333% 66.66667%
     4.67      6.00
[1] 2.52 7.48
   vars n mean sd median trimmed  mad min max range  skew kurtosis   se
X1    1 5    5  2      6       5 1.48   2   7     5 -0.94    -0.19 0.89
Uwaga: psych::describe() bez argumentu type = 2 liczy inną wersję skośności i kurtozy (tu −0,45 i −1,75).
Średnia czy mediana – co wybrać?
Gdy rozkład jest symetryczny, średnia i mediana są podobne i zwykle podaje się średnią z SD. Gdy rozkład jest skośny albo masz wyniki odstające, mediana lepiej opisuje typowy wynik. W naszym przykładzie jedna krótka noc obniża średnią do 5 h, choć trzy z pięciu osób spały co najmniej 6 h.
Najczęstsze błędy
- Przedział ufności z wartością 1,96 przy małej próbie – potrzebny jest rozkład t.
- Kwartyle i tercyle bez podania metody obliczeń.
- Błąd standardowy w tabeli zamiast odchylenia standardowego.
- Porównywanie skośności i kurtozy z różnych programów bez sprawdzenia wzoru.
- Średnia dla zmiennej nominalnej, np. „średni kierunek studiów” zakodowany cyframi 1–3.
Bibliografia
- Altman, D. G., & Bland, J. M. (2005). Standard deviations and standard errors. BMJ, 331(7521), 903. https://doi.org/10.1136/bmj.331.7521.903
- Hyndman, R. J., & Fan, Y. (1996). Sample quantiles in statistical packages. The American Statistician, 50(4), 361–365. https://doi.org/10.1080/00031305.1996.10473566
- Joanes, D. N., & Gill, C. A. (1998). Comparing measures of sample skewness and kurtosis. Journal of the Royal Statistical Society: Series D (The Statistician), 47(1), 183–189. https://doi.org/10.1111/1467-9884.00122
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówŚrednia arytmetyczna
- Słownik wzorówMediana
- Słownik wzorówOdchylenie standardowe
- Słownik wzorówKwartyle i rozstęp międzykwartylowy
- PoradnikStatystyka opisowa – przykład
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
- Przykładowy raportOpis próby
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.