

Średnia arytmetyczna – wzór, przykład i interpretacja
Średnia arytmetyczna to suma wszystkich wyników podzielona przez ich liczbę – najczęściej używana miara „typowego” wyniku. Typowe pytanie z pracy dyplomowej: ile godzin śpią przeciętnie studenci w noc przed kolokwium?
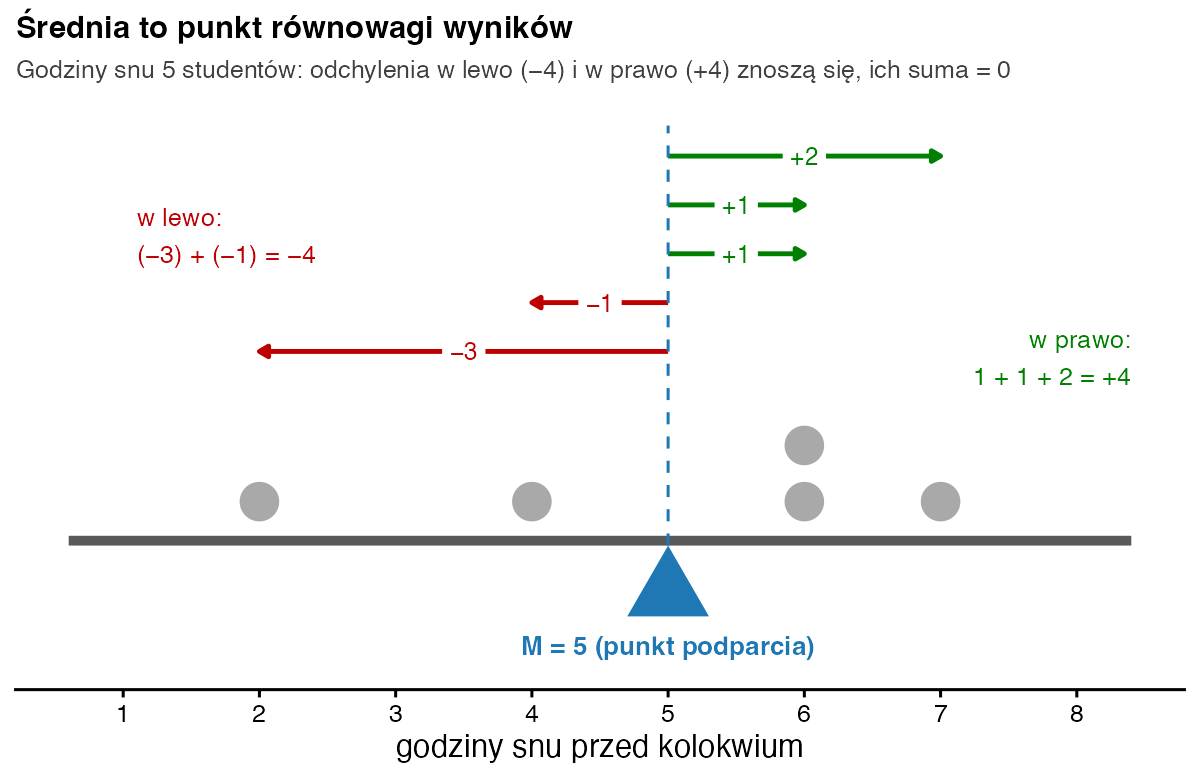
W prostych słowachWyobraź sobie, że wszyscy studenci wrzucają swoje godziny snu do wspólnej puli, a potem dzielą ją po równo. To, co przypada na jedną osobę, to średnia. Średnia działa też jak punkt podparcia huśtawki: wyniki po lewej i po prawej stronie równoważą się. Dlatego jeden bardzo duży wynik potrafi mocno ją przesunąć.
Kiedy stosować średnią arytmetyczną?
- zmienna jest ilościowa: godziny, punkty, wiek, wynik całej skali kwestionariusza;
- rozkład wyników jest w miarę symetryczny i nie ma w nim skrajnych wartości odstających;
- planujesz dalsze analizy oparte na średnich, np. test t albo analizę wariancji.
Średnią prawie zawsze podawaj razem z odchyleniem standardowym. Gdy rozkład jest wyraźnie skośny albo zmienna jest porządkowa, lepszym wyborem będzie mediana. Dla zmiennych nominalnych, takich jak kierunek studiów, średnia nie ma sensu – zostaje moda. Gdy wyniki mają różną wagę (np. oceny i punkty ECTS), policz średnią ważoną.
Wzór na średnią arytmetyczną
- \(\bar{x}\)
- średnia z próby; w pracy w stylu APA oznaczasz ją literą M
- \(x_i\)
- wynik i-tej osoby, np. liczba godzin snu
- \(n\)
- liczba osób, które mają wynik (braki danych nie wchodzą do n)
- \(\sum\)
- znak sumy: dodaj do siebie wszystkie wyniki
- \(\sum (x_i - \bar{x}) = 0\)
- własność średniej: odchylenia w górę i w dół zawsze się znoszą
Przykład krok po kroku
Pięcioro studentów zapisało, ile godzin spało w noc przed kolokwium. Na tych samych danych liczymy w słowniku medianę, odchylenie standardowe i błąd standardowy.
| Student | Godziny snu x | x − 5 |
|---|---|---|
| A | 6 | 1 |
| B | 2 | −3 |
| C | 7 | 2 |
| D | 4 | −1 |
| E | 6 | 1 |
| n = 5 | Σ = 25 | 0 |
- Suma wyników. 6 + 2 + 7 + 4 + 6 = 25 godzin.
- Liczba osób. n = 5.
- Średnia. M = 25 / 5 = 5 godzin.
- Kontrola. Odejmij średnią od każdego wyniku: 1, −3, 2, −1, 1. Suma odchyleń wynosi 0. Jeśli wyjdzie Ci inna liczba, gdzieś jest błąd rachunkowy.
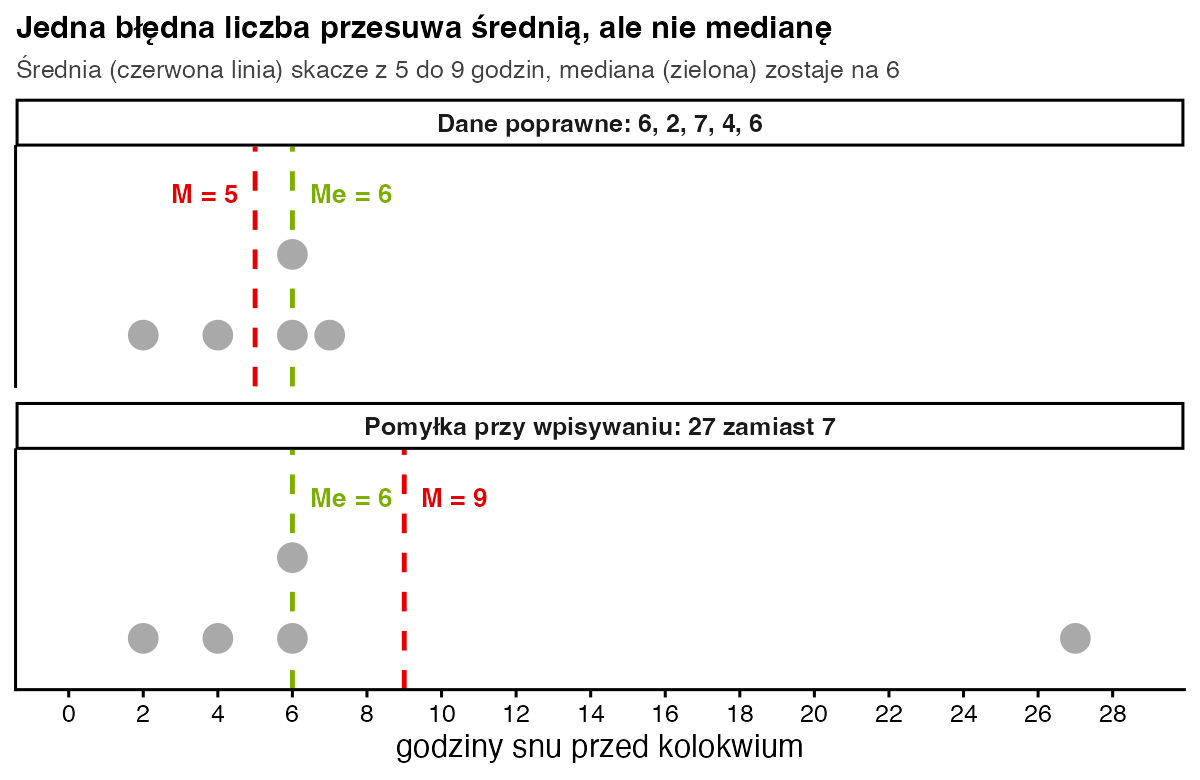
- Test odporności. Załóżmy, że przy wpisywaniu danych ktoś wpisał 27 zamiast 7. Suma rośnie do 45, a średnia do 45 / 5 = 9 godzin. Mediana nadal wynosi 6.
Jak zinterpretować i opisać wynik?
Studenci spali przed kolokwium średnio 5 godzin. Nie znaczy to, że ktokolwiek spał dokładnie 5 godzin. Średnia to wartość „wyrównana”, a nie wynik konkretnej osoby. Dlatego obok niej podaj miarę rozrzutu: odchylenie standardowe wynosi tu 2 godziny. Pamiętaj też, że średnia z pięciu osób jest mało precyzyjna. Jak bardzo, mówi błąd standardowy średniej.
Zapis w stylu APA: W noc przed kolokwium studenci spali średnio 5 godzin (M = 5,00; SD = 2,00; n = 5).
Jak policzyć średnią w R?
sen <- c(6, 2, 7, 4, 6)

# 1) „ręcznie”, dokładnie według wzoru
sum(sen) / length(sen)               # 25 / 5 = 5

# 2) gotową funkcją
mean(sen)
sum(sen - mean(sen))                 # odchylenia od średniej sumują się do 0
summary(sen)                         # średnia obok minimum, kwartyli i mediany

# 3) brak danych: bez na.rm = TRUE wynik to NA
sen_na <- c(6, 2, 7, 4, 6, NA)
mean(sen_na)
mean(sen_na, na.rm = TRUE)

# 4) pomyłka przy wpisywaniu (27 zamiast 7)
sen_blad <- c(6, 2, 27, 4, 6)
c(srednia = mean(sen_blad), mediana = median(sen_blad))
Wynik w konsoli R:
[1] 5
[1] 5
[1] 0
   Min. 1st Qu.  Median    Mean 3rd Qu.    Max.
      2       4       6       5       6       7
[1] NA
[1] 5
srednia mediana
      9       6
Funkcja mean() przy choćby jednym braku danych zwraca NA. To celowe: R nie zgaduje za Ciebie, co zrobić z brakami. Argument na.rm = TRUE liczy średnią z dostępnych wyników.
Średnia czy mediana – co wybrać?
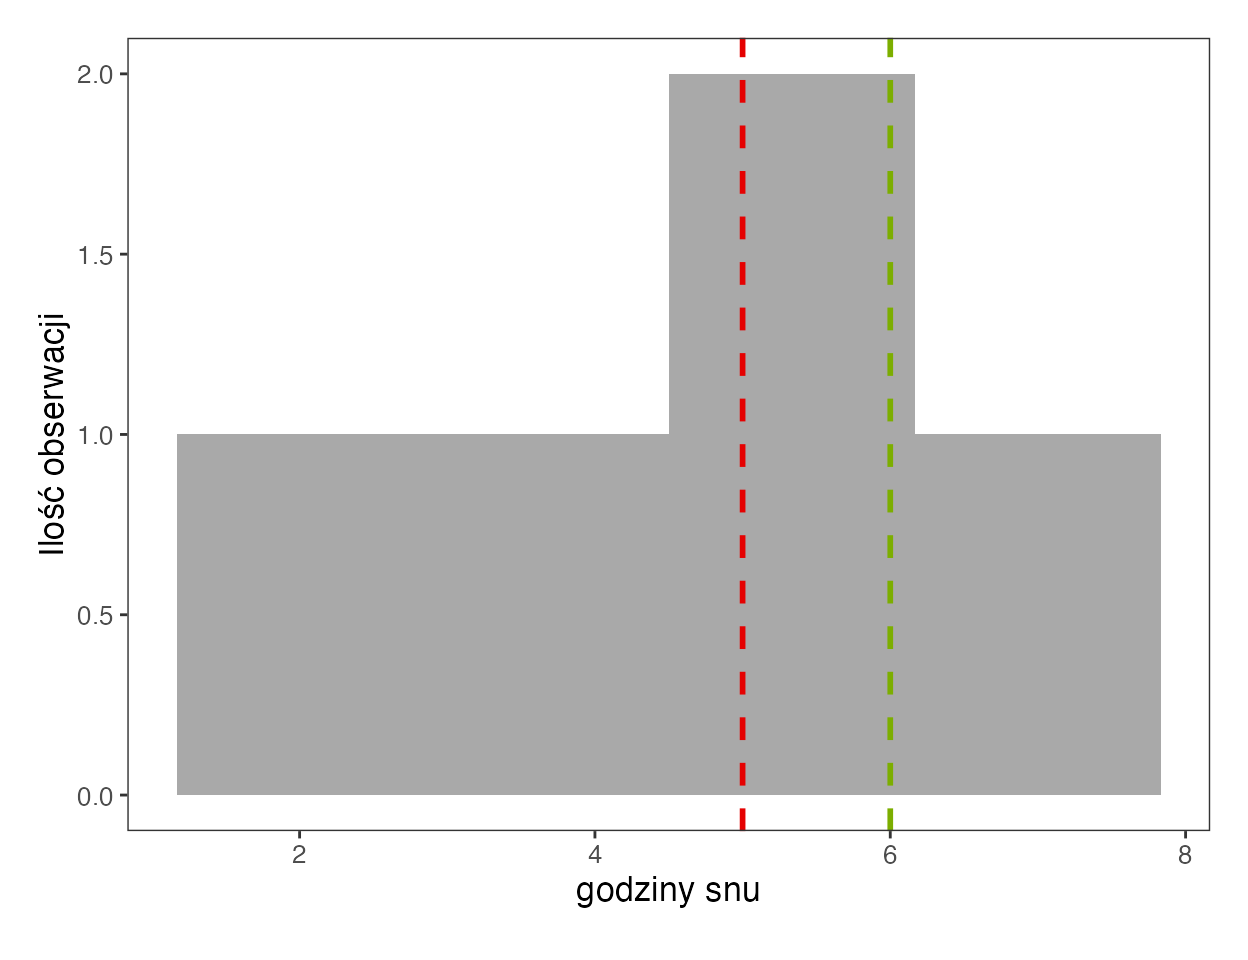
Jeśli rozkład jest mniej więcej symetryczny, średnia i mediana leżą blisko siebie. Wtedy zwykle podaje się średnią, bo korzystają z niej dalsze testy. Gdy rozkład jest skośny (dochody, czas dojazdu, liczba wypitych kaw) albo w danych są wartości odstające, mediana lepiej opisuje typowego studenta. Średnia jest na takie wartości bardzo wrażliwa (Leys i in., 2013). Dobra praktyka: policz obie miary. Jeśli wyraźnie się różnią, obejrzyj histogram, zanim wybierzesz. Pojedyncze pytanie na skali 1–5 daje dane porządkowe, więc raportuj medianę albo rozkład odpowiedzi. Średnią z kilku pytań tworzących skalę liczy się powszechnie.
Najczęstsze błędy
- Liczenie średniej z kodów zmiennej nominalnej, np. „średni kierunek studiów = 2,0”.
- Braki danych zakodowane jako 0 albo 99 i policzone jak zwykłe wyniki. Jedna „99” zawyży średnią bardziej niż pomyłka z Rys. 2.
- Liczenie średniej ze średnich grup o różnej liczebności zamiast średniej ważonej.
- Podawanie średniej bez odchylenia standardowego i bez liczby osób.
- Raportowanie samej średniej przy silnie skośnym rozkładzie, który lepiej opisuje mediana.
Bibliografia
- Manikandan, S. (2011). Measures of central tendency: The mean. Journal of Pharmacology and Pharmacotherapeutics, 2(2), 140–142.
- Leys, C., Ley, C., Klein, O., Bernard, P., & Licata, L. (2013). Detecting outliers: Do not use standard deviation around the mean, use absolute deviation around the median. Journal of Experimental Social Psychology, 49(4), 764–766. https://doi.org/10.1016/j.jesp.2013.03.013
- Field, A., Miles, J., & Field, Z. (2012). Discovering statistics using R. SAGE.
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówMediana
- Słownik wzorówOdchylenie standardowe
- Słownik wzorówŚrednia ważona
- Słownik wzorówBłąd standardowy średniej
- PoradnikStatystyka opisowa – przykład
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
- Przykładowy raportOpis próby
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.