

Omega McDonalda – wzór, interpretacja i przykład
Omega McDonalda (ω) to współczynnik rzetelności skali liczony z ładunków czynnikowych, czyli z tego, jak silnie każde pytanie wiąże się z mierzoną cechą. Typowe pytanie z pracy dyplomowej: czy trzy pytania o stres przed sesją tworzą rzetelną skalę, nawet jeśli nie wszystkie mierzą stres równie dobrze?
W prostych słowachStresu nie widać bezpośrednio, a każde pytanie jest jak okienko, przez które go oglądamy. Jedne okienka są duże (pytanie mocno związane ze stresem), inne małe. Omega sumuje, ile widać przez wszystkie okienka razem, i porównuje to z ilością przypadkowego szumu w odpowiedziach. Im bliżej 1, tym dokładniejszy pomiar.
Kiedy stosować omegę McDonalda?
- skala ma kilka pytań, które sumujesz lub uśredniasz;
- pytania mierzą jedną cechę – sprawdzasz to modelem jednoczynnikowym (konfirmacyjna analiza czynnikowa, CFA);
- pytania mogą mieć różne ładunki – wtedy omega jest trafniejsza niż alfa;
- pytania odwrócone zostały przekodowane.
Gdy wszystkie ładunki są równe, omega i alfa Cronbacha dają identyczny wynik. Omegę często podaje się razem z rzetelnością kompozytową (CR) i przeciętną wyodrębnioną wariancją (AVE) w modelowaniu równań strukturalnych metodą PLS, a odrębność skal sprawdza się dodatkowo wskaźnikiem HTMT.
Wzór na omegę McDonalda
- \(k\)
- liczba pytań w skali
- \(\lambda_i\)
- standaryzowany ładunek czynnikowy i-tego pytania – siła jego związku z mierzoną cechą (od 0 do 1)
- \(\left(\sum \lambda_i\right)^2\)
- kwadrat sumy ładunków – część wariancji wyniku sumarycznego, która pochodzi od mierzonej cechy (nie myl z sumą kwadratów)
- \(\theta_i\)
- wariancja błędu i-tego pytania; przy ładunkach standaryzowanych \(\theta_i = 1 - \lambda_i^2\)
- \(\sum \theta_i\)
- łączny „szum” w wyniku sumarycznym
Przykład krok po kroku
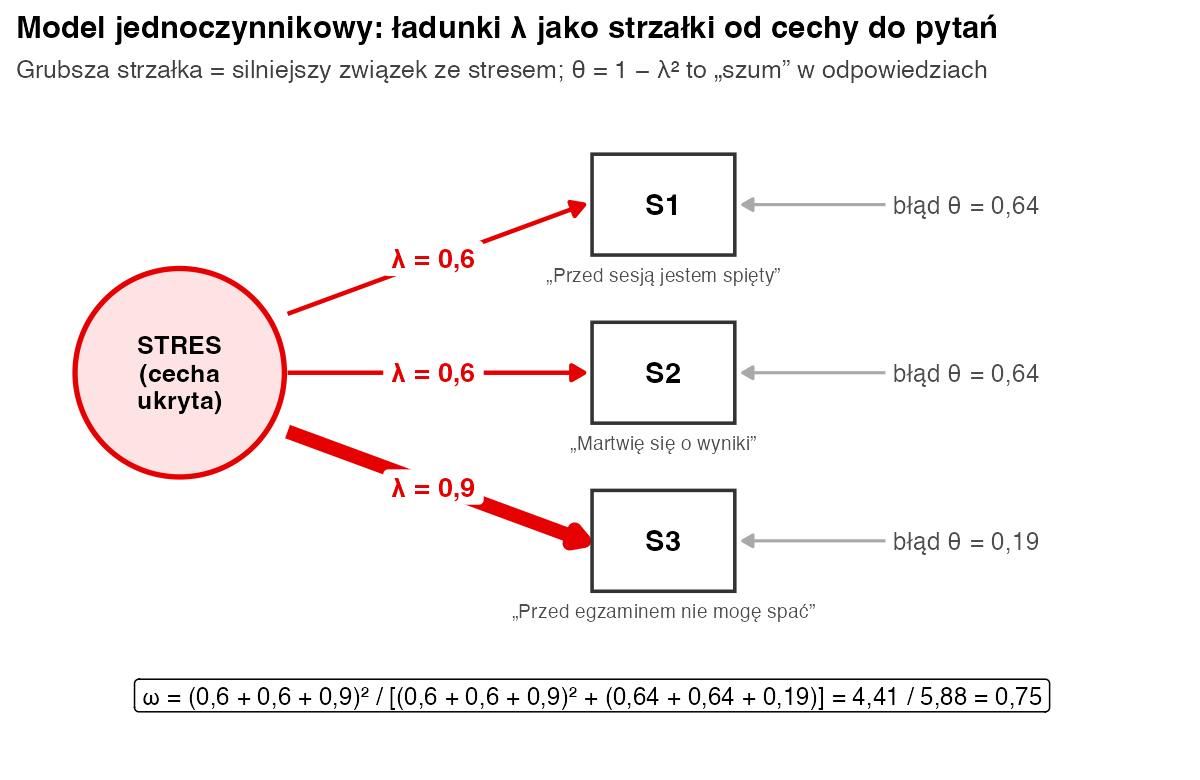
Analiza czynnikowa trzech pytań o stres przed sesją dała standaryzowane ładunki 0,6; 0,6 i 0,9. Trzecie pytanie („Przed egzaminem nie mogę spać”) oddaje stres wyraźnie lepiej niż dwa pierwsze.
| Pytanie | λ | λ² | θ = 1 − λ² |
|---|---|---|---|
| S1 | 0,6 | 0,36 | 0,64 |
| S2 | 0,6 | 0,36 | 0,64 |
| S3 | 0,9 | 0,81 | 0,19 |
| Σ | 2,1 | 1,53 | 1,47 |
- Suma ładunków. 0,6 + 0,6 + 0,9 = 2,1; kwadrat sumy 2,1² = 4,41.
- Wariancje błędów. θ = 1 − λ², np. 1 − 0,36 = 0,64. Razem Σθ = 0,64 + 0,64 + 0,19 = 1,47.
- Omega. ω = 4,41 / (4,41 + 1,47) = 4,41 / 5,88 = 0,75.
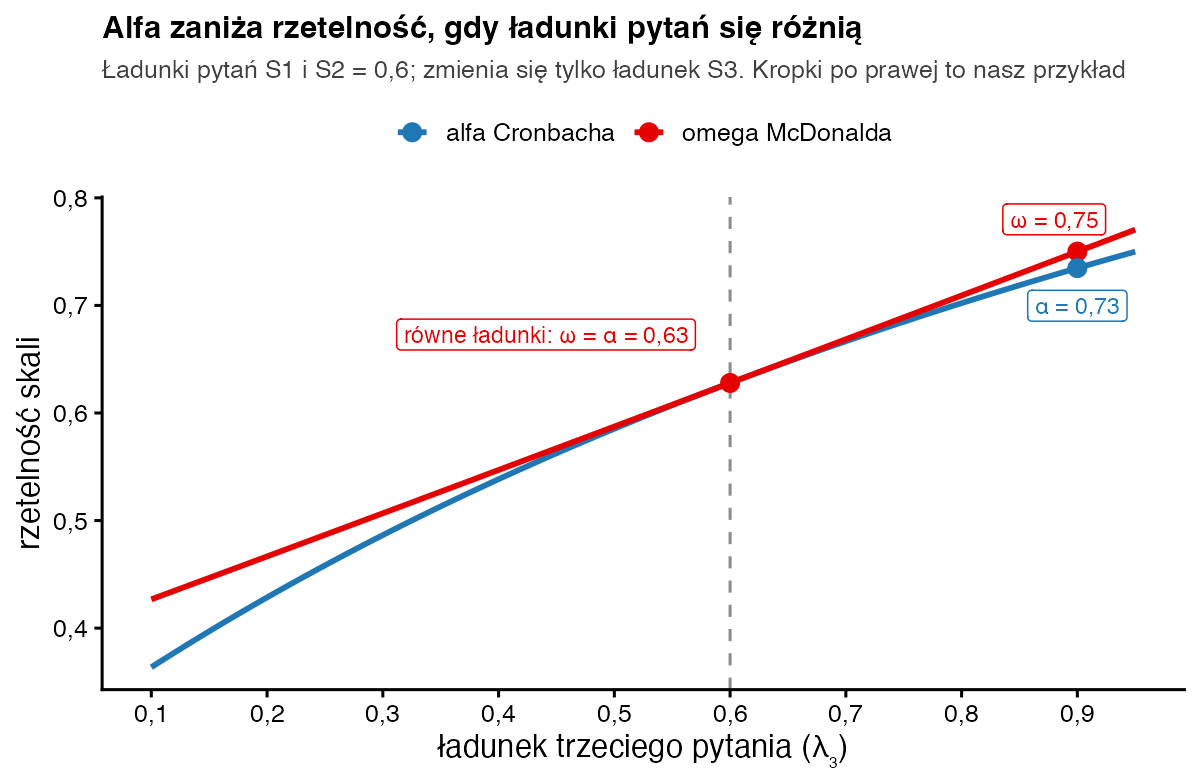
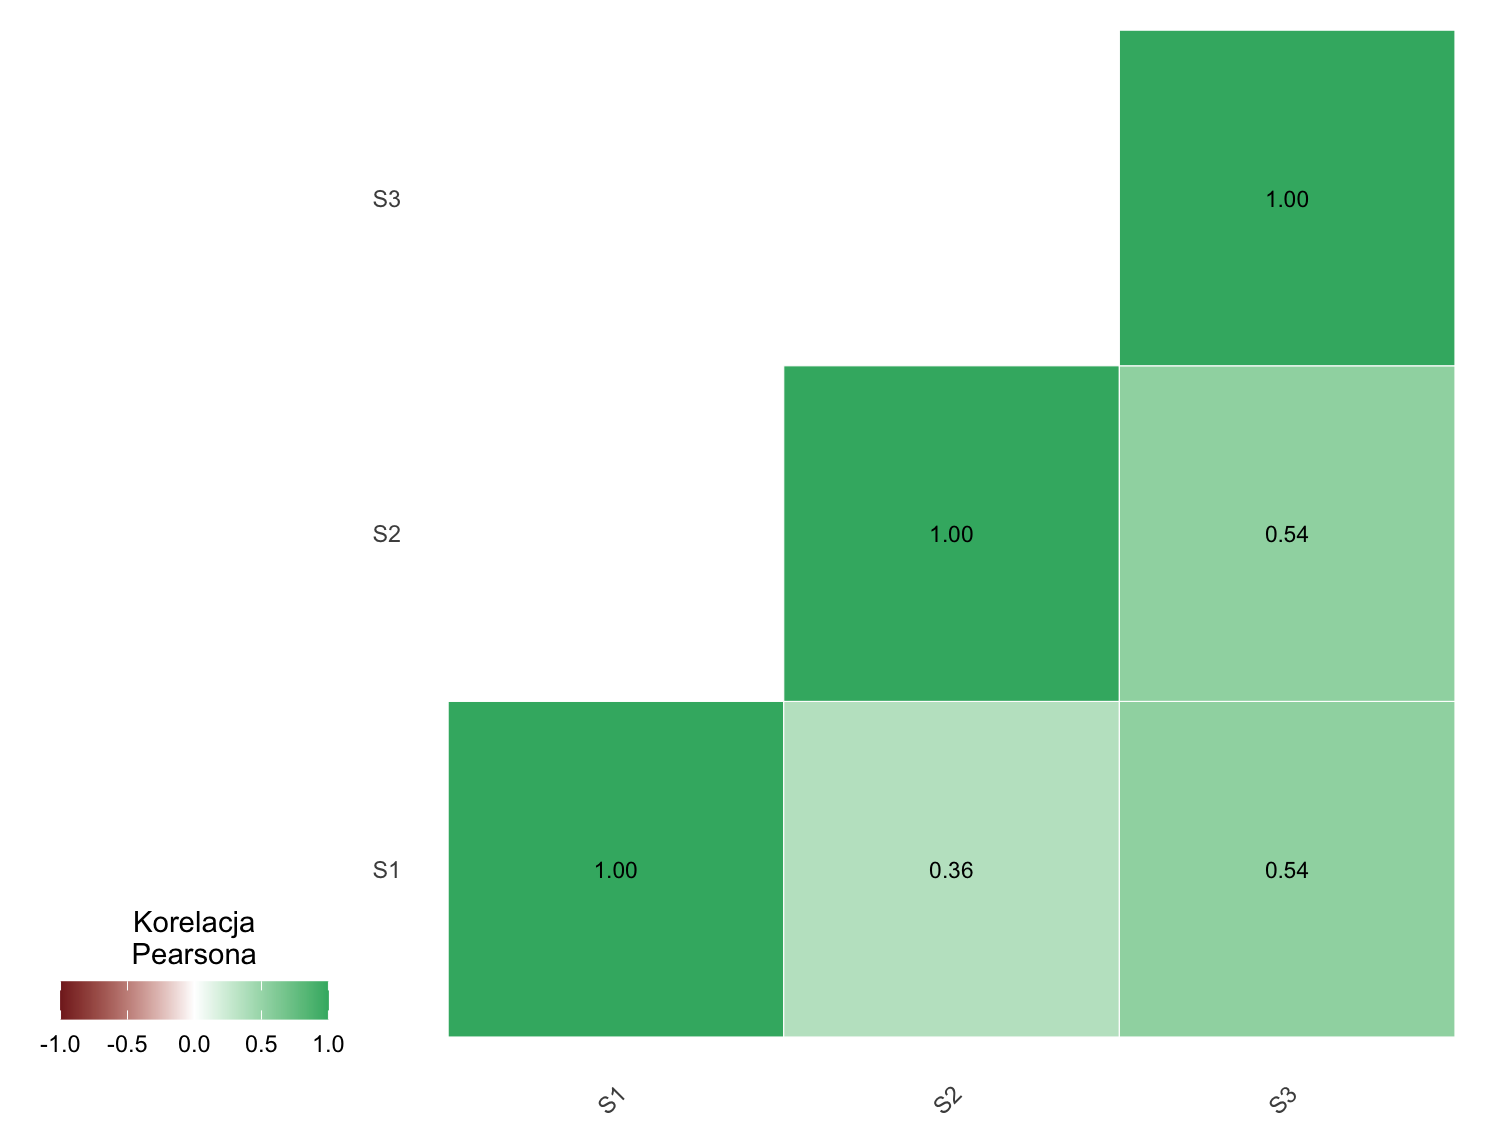
- Porównanie z alfą. W modelu jednoczynnikowym korelacja dwóch pytań to iloczyn ich ładunków: 0,6 · 0,6 = 0,36 oraz 0,6 · 0,9 = 0,54 (dwa razy). Średnia korelacja wynosi 0,48, więc alfa = 3 · 0,48 / (1 + 2 · 0,48) = 0,73 – nieco mniej niż omega, bo ładunki nie są równe.
- AVE (dodatkowo). Średnia kwadratów ładunków: 1,53 / 3 = 0,51 – powyżej umownego progu 0,50 (Fornell i Larcker, 1981).
Jak zinterpretować i opisać wynik?
Omega 0,75 znaczy, że około 75% wariancji wyniku sumarycznego to wariancja wspólnej cechy (stresu), a około 25% – błąd pomiaru. Progi są takie same jak dla alfy i równie umowne: ω ≥ 0,70 wystarcza we wstępnych badaniach, a ω ≥ 0,80 – w badaniach podstawowych (Nunnally i Bernstein, 1994). Omega zakłada, że model jednoczynnikowy dobrze pasuje do danych. Jeśli skala ma kilka wymiarów, policz omegę osobno dla każdego wymiaru.
Zapis w stylu APA: Rzetelność skali stresu przed sesją oszacowano współczynnikiem omega McDonalda na podstawie jednoczynnikowej konfirmacyjnej analizy czynnikowej. Wyniosła ona ω = 0,75 (dla porównania α = 0,73), co według konwencji Nunnally’ego i Bernsteina (1994) oznacza rzetelność akceptowalną.
Jak policzyć omegę McDonalda w R?
L  <- c(0.6, 0.6, 0.9)              # ładunki standaryzowane 3 pytań o stres
th <- 1 - L^2                       # wariancje błędów: 0.64 0.64 0.19

# 1) „ręcznie”, dokładnie według wzoru
sum(L)^2 / (sum(L)^2 + sum(th))     # omega = 4.41 / 5.88 = 0.75
mean(L^2)                           # AVE = 0.51

# 2) model CFA w lavaan + semTools (macierz korelacji odtworzona z ładunków)
R <- tcrossprod(L); diag(R) <- 1
dimnames(R) <- list(c("s1", "s2", "s3"), c("s1", "s2", "s3"))
fit <- lavaan::cfa("stres =~ s1 + s2 + s3", sample.cov = R,
                   sample.nobs = 200, std.lv = TRUE)
lavaan::standardizedSolution(fit)[1:3, c("rhs", "est.std")]
unlist(semTools::compRelSEM(fit))   # omega z modelu

# 3) alfa Cronbacha dla tych samych pytań – dla porównania
round(psych::alpha(R)$total$raw_alpha, 3)
Wynik w konsoli R:
[1] 0.75
[1] 0.51
  rhs est.std
1  s1     0.6
2  s2     0.6
3  s3     0.9
stres
 0.75
[1] 0.735
Funkcja compRelSEM() z pakietu semTools liczy omegę z dopasowanego modelu. Przy prawdziwych danych zamiast macierzy R podaj data = dane. Zwróć uwagę na licznik: (Σλ)² = 4,41, a nie Σλ² = 1,53. Ten drugi zapis to częsty błąd: dałby 1,53 / (1,53 + 1,47) = 0,51, czyli AVE, a nie omegę.
Omega czy alfa Cronbacha – którą podać w pracy?
Jeśli ładunki są podobne, oba współczynniki dadzą niemal ten sam wynik i możesz podać alfę, której oczekuje wielu promotorów. Gdy ładunki wyraźnie się różnią, alfa zaniża rzetelność i lepiej raportować omegę (Dunn i in., 2014; Hayes i Coutts, 2020). Bezpieczny wybór to podanie obu i napisanie, z jakiego modelu pochodzi omega. Pamiętaj, że żaden z nich nie sprawdza, czy skala mierzy jedną cechę – to zadanie dla analizy czynnikowej.
Najczęstsze błędy
- Liczenie Σλ² zamiast (Σλ)² w liczniku – wychodzi wtedy AVE (tu 0,51), a nie omega.
- Podawanie jednej omegi dla skali, która ma kilka wymiarów.
- Pozostawienie pytań odwróconych bez przekodowania – ładunki o różnych znakach psują sumę.
- Brak informacji, z jakiego modelu i programu pochodzą ładunki.
- Pisanie „McDonald’s omega” – po polsku to po prostu omega McDonalda.
Bibliografia
- McDonald, R. P. (1999). Test theory: A unified treatment. Lawrence Erlbaum Associates.
- Dunn, T. J., Baguley, T., & Brunsden, V. (2014). From alpha to omega: A practical solution to the pervasive problem of internal consistency estimation. British Journal of Psychology, 105(3), 399–412. https://doi.org/10.1111/bjop.12046
- Hayes, A. F., & Coutts, J. J. (2020). Use omega rather than Cronbach’s alpha for estimating reliability. But…. Communication Methods and Measures, 14(1), 1–24. https://doi.org/10.1080/19312458.2020.1718629
- Fornell, C., & Larcker, D. F. (1981). Evaluating structural equation models with unobservable variables and measurement error. Journal of Marketing Research, 18(1), 39–50. https://doi.org/10.1177/002224378101800104
- Nunnally, J. C., & Bernstein, I. H. (1994). Psychometric theory (3rd ed.). McGraw-Hill.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówAlfa Cronbacha
- Słownik wzorówHTMT – trafność różnicowa
- Słownik wzorówKorelacja Pearsona
- PoradnikAlfa Cronbacha – przykład
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
- Przykładowy raportPrzykładowy model SZTOS: PLS-SEM
Przygotowujesz artykuł, doktorat lub grant?
Zaplanujemy i wykonamy analizy, przygotujemy raport z tabelami, wykresami i kodem R oraz pomożemy odpowiedzieć na uwagi recenzentów dotyczące statystyki.