

HTMT – wskaźnik trafności różnicowej: wzór i przykład
HTMT (ang. heterotrait-monotrait ratio) sprawdza, czy dwie skale kwestionariusza mierzą naprawdę różne rzeczy. Typowe pytanie z pracy dyplomowej: czy skala stresu przed sesją i skala motywacji do nauki nie są w praktyce jednym i tym samym?
W prostych słowachPytania z tej samej skali powinny być ze sobą silnie powiązane, a pytania z różnych skal – wyraźnie słabiej. HTMT dzieli przeciętną korelację między skalami przez przeciętną korelację wewnątrz skal. Wynik bliski 1 znaczy, że granica między skalami się zaciera. Wynik wyraźnie mniejszy od 1 – że skale są odrębne.
Kiedy stosować HTMT?
- masz co najmniej dwie skale wielopozycyjne, np. w modelu SEM lub PLS-SEM;
- chcesz w rozdziale metodologicznym wykazać trafność różnicową (dyskryminacyjną) skal;
- każda skala ma co najmniej dwie pozycje, a pytania odwrócone są przekodowane.
HTMT uzupełnia ocenę rzetelności, czyli alfę Cronbacha i omegę McDonalda. Najczęściej spotkasz go w modelowaniu równań strukturalnych metodą PLS, gdzie w dużej mierze zastąpił dawne kryterium Fornella-Larckera (Henseler i in., 2015).
Wzór na HTMT
- \(\bar{r}_{AB}\)
- średnia korelacji między każdą pozycją skali A a każdą pozycją skali B (korelacje „heterotrait”)
- \(\bar{r}_{AA},\ \bar{r}_{BB}\)
- średnia korelacji pozycji wewnątrz skali A i wewnątrz skali B (korelacje „monotrait”, bez przekątnej macierzy)
- \(\sqrt{\bar{r}_{AA} \cdot \bar{r}_{BB}}\)
- średnia geometryczna obu średnich wewnątrz skal – nie arytmetyczna
- korelacje
- bierzesz w wartościach bezwzględnych (albo po przekodowaniu pozycji odwróconych)
Przykład krok po kroku
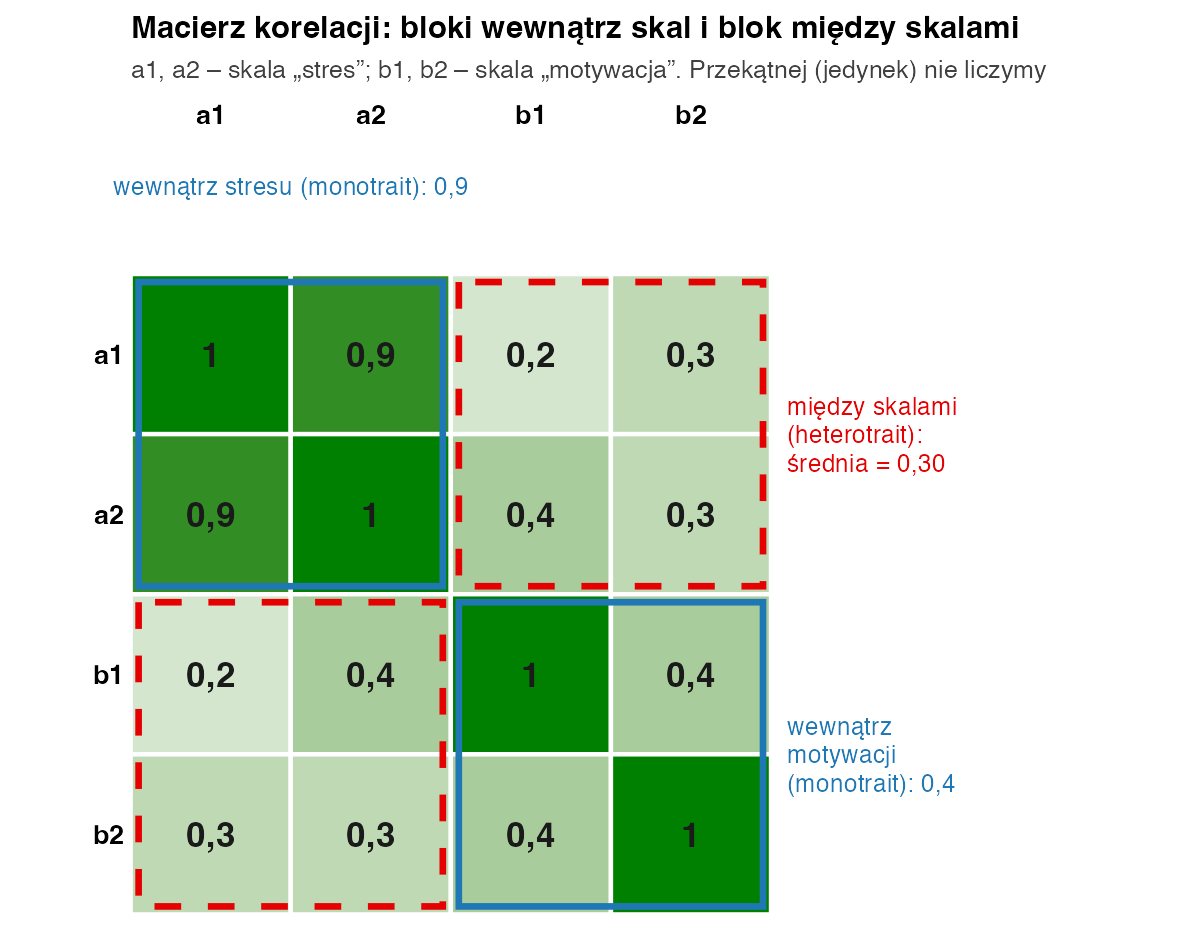
Dwie krótkie skale: stres przed sesją (pozycje a1, a2) i motywacja do nauki (b1, b2). Wypisujemy wszystkie korelacje Pearsona między czterema pozycjami i dzielimy je na dwie grupy.
| Para pozycji | Rodzaj korelacji | r |
|---|---|---|
| a1–a2 | wewnątrz skali „stres” | 0,9 |
| b1–b2 | wewnątrz skali „motywacja” | 0,4 |
| a1–b1 | między skalami | 0,2 |
| a1–b2 | między skalami | 0,3 |
| a2–b1 | między skalami | 0,4 |
| a2–b2 | między skalami | 0,3 |
| Σ między skalami | 4 korelacje | 1,2 |
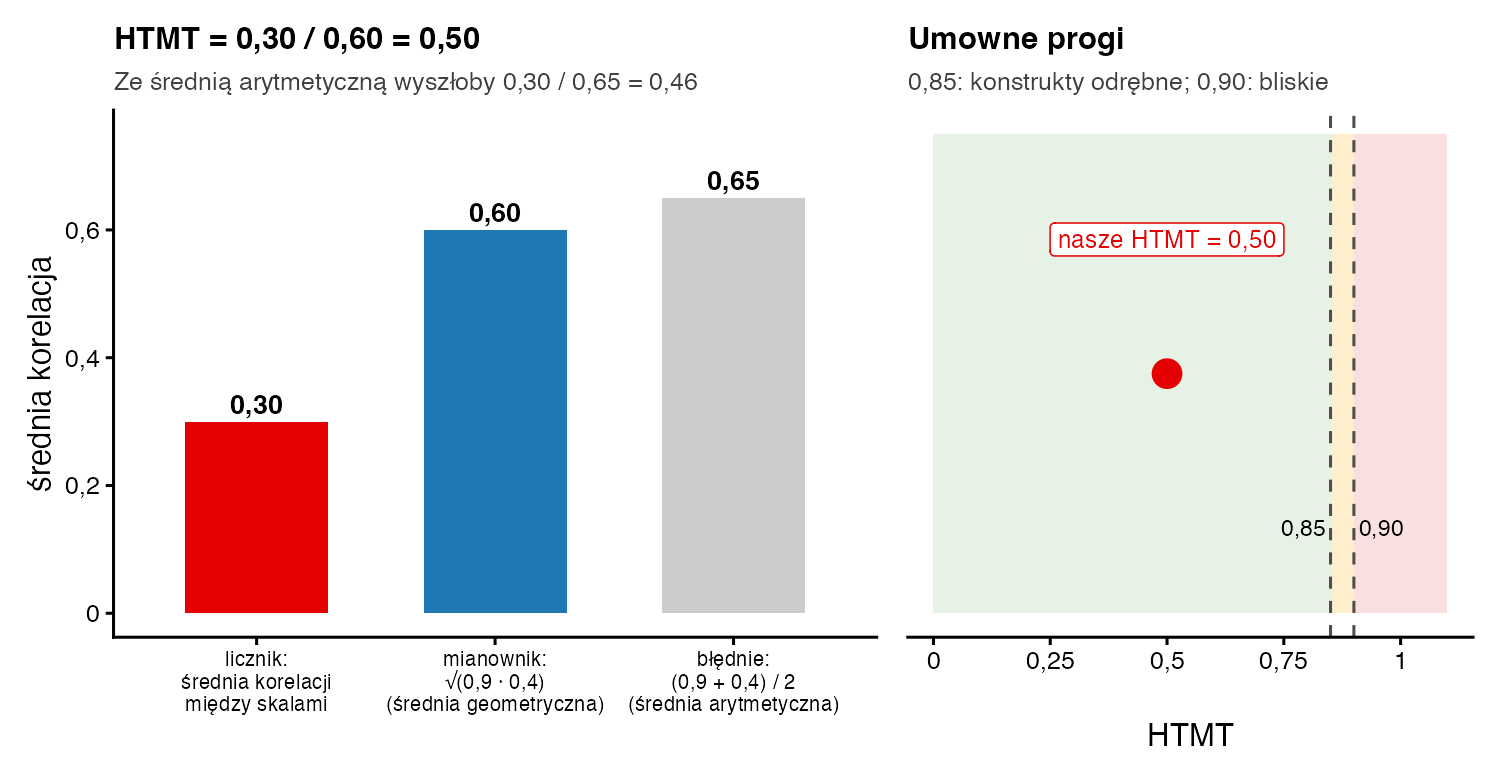
- Średnia między skalami. (0,2 + 0,3 + 0,4 + 0,3) / 4 = 1,2 / 4 = 0,30.
- Średnie wewnątrz skal. Każda skala ma tu jedną parę pozycji: stres 0,9, motywacja 0,4.
- Mianownik. \(\sqrt{0{,}9 \cdot 0{,}4} = \sqrt{0{,}36} = 0{,}60\).
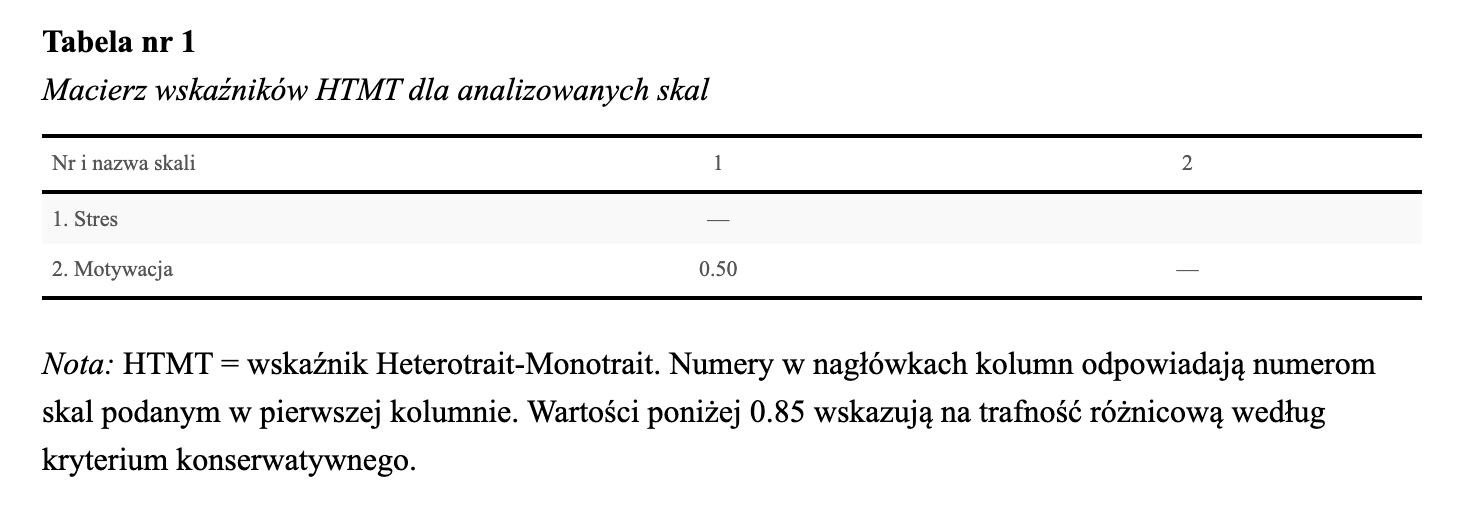
- HTMT. 0,30 / 0,60 = 0,50.
- Pułapka. Średnia arytmetyczna (0,9 + 0,4) / 2 = 0,65 dałaby 0,30 / 0,65 = 0,46 – wynik zaniżony. Różnica rośnie, gdy rzetelność skal jest bardzo różna.
Jak zinterpretować i opisać wynik?
Henseler, Ringle i Sarstedt (2015) proponują dwa umowne progi: HTMT poniżej 0,85 dla konstruktów pojęciowo wyraźnie różnych i poniżej 0,90 dla konstruktów bliskich (np. dwóch aspektów satysfakcji). Można też sprawdzić, czy górna granica bootstrapowego 95% przedziału ufności dla HTMT jest mniejsza od 1 – to jednak najłagodniejsze z tych kryteriów. U nas HTMT = 0,50, co przemawia za odrębnością stresu i motywacji. Przy dwóch pozycjach na skalę średnia wewnątrz skali to pojedyncza korelacja, więc wynik jest mało stabilny.
Zapis w stylu APA: Trafność różnicową skal oceniono wskaźnikiem HTMT (Henseler i in., 2015). Dla pary stres–motywacja HTMT wyniósł 0,50, czyli mniej niż konserwatywny próg 0,85, co wskazuje na odrębność obu konstruktów.
Jak policzyć HTMT w R?
# korelacje pozycji: a1, a2 – skala „stres”; b1, b2 – skala „motywacja”
nazwy <- c("a1", "a2", "b1", "b2")
R <- matrix(c(1.0, 0.9, 0.2, 0.3,
              0.9, 1.0, 0.4, 0.3,
              0.2, 0.4, 1.0, 0.4,
              0.3, 0.3, 0.4, 1.0), nrow = 4, dimnames = list(nazwy, nazwy))

# 1) „ręcznie”, dokładnie według wzoru
miedzy <- mean(R[1:2, 3:4])        # 0.30 – korelacje między skalami
wewn_A <- R["a1", "a2"]            # 0.90 – wewnątrz skali „stres”
wewn_B <- R["b1", "b2"]            # 0.40 – wewnątrz skali „motywacja”
miedzy / sqrt(wewn_A * wewn_B)     # HTMT = 0.30 / 0.60 = 0.50

# 2) gotową funkcją z pakietu semTools (htmt2 = FALSE to oryginalne HTMT)
model <- "stres =~ a1 + a2
          motywacja =~ b1 + b2"
round(unclass(semTools::htmt(model, sample.cov = R, htmt2 = FALSE)), 2)
Wynik w konsoli R:
[1] 0.5
          stres motywacja
stres       1.0       0.5
motywacja   0.5       1.0
Argument htmt2 = FALSE daje oryginalny wskaźnik Henselera i in. (2015). Domyślnie semTools liczy wersję HTMT2 (Roemer i in., 2021), w której średnie korelacji są geometryczne, a nie arytmetyczne – u nas wyszłoby 0,49. Mając surowe odpowiedzi, podaj data = dane zamiast sample.cov.
HTMT czy kryterium Fornella-Larckera?
Kryterium Fornella i Larckera (1981) wymaga, by pierwiastek z przeciętnej wyodrębnionej wariancji (AVE) każdej skali był większy niż jej korelacje z innymi skalami. Symulacje Henselera i in. (2015) pokazały, że w typowych badaniach kryterium to słabo wykrywa brak trafności różnicowej. Dlatego dziś raportuje się przede wszystkim HTMT, a kryterium Fornella-Larckera – co najwyżej dodatkowo.
Najczęstsze błędy
- Średnia arytmetyczna zamiast geometrycznej w mianowniku.
- Liczenie HTMT bez przekodowania pozycji odwróconych albo z ujemnymi korelacjami zamiast ich wartości bezwzględnych.
- Wliczanie przekątnej macierzy (jedynek) do średnich wewnątrz skal.
- Podanie wyniku bez informacji, który próg (0,85 czy 0,90) przyjęto i dlaczego.
- Liczenie HTMT dla skali z jedną pozycją – brak wtedy korelacji wewnątrz skali.
Bibliografia
- Henseler, J., Ringle, C. M., & Sarstedt, M. (2015). A new criterion for assessing discriminant validity in variance-based structural equation modeling. Journal of the Academy of Marketing Science, 43(1), 115–135. https://doi.org/10.1007/s11747-014-0403-8
- Roemer, E., Schuberth, F., & Henseler, J. (2021). HTMT2–an improved criterion for assessing discriminant validity in structural equation modeling. Industrial Management & Data Systems, 121(12), 2637–2650. https://doi.org/10.1108/IMDS-02-2021-0082
- Fornell, C., & Larcker, D. F. (1981). Evaluating structural equation models with unobservable variables and measurement error. Journal of Marketing Research, 18(1), 39–50. https://doi.org/10.1177/002224378101800104
- Hair, J. F., Hult, G. T. M., Ringle, C. M., & Sarstedt, M. (2022). A primer on partial least squares structural equation modeling (PLS-SEM) (3rd ed.). SAGE.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówOmega McDonalda
- Słownik wzorówAlfa Cronbacha
- Słownik wzorówKorelacja Pearsona
- PoradnikModelowanie PLS-SEM
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
- Przykładowy raportPrzykładowy model SZTOS: PLS-SEM
Przygotowujesz artykuł, doktorat lub grant?
Zaplanujemy i wykonamy analizy, przygotujemy raport z tabelami, wykresami i kodem R oraz pomożemy odpowiedzieć na uwagi recenzentów dotyczące statystyki.